
tachyon of zybo cluster
把Tachyon层加入spark和hadoop之间,以加速集群
官网:http://tachyon-project.org/
github:https://github.com/amplab/tachyon/releases
(1)准备工作:
wget http://tachyon-project.org/downloads/tachyon-0.4.1-bin.tar.gz
tar xvfz tachyon-0.4.1-bin.tar.gz
cd tachyon-0.4.1
cp conf/tachyon-env.sh.template conf/tachyon-env.sh
(2)在本地测试:
vi conf/tachyon-env.sh
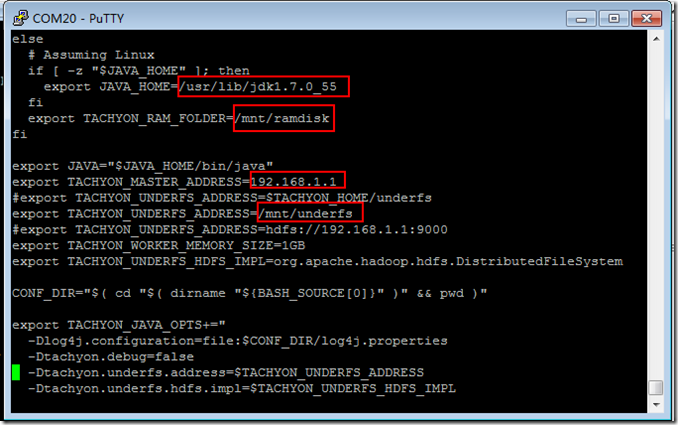
./bin/tachyon format
./bin/tachyon-start.sh local
./bin/tachyon runTest Basic CACHE_THROUGH
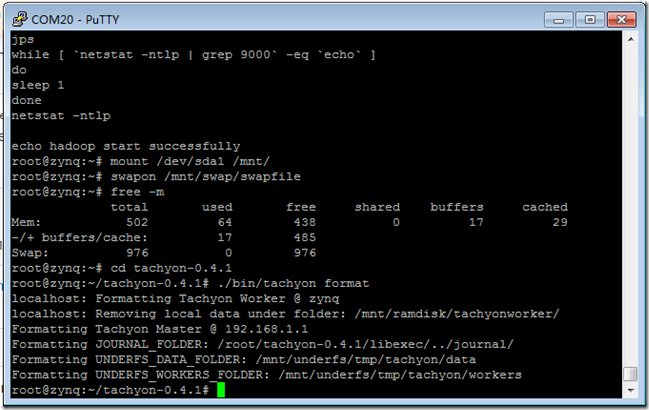
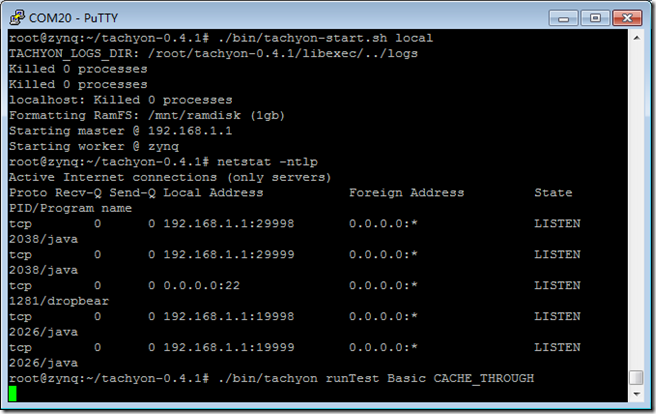
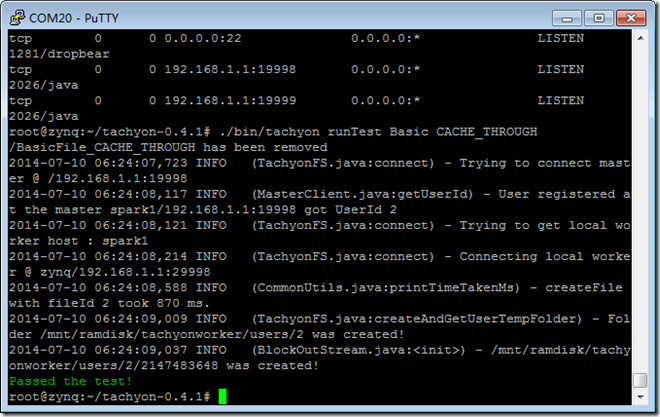
(3)与Hadoop结合:Set HDFS as Tachyon’s under filesystem
因为2.4.0的hadoop需要重新编译,在arm平台安装maven会出错,故转移到x64pc机编译:
apt-get install maven
vi pom.xml
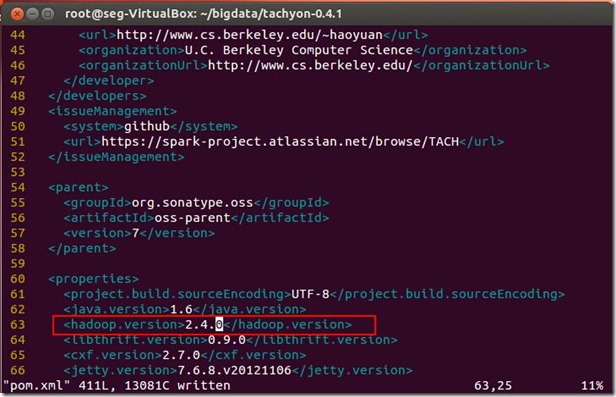
mvn -Dhadoop.version=2.4.0 clean package
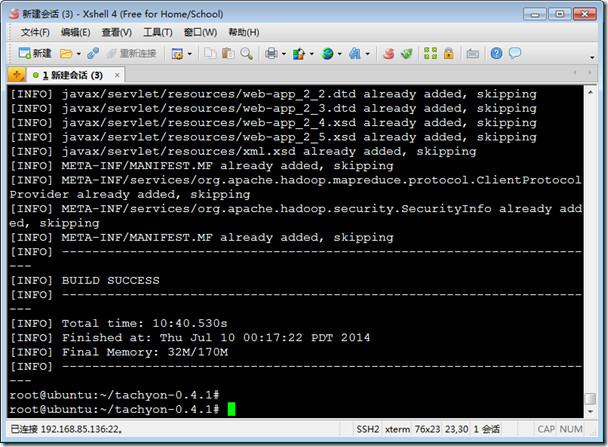
cp -r /root/tachyon-0.4.1 /media/fs/root/
cd /root/tachyon-0.4.1
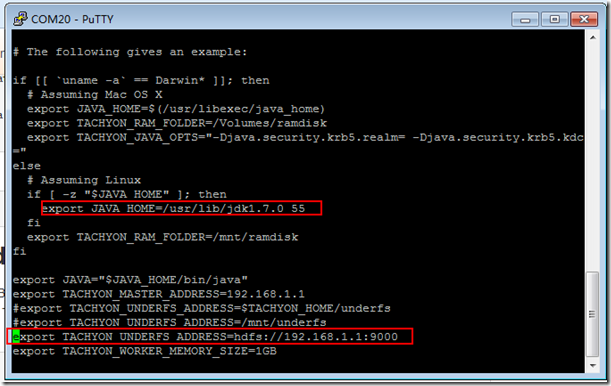
cd ..
cd hadoop-2.4.0/
vi etc/hadoop/core-site.xml
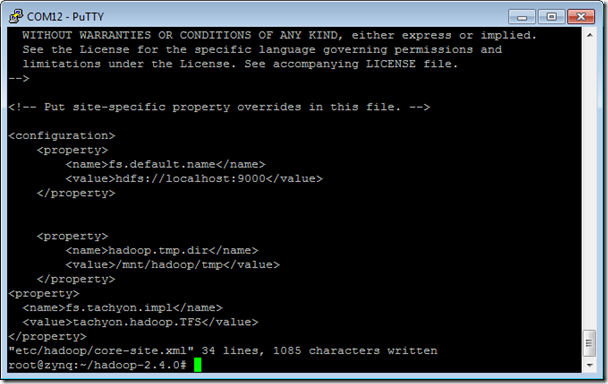
<property>

  <name>fs.tachyon.impl</name>

  <value>tachyon.hadoop.TFS</value>

</property>
vi etc/hadoop/hadoop-env.sh
加入一行:
export HADOOP_CLASSPATH=$HADOOP_CLASSPATH:/root/tachyon-0.4.1/target/tachyon-0.4
.1-jar-with-dependencies.jar
cd /root
./gohadoop.sh
cd tachyon-0.4.1
./bin/tachyon format
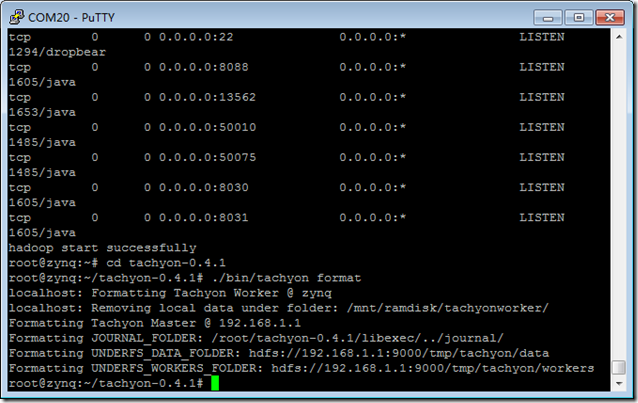
./bin/tachyon-start.sh local
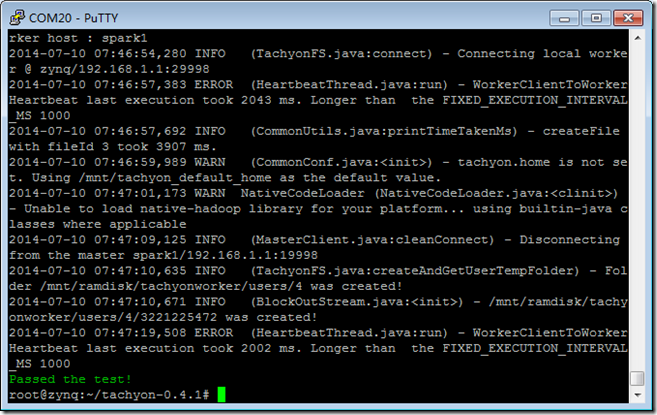
./bin/tachyon runTest Basic CACHE_THROUGH
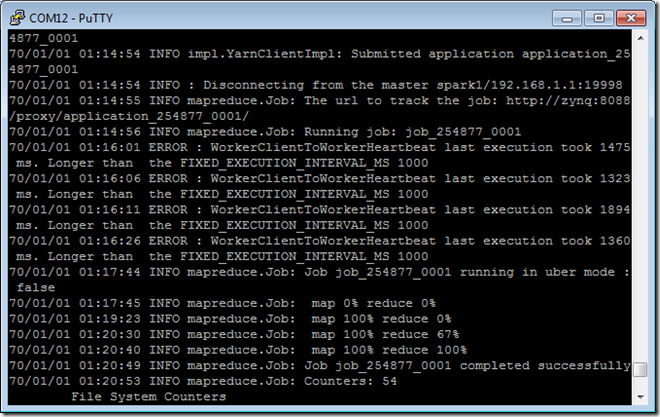
cd $HADOOP_HOME执行如下命令:./bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.4.0.jar \
wordcount -libjars /root/tachyon-0.4.1/target/tachyon-0.4.1-jar-with-dependencies.jar \
tachyon://192.168.1.1:19998/in/file /out/file
(4)与Spark结合:Running Spark on Tachyon
cd spark-0.9.1-bin-hadoop2
vi conf/spark-env.sh
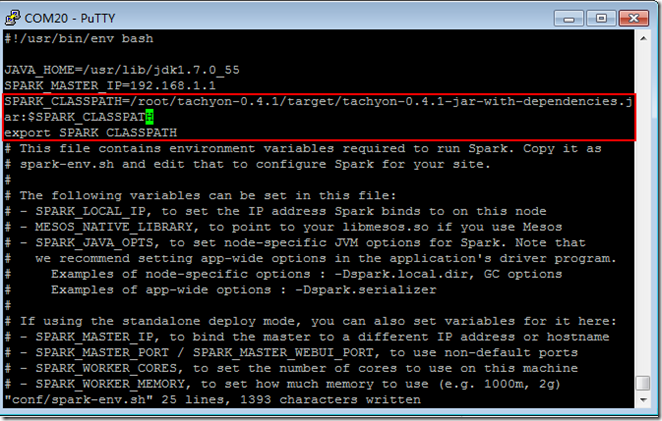
SPARK_CLASSPATH=/root/tachyon-0.4.1/target/tachyon-0.4.1-jar-with-dependencies.jar:$SPARK_CLASSPATH
export SPARK_CLASSPATH
export TACHYON_MASTER="192.168.1.1:19998"
新建一个配置文件:
vi conf/core-site.xml
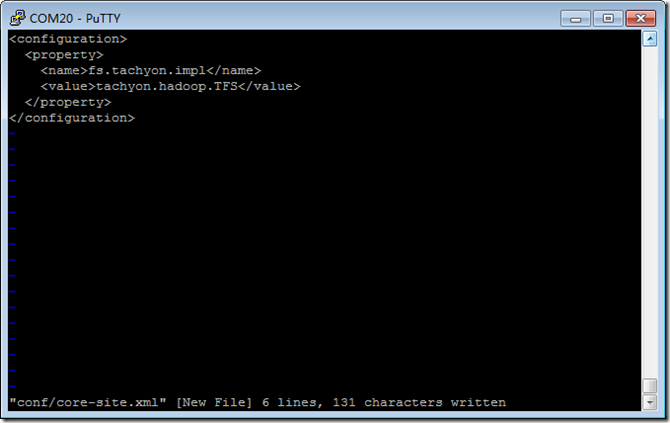
<configuration>

  <property>

    <name>fs.tachyon.impl</name>

    <value>tachyon.hadoop.TFS</value>

  </property>

</configuration>
运行
MASTER=spark://192.168.1.1:7077 ./bin/pyspark
file = sc.textFile("tachyon://192.168.1.1:19998/in/file")
counts = file.flatMap(lambda line: line.split(" ")) \
.map(lambda word: (word, 1)) \
.reduceByKey(lambda a, b: a + b)
counts.collect()
counts.saveAsTextFile("tachyon://192.168.1.1:19998/out/mycount")
counts.saveAsTextFile("hdfs://192.168.1.1:9000/out/mycount1")
collect()正确执行,
save to hadoop 正确执行,
save to tachyon 后出错:
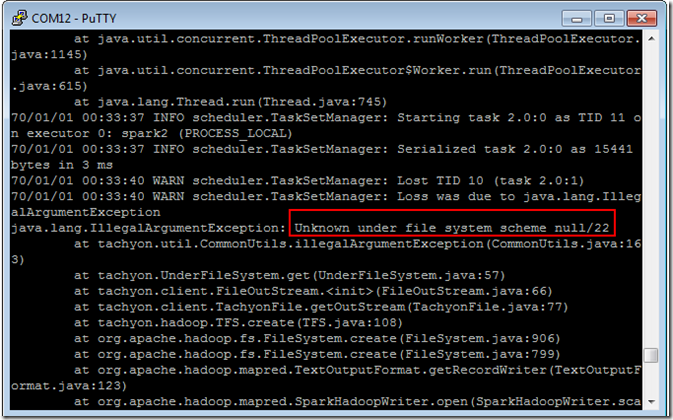
参考网站:http://tachyon-project.org/Syncing-the-Underlying-Filesystem.html
暂未解决。
先只测试用Tachyon读数据1G大小的文本文件:
使用hadoop读取使用了16分钟。
scp tachyon-0.4.1.bak2.tar.gz root@spark4:/root/
tachyon of zybo cluster的更多相关文章
- hadoop+tachyon+spark的zybo cluster集群综合配置
1.zybo cluster 架构简述: 1.1 zybo cluster 包含5块zybo 开发板组成一个集群,zybo的boot文件为digilent zybo reference design提 ...
- Learn ZYNQ(10) – zybo cluster word count
1.配置环境说明 spark:5台zybo板,192.168.1.1master,其它4台为slave hadoop:192.168.1.1(外接SanDisk ) 2.单节点hadoop测试: 如果 ...
- Learn ZYNQ (9)
创建zybo cluster的spark集群(计算层面): 1.每个节点都是同样的filesystem,mac地址冲突,故: vi ./etc/profile export PATH=/usr/loc ...
- Tachyon Cluster: 基于Zookeeper的Master High Availability(HA)高可用配置实现
1.Tachyon简介 Tachyon是一个高容错的分布式文件系统,允许文件以内存的速度在集群框架中进行可靠的共享,就像Spark和 MapReduce那样.通过利用信息继承,内存侵入,Tachyon ...
- Tachyon在Spark中的作用(Tachyon: Reliable, Memory Speed Storage for Cluster Computing Frameworks 论文阅读翻译)
摘要: Tachyon是一种分布式文件系统,能够借助集群计算框架使得数据以内存的速度进行共享.当今的缓存技术优化了read过程,可是,write过程由于须要容错机制,就须要通过网络或者 ...
- 分布式内存文件系统Tachyon
UCBerkeley研发的Tachyon(超光子['tækiːˌɒn],名字要不要这么太嚣张啊:)是一款为各种集群并发计算框架提供内存数据管理的平台,也可以说是一种内存式的文件系统吧.如下图,它就处于 ...
- Spark(十二) -- Spark On Yarn & Spark as a Service & Spark On Tachyon
Spark On Yarn: 从0.6.0版本其,就可以在在Yarn上运行Spark 通过Yarn进行统一的资源管理和调度 进而可以实现不止Spark,多种处理框架并存工作的场景 部署Spark On ...
- [Berkeley]弹性分布式数据集RDD的介绍(RDD: A Fault-Tolerant Abstraction for In-Memory Cluster Computing 论文翻译)
摘要: 本文提出了分布式内存抽象的概念--弹性分布式数据集(RDD,Resilient Distributed Datasets).它同意开发者在大型集群上运行基于内存的计算.RDD适用于两种 ...
- Node.js:进程、子进程与cluster多核处理模块
1.process对象 process对象就是处理与进程相关信息的全局对象,不需要require引用,且是EventEmitter的实例. 获取进程信息 process对象提供了很多的API来获取当前 ...
随机推荐
- 微信电脑版-微信for windows客户端发布
12月份微信Windows版客户端1.0 Alpha推出,昨天微信for windows 1.0客户端(测试版)发布更新,超过三亿人使用的聊天应用,现在登录Windows桌面.你可以在Windows上 ...
- 微信服务号模板消息接口新增"设置行业"和"添加模板"及细节优化
微信服务号模板消息可以向用户发送重要的服务通知,如信用卡刷卡通知,商品购买成功通知等.昨日,微信团队发布公告称模板消息新增“设置行业”和“添加模板”接口及细节优化,详细变动如下 模板消息[业务通知]自 ...
- JBOSS 5 session时间配置
C:\jboss-5.1.0.GA\server\default\deployers\jbossweb.deployer web.xml <session-config> < ...
- Jenkins的使用
参考: http://www.cnblogs.com/sunzhenchao/archive/2013/01/30/2883289.html
- 使用python列表推导式进行99乘法表
首先这很python for i in range(1, 10): print(" ".join(["%d*%d=%d" % (j, i, i*j) for j ...
- 【krpano】浏览点赞插件(源码+介绍+预览)
简介 最近几天研究了如何在krpano全景的基础上实现记录浏览量和点赞次数,写了一个插件,方便大家使用. 效果截图如下: 每当有用户打开该全景页面时,浏览量会自动加1: 用户可以主动点击点赞按钮,点击 ...
- ffmpeg-20160828-bin.7z
ESC 退出 0 进度条开关 1 屏幕原始大小 2 屏幕1/2大小 3 屏幕1/3大小 4 屏幕1/4大小 5 屏幕横向放大 20 像素 6 屏幕横向缩小 20 像素 S 下一帧 [ -2秒 ] +2 ...
- Java内部类详解
Java内部类详解 说起内部类这个词,想必很多人都不陌生,但是又会觉得不熟悉.原因是平时编写代码时可能用到的场景不多,用得最多的是在有事件监听的情况下,并且即使用到也很少去总结内部类的用法.今天我们就 ...
- sys/types.h fcntl.h unistd.h sys/stat.h
sys/types.h 是Unix/Linux系统的基本系统数据类型的头文件,含有size_t,time_t,pid_t等类型. 在应用程序源文件中包含 <sys/types.h> 以访问 ...
- python中如何避免中文是乱码
这个问题是一个具有很强操作性的问题.我这里有一个经验总结,分享一下,供参考:首先,提倡使用utf-8编码方案,因为它跨平台不错.经验一:在开头声明: # -*- coding: utf-8 -*- 有 ...