
scrapy爬虫登录edusrc查看漏洞列表
scrapy登录界面的难点在于登录时候的验证码,我们通过使用scrapy.FormRequest向目标网站提交数据(表单提交),同时将验证码显示在本地,手动输入,进而登录。

验证码是类似于这种的,才可以通过此方式登录,如网站是通过滑块验证登录的话,此方法就不再适用
因为要找到这种验证码登录的网站一时之间没找到,本想用学校教务系统的登录网站进行测试,但是测试后发现验证码是动态加载的,故放弃,找了一会,就用提交教育漏洞的edusrc网站作为练习登录爬虫的站点
登录url是:https://src.sjtu.edu.cn/login/
我们先登录一下,查看需要post哪些数据
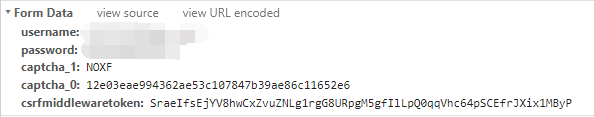
可以看到,这里POST表单里面我们提交了username,password,captcha_1,captcha_0以及csrfmiddlewaretoken
username和password是我们的登录邮箱和密码,captcha_1是输入的验证码,captcha_0我猜测是每次登录的时候都会根据网站算法而更新的一个值,csrfmiddlewaretoken也是一个根据算法更新的值,从名字可以看出是防止csrf攻击而生成的令牌值,告诉网站来到这个页面的用户的权限。
而提交的数据中,captcha_0和csrfmiddlewaretoken都是直接从页面中获取的,我们先用xpath从页面中获取这两个值


使用xpath语法对这两个值进行提取:
formdata={

            'username': '',

            'password': ''

        }

captcha_0=response.xpath('//input[@name="captcha_0"]/@value').get()

formdata['captcha_0']=captcha_0

csrfmiddlewaretoken=response.xpath('//input[@name="csrfmiddlewaretoken"]/@value').get()

formdata['csrfmiddlewaretoken']=csrfmiddlewaretoken
其中username和password需要自己输入,这个时候就只剩下captcha_1即验证码没有获取了
查看源代码 之后可知:

验证码存在一个url,这个url里面的验证码每次刷新之后都会改变,但是url也在不断变化,使用xpath提取这个url,然后我们进一步进行处理
captcha_url = response.xpath('//img/@src').get()

captcha_url = 'https://src.sjtu.edu.cn/' + captcha_url

print captcha_url

captcha = self.check_captcha(captcha_url)
check_captcha函数就是我们用来处理captcha_url即验证码url的
    def check_captcha(self,image_url):

        urllib.urlretrieve(image_url,'captcha.jpg')

        image=Image.open('captcha.jpg')

        image.show()

        captcha=raw_input('please input captcha:')

        return captcha
我们使用了urlretrieve函数来下载远程url的数据,这里就是将验证码图片下载在了本地我们查看
python2和python3都可以使用urlretrieve函数,使用方法略有不同,我使用的是python2,参考这篇博客修改的:
https://blog.csdn.net/drdairen/article/details/61934598?depth_1-utm_source=distribute.pc_relevant.none-task&utm_source=distribute.pc_relevant.none-task
获取到的验证码图片会保存在当前文件夹下,接着我们使用Image打开该图片同时show,看到验证码图片的我们关闭图片后输入验证码字符串并返回该字符串
formdata['captcha_1'] = captcha

yield scrapy.FormRequest(url=self.login_url,formdata=formdata,callback=self.parse_after_login)
将captcha_1加入到formdata之后,我们向login_url提交formdata,同时为了检测我们是否成功登录,回调函数是parse_after_login
def parse_after_login(self,response):

        if response.url=="https://src.sjtu.edu.cn/":
yield scrapy.FormRequest(self.bug_url,callback=self.parse_bug)
        print "login successful!"
     else:
        print "login failed!"
自己尝试登录之后,可以知道登录了之后网站会自动将我们302重定向到https://src.sjtu.edu.cn/,所以我们只需要检测response.url是否跟https://src.sjtu.edu.cn/相同即可
我们登录了之后去bugurl即https://src.sjtu.edu.cn/list/?page=1页面第一页提取bug_list信息打印出来,证明可以做到登录之后的操作即可,因为为了避免信息泄露,漏洞列表里登录后和没登录看到的漏洞信息是不一样的,侧面可以反映我们是否登录成功
    def parse_bug(self,response):

        print response.url

        if response.url==self.bug_url:

            print "join bug_list successful!"

            bug_list=response.xpath('//td/a[contains(@href,"/post/")]/text()').getall()

            for bug in bug_list:

                print bug

        else:

            print "join bug_list failed!"
现在主要的部分就写好了,填入username和password运行试试
运行之后跳出验证码图片

输入验证码之后输出第一页的漏洞列表:
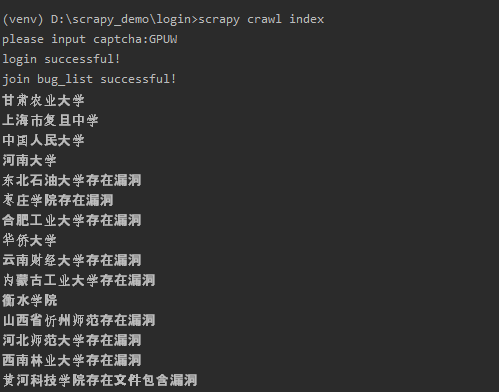
可以看到跟登录之后的漏洞信息显示相同
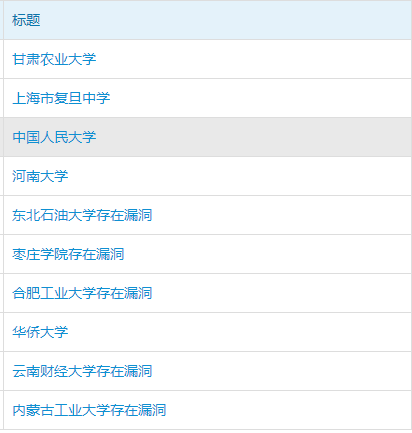
如果没登录的话,显示的信息是这样的:

其实我感觉没登录的时候看到的信息要多一些:)
可以看出我们登录成功了。
这个代码主要是识别验证码和POST提交formdata数据比较重要
代码放在github上面了:
https://github.com/Cl0udG0d/scrapy_demo
参考链接:
https://blog.csdn.net/drdairen/article/details/61934598?depth_1-utm_source=distribute.pc_relevant.none-task&utm_source=distribute.pc_relevant.none-task
http://binxiaoer.top/blog/detail/88
scrapy爬虫登录edusrc查看漏洞列表的更多相关文章
- scrapy爬虫系列之四--爬取列表和详情
功能点:如何爬取列表页,并根据列表页获取详情页信息? 爬取网站:东莞阳光政务网 完整代码:https://files.cnblogs.com/files/bookwed/yangguang.zip 主 ...
- python爬虫之scrapy模拟登录
背景: 初来乍到的pythoner,刚开始的时候觉得所有的网站无非就是分析HTML.json数据,但是忽略了很多的一个问题,有很多的网站为了反爬虫,除了需要高可用代理IP地址池外,还需要登录.例如知乎 ...
- python爬虫scrapy之登录知乎
下面我们看看用scrapy模拟登录的基本写法: 注意:我们经常调试代码的时候基本都用chrome浏览器,但是我就因为用了谷歌浏览器(它总是登录的时候不提示我用验证码,误导我以为登录时不需要验证码,其实 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- scrapy爬虫学习系列三:scrapy部署到scrapyhub上
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- Scrapy爬虫入门Request和Response(请求和响应)
开发环境:Python 3.6.0 版本 (当前最新)Scrapy 1.3.2 版本 (当前最新) 请求和响应 Scrapy的Request和Response对象用于爬网网站. 通常,Request对 ...
- Scrapy爬虫入门系列4抓取豆瓣Top250电影数据
豆瓣有些电影页面需要登录才能查看. 目录 [隐藏] 1 创建工程 2 定义Item 3 编写爬虫(Spider) 4 存储数据 5 配置文件 6 艺搜参考 创建工程 scrapy startproj ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影
前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大家讲解一个完整爬虫的流程. 工具和环境 语言:python 2 ...
- [Python爬虫] scrapy爬虫系列 <一>.安装及入门介绍
前面介绍了很多Selenium基于自动测试的Python爬虫程序,主要利用它的xpath语句,通过分析网页DOM树结构进行爬取内容,同时可以结合Phantomjs模拟浏览器进行鼠标或键盘操作.但是,更 ...
随机推荐
- python中的时间和时间格式转换
1.python中的时间:要得到年月日时分秒的时间: import time #time.struct_time(tm_year=2012, tm_mon=9, tm_mday=15, tm_hour ...
- drop_cache-sar
查线上问题: 1.cpu idle 为0 ,I/O高, pidstat 发现进程io 不高,那就是cache mem引起系统io高了 没有vmstat,只能使用sar工具了,使用sar -r 查看 ...
- mysql 面试100 问(精华学习)。待开始理
https://juejin.im/post/6850037271233331208 https://juejin.im/entry/6844903681091977229
- 用seaborn绘制散点图
散点图可以显示观察数据的分布,描述数据的相关性,matlibplot也可以绘制散点图,不过我一般优先使用seaborn库的sctterplot()绘制,下面就介绍一下如何用seaborn.scatte ...
- Python_PyQt5_库
QtQWidgets 小组件(暂无资料,但是Python中做窗口/网页时用的很多 *-*) QtCore 模块包括了核心的非GUI功能,该模块用来对时间.文件.目录.各种数据类型.流.网址.媒体 ...
- DDBNet:Anchor-free新训练方法,边粒度IoU计算以及更准确的正负样本 | ECCV 2020
论文针对当前anchor-free目标检测算法的问题提出了DDBNet,该算法对预测框进行更准确地评估,包括正负样本以及IoU的判断.DDBNet的创新点主要在于box分解和重组模块(D&R) ...
- 标准库之time,random,sys,os
# import time # print(time.time()) # 时间戳 # print(time.mktime(time.localtime())) # 结构化时间转换为时间戳 # prin ...
- RayFire的下载与安装方法
RayFire的下载与安装方法 发布时间:2020/10/12 近几年,电影中融入了越来越多的动画元素,其中的爆炸场景更是十分吸引眼球.小编不禁好奇,什么样的插件能做出来如此好玩的特效,上网搜索一番发 ...
- 用FL Studio来给电子音乐混音的方法
FL Studio也算是音乐人用的比较多的编曲.混音软件了,FL Studio的一大的特色就是电子音乐的制作.尤其是对混音的操作,混音是电音制作过程中一个非常重要的环节,非常重要. 混音是什么?混音的 ...
- day97:MoFang:移动端APP开发准备&移动端项目搭建&APICloud前端框架
目录 1.移动端开发相关概念 1.APP类型 2.移动端屏幕介绍 3.移动端自适配方案 4.元信息(meta) 2.APP开发准备 1.注册APPCLoud账号 2.下载APP开发编辑器 3.下载AP ...