
Solr7.2.1环境搭建和配置ik中文分词器
solr7.2.1环境搭建和配置ik中文分词器
安装环境:Jdk 1.8、 windows 10
安装包准备:
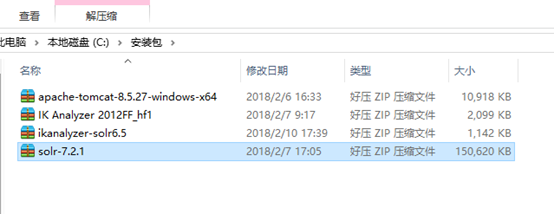
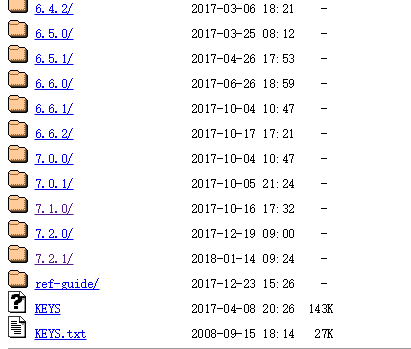
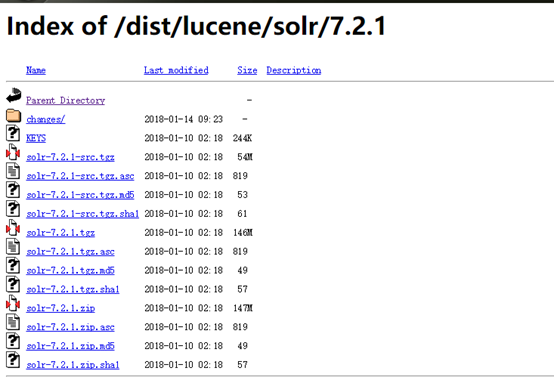
solr 各种版本集合下载:http://archive.apache.org/dist/lucene/solr/
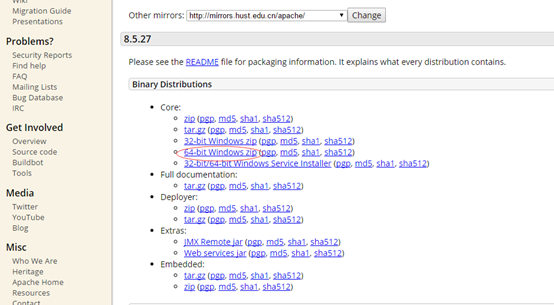
tomcat下载(apache-tomcat-8.5.27-windows-x64.zip):https://tomcat.apache.org/download-80.cgi
下载ik分词器:IK Analyzer 2012FF_hf1.zip,这里这个版本已经不能使用,ik-analyzer官网:https://code.google.com/p/ik-analyzer/

这个网站不翻墙是访问不了的,可以去下面这个网站下载:https://www.developerfusion.com/project/41221/ikanalyzer/
IK分词器2012年以后就没有更新过,其所依赖的lucene相关组件的版本为4.X,而solr7.2下面的lucene版本为7.2,会导致分词功能不能正常使用;
解决办法:需要下载以下两个分词jar包solr-analyzer-ik-5.1.0.jar ik-analyzer-solr5-5.x.jar。
下载地址:http://files.cnblogs.com/files/wander1129/ikanalyzer-solr6.5.zip
1、搭建solr环境
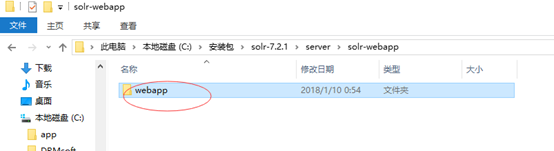
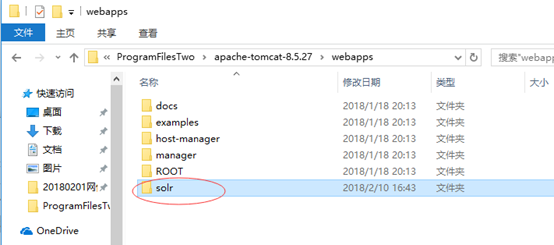
1 解压下载的solr-7.2.1压缩包,将解压后的solr-7.2.1文件夹下server\solr-webapp\webapp文件夹拷贝到tomcat安装目录下的webapps文件夹中,并重命名为solr。如下图:
2 创建一个solr_home的文件夹作为solr的安装目录,如:C:\ProgramFilesTwo\solr_home
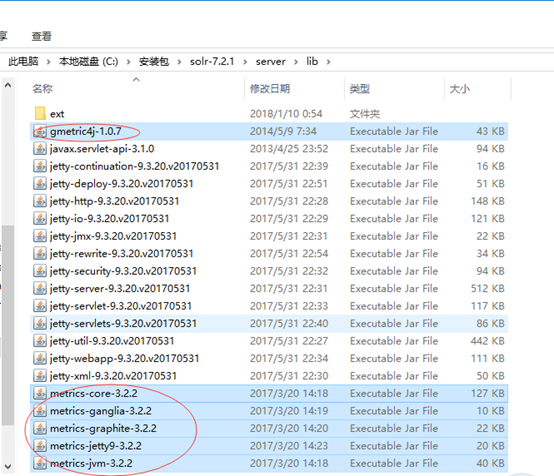
3 将解压后的solr-7.2.1文件夹下server\lib\ext内的所有jar包、server\lib内以metrics开头的所有jar包,以及gmetric4j-1.0.7.jar复制到tomcat安装目录下的webapps\solr\WEB-INF\lib下。

4 在tomcat安装目录下的webapps\solr\WEB-INF中,新建一个classes文件夹,将解压后的solr-7.2.1文件夹下server\resources内的log4j.properties文件拷贝到里面
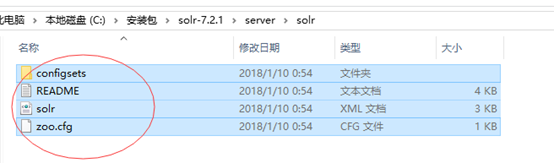
5 拷贝solr-7.2.1文件夹下server\solr内的所有文件到solr_home的文件夹中(即solr的安装目录)
6在solr_home文件夹下新建一个logs文件夹。
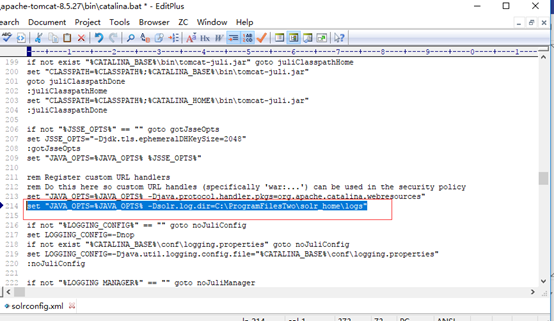
7修改tomcat安装目录下bin文件夹中的catalina.bat,添加solr.log.dir系统变量, 指定solr日志记录存放地址(即上面创建的logs文件夹路径)。例如:
set "JAVA_OPTS=%JAVA_OPTS% -Dsolr.log.dir=C:\ProgramFilesTwo\solr_home\logs"
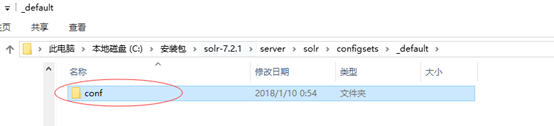
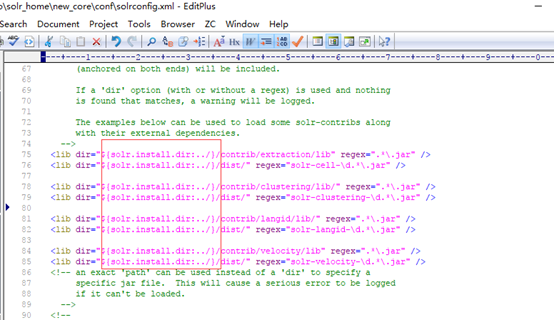
8.在solr_home文件夹下新建一个new_core文件夹,将解压后的solr-7.2.1文件夹下server\solr\configsets\_default下的conf文件夹拷贝到里面,然后修改conf文件夹里solrconfig.xml文件,如下:
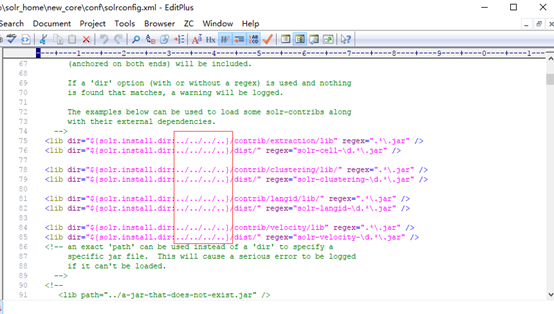
改为:
9.修改tomcat安装目录下webapps\solr\WEB-INF内的web.xml文件:
添加内容:

注释内容:
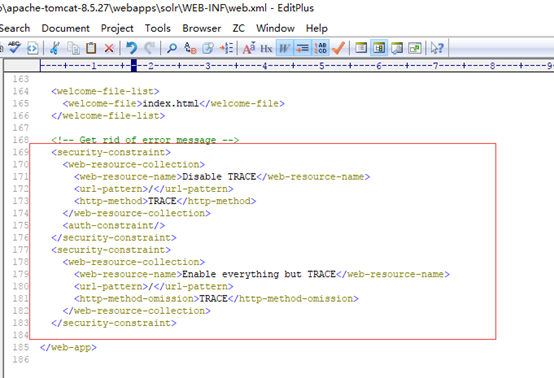
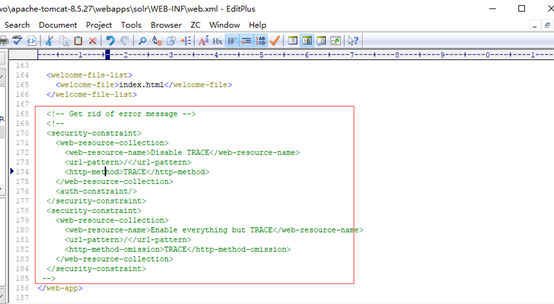
10. 修改端口,默认是8080(看需要设置),修改在tomcat安装目录下conf文件夹内的server.xml文件:
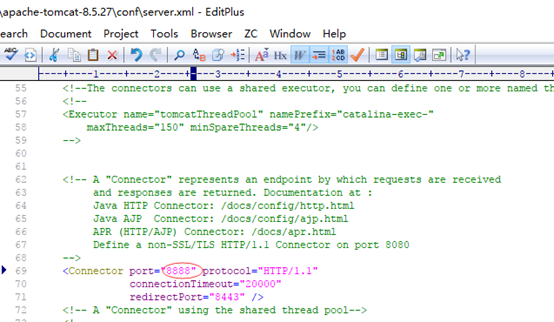
11.查看solr, http://localhost:8888/solr/index.html#/
点击Core Admin菜单,如果没有Core,会弹出如下框,提示添加。
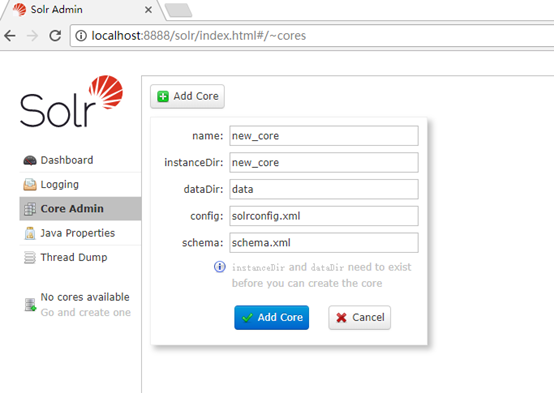
instanceDir: solr安装目录下的new_core文件夹的路径
dataDir: solr安装目录下的new_core\data文件夹的路径
config: solr安装目录下的new_core\conf\solrconfig.xml文件的路径
schema: solr安装目录下的new_core\conf\managed-schema文件的路径
添加以后就可以选择使用了
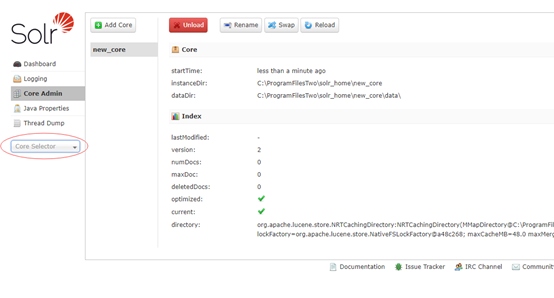
到这里solr的环境就搭建好了,下面开始整合中文分词器;
2、整合分词器
1、使用.solr7.2.1自带的中文分词器
将解压后的solr-7.2.1\contrib\analysis-extras\lucene-libs下的lucene-analyzers-smartcn-7.2.1.jar 放到Tomcat8\webapps\solr\WEB-INF\lib下。

在Tomcat8\solr_h\solrhome\solr_core\conf找到managed-schema 添加已下代码
<fieldType name="text_ik_zd" class="solr.TextField" positionIncrementGap="100">
<analyzer type="index">
<tokenizer class="org.apache.lucene.analysis.cn.smart.HMMChineseTokenizerFactory"/>
</analyzer>
<analyzer type="query">
<tokenizer class="org.apache.lucene.analysis.cn.smart.HMMChineseTokenizerFactory"/>
</analyzer>
</fieldType>
重新启动Tomcat8,就可以使用solr自带的分词器了
2、配置ik中文分词器(好处:IKAnalyzer支持屏蔽关键词、新词汇的配置)
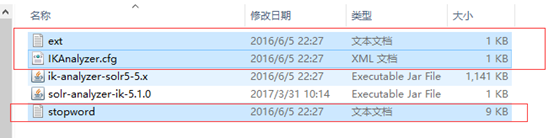
解压IK Analyzer 2012FF_hf1压缩包:
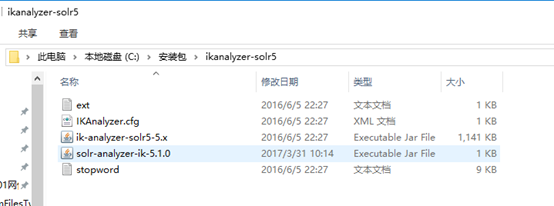
ext.dic为扩展字典,改为mydict.dic 这个扩展词收录了搜狗词库
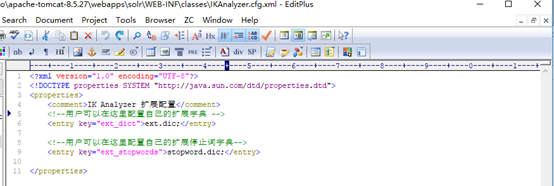
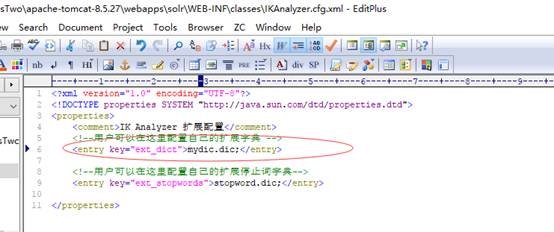
stopword.dic为停止词字典
IKAnalyzer.cfg.xml为配置文件
solr-analyzer-ik-5.1.0.jar ik-analyzer-solr5-5.x.jar为分词jar包。
将IK分词器 JAR 包拷贝到C:\ProgramFilesTwo\apache-tomcat-8.5.27\webapps\solr\WEB-INF\lib下
将词典配置文件拷贝到 C:\ProgramFilesTwo\apache-tomcat-8.5.27\webapps\solr\WEB-INF\classes下
更改在C:\ProgramFilesTwo\solr_home\new_core\conf找到managed-schema配置文件,添加以下:
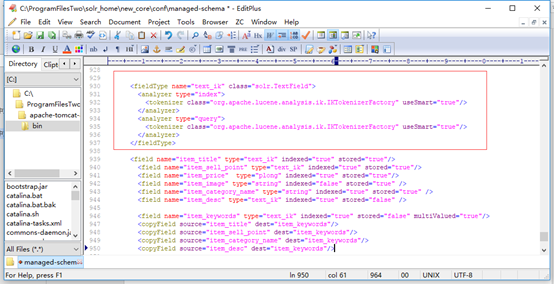
<fieldType name="text_ik" class="solr.TextField">
<analyzer type="index">
<tokenizer class="org.apache.lucene.analysis.ik.IKTokenizerFactory" useSmart="true"/>
</analyzer>
<analyzer type="query">
<tokenizer class="org.apache.lucene.analysis.ik.IKTokenizerFactory" useSmart="true"/>
</analyzer>
</fieldType>
<field name="item_title" type="text_ik" indexed="true" stored="true"/>
<field name="item_sell_point" type="text_ik" indexed="true" stored="true"/>
<field name="item_price" type="plong" indexed="true" stored="true"/>
<field name="item_image" type="string" indexed="false" stored="true" />
<field name="item_category_name" type="string" indexed="true" stored="true" />
<field name="item_desc" type="text_ik" indexed="true" stored="false" />
<field name="item_keywords" type="text_ik" indexed="true" stored="false" multiValued="true"/>
<copyField source="item_title" dest="item_keywords"/>
<copyField source="item_sell_point" dest="item_keywords"/>
<copyField source="item_category_name" dest="item_keywords"/>
<copyField source="item_desc" dest="item_keywords"/>
重新启动Tomcat8.5.27,就可以使用ik的分词器了
参考博文:
http://blog.csdn.net/lingzhangjie/article/details/79114993
http://blog.csdn.net/m0_37044606/article/details/79155144
https://www.cnblogs.com/kehaocheng/p/8005532.html
Solr7.2.1环境搭建和配置ik中文分词器的更多相关文章
- 真分布式SolrCloud+Zookeeper+tomcat搭建、索引Mysql数据库、IK中文分词器配置以及web项目中solr的应用(1)
版权声明:本文为博主原创文章,转载请注明本文地址.http://www.cnblogs.com/o0Iris0o/p/5813856.html 内容介绍: 真分布式SolrCloud+Zookeepe ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十九)ES6.2.2 安装Ik中文分词器
注: elasticsearch 版本6.2.2 1)集群模式,则每个节点都需要安装ik分词,安装插件完毕后需要重启服务,创建mapping前如果有机器未安装分词,则可能该索引可能为RED,需要删除后 ...
- ES-Mac OS环境搭建-ik中文分词器
下载 从github下载ik中文分词器,点击地址,需要注意的是,ik分词器和elasticsearch版本必须一致. 安装 下载到本地并解压到elasticsearch中的plugins目录内即可. ...
- Solr7.3.0入门教程,部署Solr到Tomcat,配置Solr中文分词器
solr 基本介绍 Apache Solr (读音: SOLer) 是一个开源的搜索服务器.Solr 使用 Java 语言开发,主要基于 HTTP 和 Apache Lucene 实现.Apache ...
- Solr学习笔记之2、集成IK中文分词器
Solr学习笔记之2.集成IK中文分词器 一.下载IK中文分词器 IK中文分词器 此文IK版本:IK Analyer 2012-FF hotfix 1 完整分发包 二.在Solr中集成IK中文分词器 ...
- ElasticSearch速学 - IK中文分词器远程字典设置
前面已经对”IK中文分词器“有了简单的了解: 但是可以发现不是对所有的词都能很好的区分,比如: 逼格这个词就没有分出来. 词库 实际上IK分词器也是根据一些词库来进行分词的,我们可以丰富这个词库. ...
- 搜索引擎ElasticSearch系列(五): ElasticSearch2.4.4 IK中文分词器插件安装
一:IK分词器简介 IK Analyzer是一个开源的,基于java语言开发的轻量级的中文分词工具包.从2006年12月推出1.0版开始, IKAnalyzer已经推出了4个大版本.最初,它是以开源 ...
- elasticsearch使用ik中文分词器
elasticsearch使用ik中文分词器 一.背景 二.安装 ik 分词器 1.从 github 上找到和本次 es 版本匹配上的 分词器 2.使用 es 自带的插件管理 elasticsearc ...
- es5.0 安装ik中文分词器 mac
es5.0集成ik中文分词器,网上资料很多,但是讲的有点乱,有的方法甚至不能正常运行此插件 特别注意的而是,es的版本一定要和ik插件的版本相对应: 1,下载ik 插件: https://github ...
随机推荐
- [HDU3072]:Intelligence System(塔尖+贪心)
题目传送门 题目描述 “这一切都是命运石之门的选择.”试图研制时间机器的机关SERN截获了中二科学家伦太郎发往过去的一条短 信,并由此得知了伦太郎制作出了电话微波炉(仮).为了掌握时间机器的技术,SE ...
- Selenium 上手:Selenium扫盲区
Selenium 自述Selenium 是由Jason Huggins软件工程师编写的一个开源的浏览器自动化测试框架.主要用于测试自动化Web UI应用程序. Selenium 工作原理通过编程语言( ...
- HTTP头详解:
GET/mycode/2.gifHTTP/1.1 [表示发送的是GET请求,请求资源是/mycode/2.gif,协议HTTP/1.1] Host:localhost [主机] Connectio ...
- 二进制方式安装mysql
下载官方打包好的rpm的集合 https://downloads.mysql.com/archives/get/file/mysql-5.7.20-1.el7.x86_64.rpm-bundle.ta ...
- 阶段3 1.Mybatis_07.Mybatis的连接池及事务_5 mybatis中使用poolead配置连接的原理分析
idelConnection是空闲的链接 idelConnection就是ArrayList的数组 如果没有空闲的就new一个 新的connection 一个空闲池,一个活动的池,一个链接过来.空闲池 ...
- RabbitMQ安装及其中遇到的问题解决方案
参考官方文档:https://www.rabbitmq.com/install-debian.html#apt 第一步: # import PackageCloud signing key wget ...
- gitlab在centos7.3上搭建
gitlab在centos7.3上搭建 最近接到gitlab+jenkins的任务,由于以前只接触过GitHub,并只是简单的使用,这里简单记录gitlab与jenkins搭建的 环境: centos ...
- idea中怎么去查看maven项目的依赖包是否有冲突
1:快捷键:
- 【Python】关于近期爬虫学习的总结
写在开头 在之前的三篇文章中,我尝试了使用python爬虫实现的对于特定站点的<剑来>小说的爬取,对于豆瓣的短评的爬取,也有对于爬取的短评数据进行的词云展示,期间运用了不少的知识,现在是时 ...
- 网络编程.TCP分块接收数据(AIO)(IOCP)
1.前提:每次投递的接收缓冲区 在它返回后 就不再用它进行2次投递了 于是 接收缓冲区 在返回的时候,数据都是 从接收缓冲区的偏移[0]处开始填充的,且 接收缓冲区 可能被填满 也可能未被填满. 1. ...