
防止过拟合的方法 预测鸾凤花(sklearn)
1. 防止过拟合的方法有哪些?
过拟合(overfitting)是指在模型参数拟合过程中的问题,由于训练数据包含抽样误差,训练时,复杂的模型将抽样误差也考虑在内,将抽样误差也进行了很好的拟合。
产生过拟合问题的原因大体有两个:训练样本太少或者模型太复杂。
防止过拟合问题的方法:
(1)增加训练数据。
考虑增加训练样本的数量
使用数据集估计数据分布参数,使用估计分布参数生成训练样本
使用数据增强
(2)减小模型的复杂度。
a.减少网络的层数或者神经元数量。这个很好理解,介绍网络的层数或者神经元的数量会使模型的拟合能力降低。
b.参数范数惩罚。参数范数惩罚通常采用L1和L2参数正则化(关于L1和L2的区别联系请戳这里)。
c.提前终止(Early stopping);
d.添加噪声。添加噪声可以在输入、权值,网络相应中添加。
e.结合多种模型。这种方法中使用不同的模型拟合不同的数据集,例如使用 Bagging,Boosting,Dropout、贝叶斯方法
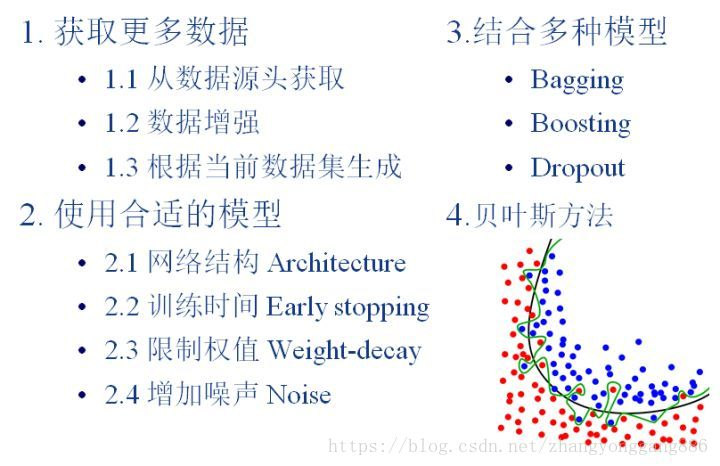
而在深度学习中,通常解决的方法如下
Early stopping方法的具体做法是,在每一个Epoch结束时(一个Epoch集为对所有的训练数据的一轮遍历)计算validation data的accuracy,当accuracy不再提高时,就停止训练。
获取更多数据(从数据源头获取更多数据 根据当前数据集估计数据分布参数,使用该分布产生更多数据 数据增强(Data Augmentation))
正则化(直接将权值的大小加入到 Cost 里,在训练的时候限制权值变大)
dropout:在训练时,每次随机(如50%概率)忽略隐层的某些节点;
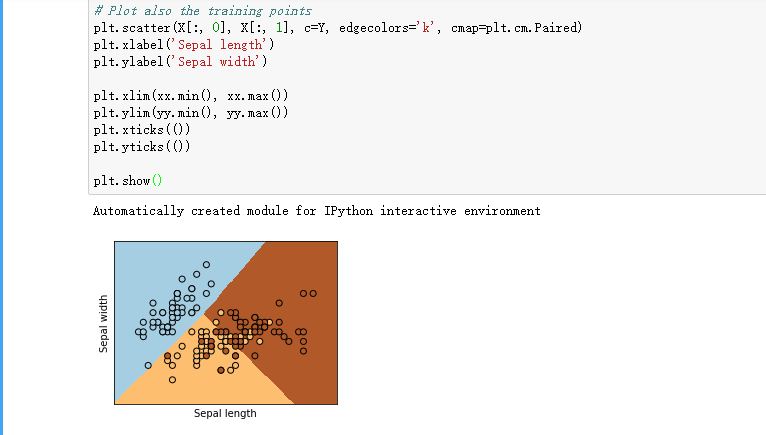
2. 使用逻辑回归(Logistic Regression)对鸢尾花数据(多分类问题)进行预测,可以直接使用sklearn中的LR方法,并尝试使用不同的参数,包括正则化的方法,正则项系数,求解优化器,以及将二分类模型转化为多分类模型的方法。
获取鸢尾花数据的方法:
from sklearn.datasets import load_iris
X, y = load_iris(return_X_y=True)
print(__doc__)

# Code source: Gaël Varoquaux

# Modified for documentation by Jaques Grobler

# License: BSD 3 clause

import numpy as np

import matplotlib.pyplot as plt

from sklearn import linear_model, datasets

# import some data to play with

iris = datasets.load_iris()

X = iris.data[:, :2]  # we only take the first two features.

Y = iris.target

h = .02  # step size in the mesh

logreg = linear_model.LogisticRegression(C=1e5)

# we create an instance of Neighbours Classifier and fit the data.

logreg.fit(X, Y)

# Plot the decision boundary. For that, we will assign a color to each

# point in the mesh [x_min, x_max]x[y_min, y_max].

x_min, x_max = X[:, 0].min() - .5, X[:, 0].max() + .5

y_min, y_max = X[:, 1].min() - .5, X[:, 1].max() + .5

xx, yy = np.meshgrid(np.arange(x_min, x_max, h), np.arange(y_min, y_max, h))

Z = logreg.predict(np.c_[xx.ravel(), yy.ravel()])

# Put the result into a color plot

Z = Z.reshape(xx.shape)

plt.figure(1, figsize=(4, 3))

plt.pcolormesh(xx, yy, Z, cmap=plt.cm.Paired)

# Plot also the training points

plt.scatter(X[:, 0], X[:, 1], c=Y, edgecolors='k', cmap=plt.cm.Paired)

plt.xlabel('Sepal length')

plt.ylabel('Sepal width')

plt.xlim(xx.min(), xx.max())

plt.ylim(yy.min(), yy.max())

plt.xticks(())

plt.yticks(())

plt.show()
防止过拟合的方法 预测鸾凤花(sklearn)的更多相关文章
- CNN 防止过拟合的方法
CNN 防止过拟合的方法 因为数据量的限制以及训练参数的增多,几乎所有大型卷积神经网络都面临着过拟合的问题,目前常用的防止过拟合的方法有下面几种: 1. data augmentation: ...
- 使用基于Apache Spark的随机森林方法预测贷款风险
使用基于Apache Spark的随机森林方法预测贷款风险 原文:Predicting Loan Credit Risk using Apache Spark Machine Learning R ...
- how to avoid over-fitting?(机器学习中防止过拟合的方法,重要)
methods to avoid overfitting: Cross-Validation : Cross Validation in its simplest form is a one roun ...
- Andrew Ng机器学习算法入门(十):过拟合问题解决方法
在使用机器学习对训练数据进行学习和分类的时候,会出现欠拟合和过拟合的问题.那么什么是欠拟合和过拟合问题呢?
- 想到的regular方法果然已经被sklearn实现了就是L1和L2组合rugular
- 机器学习中模型泛化能力和过拟合现象(overfitting)的矛盾、以及其主要缓解方法正则化技术原理初探
1. 偏差与方差 - 机器学习算法泛化性能分析 在一个项目中,我们通过设计和训练得到了一个model,该model的泛化可能很好,也可能不尽如人意,其背后的决定因素是什么呢?或者说我们可以从哪些方面去 ...
- 评价指标的局限性、ROC曲线、余弦距离、A/B测试、模型评估的方法、超参数调优、过拟合与欠拟合
1.评价指标的局限性 问题1 准确性的局限性 准确率是分类问题中最简单也是最直观的评价指标,但存在明显的缺陷.比如,当负样本占99%时,分类器把所有样本都预测为负样本也可以获得99%的准确率.所以,当 ...
- Neural Network Toolbox使用笔记1:数据拟合
http://blog.csdn.net/ljp1919/article/details/42556261 Neural Network Toolbox为各种复杂的非线性系统的建模提供多种函数和应用程 ...
- lecture9-提高模型泛化能力的方法
HInton第9课,这节课没有放论文进去.....如有不对之处还望指正.话说hinton的课果然信息量够大.推荐认真看PRML<Pattern Recognition and Machine L ...
随机推荐
- 【u201】矩形覆盖
Time Limit: 1 second Memory Limit: 128 MB [问题描述] 有N个矩形,矩形的底边边长为1,且均在X轴上,高度给出,第i个矩形的高为h[i],例如h = [3, ...
- CF1208
CF1208 打的话貌似能够涨分的样子? A 水题 B 枚举左端点,看看右端点的最近位置 开一个类似于桶的东西维护一下上一次出现位置 左端点左边就删掉,否则就要将上一次出现的位置删掉 时间复杂度\(O ...
- ZOJ——Knight Moves(bfs)
Knight Moves Time Limit: 2 Seconds Memory Limit: 65536 KB A friend of you is doing research on ...
- Squid使用账号密码进行认证
Squid 3.5支持ssl代理,为保证安全和滥用,可以使用简单的认证. Step1:在squid的配置文件中,添加如下: auth_param basic program /usr/lib64/sq ...
- 破解第一个程序----分析APK文件
反编译APK成功后,在outdir目录下会生成一系列目录与文件. smali:程序所有的反汇编代码: res:程序中所有的资源文件: 如何寻找突破口是分析程序的关键.错误提示一般是指引关键代码的风向标 ...
- ApkTool工具
ApkTool: 一款很好的反编译工具,支持Linux和Windows. 如何使用: 1:需要一个JAVA环境.由于之前已经装过JAVA 相关JDK,JRE,不赘述. 2:下载ApkTool工具: ...
- ASP.NET MVC API以及.Core API进行安全拦截和API请求频率控制
安全拦截思路: 根据IP以及请求次数,该IP超过规定请求次数,就有很大可能是非正常用户进行的请求(比如WEB攻击),这时候进行拦截,拦截成功会提示:The allowed number of requ ...
- 第三阶段:3.Web端产品设计:3.产品设计的层次
一般淘宝购物的五个流程:浏览对应表现层,搜索对应框架层,产品页面对应架构层,确认对应范围层,付款对应战略层. 从具象到抽象.但是我们做产品都是从抽象到具象,而用户使用产品是从具象到抽象. 各个层次之间 ...
- leetcode.1266访问所有点的最小时间
平面上有 n 个点,点的位置用整数坐标表示 points[i] = [xi, yi].请你计算访问所有这些点需要的最小时间(以秒为单位). 你可以按照下面的规则在平面上移动: 每一秒沿水平或者竖直方向 ...
- mumu模拟器手Q自动化配置
{ "platformName": "Android", "platformVersion": "6.0.1", &qu ...