
爬虫学习笔记2requests库和beautifulsoup4库学习笔记
1.requests库
1.1 安装
win下
pip install requests
1.2 常用方法
#各种请求方式:常用的就是requests.get()和requests.post()

>>> import requests

>>> r = requests.get('https://api.github.com/events')

>>> r = requests.post('http://httpbin.org/post', data = {'key':'value'})

>>> r = requests.put('http://httpbin.org/put', data = {'key':'value'})

>>> r = requests.delete('http://httpbin.org/delete')

>>> r = requests.head('http://httpbin.org/get')

>>> r = requests.options('http://httpbin.org/get')
1.2.1 .get((url, params=None, **kwargs),常用方法
- 发送一个get请求到服务器端
- url接收一个URL地址
- parmas接收一个字典对象
- 返回一个请求对象
[廖雪峰](https://www.liaoxuefeng.com/wiki/1016959663602400/1183249464292448)
get方法对于特定类型的json可以直接获取
1.2.2 .post()
需要有个参数,字典
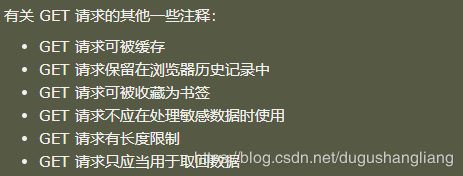
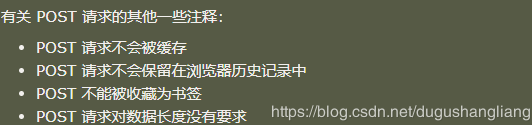
有关get请求和post请求的区别
1.2.3 .content()
获取二进制的数据,因为像音频,图片,视频等是二进制保存的
1.2.4 .json()
对于一些事json存储格式的,可以直接调用这个方法
1.2.5 .session()
利用session模型登陆进行先后访问
后面补充
等
2.beautifulsoup4
解析html的强大工具
beautifulsoup默认支持python的标准html解析库,但是它也支持第三方库lxml xml等
我是anaconda3 里面自带这个库
2.1 常用方法
就是看一些标签把,一般提取之前,先F12,查看下 原网页的你需要的东西都在那个标签或者那个子标签里面
.prettify() 缩进格式
.title 获取title的所有名称
.title.string 获取title所有的内容
.head 获取head标签中的内容
.div 获取div标签中的内容
.a 获取a标签中的内容
.find_all("a") 获取a标签中的所有内容
.find(id="ul") 获取id="ul"
#获取所有的a标签,并遍历打印a标签中的href的值

for item in bs.find_all("a"):

    print(item.get("href"))
#获取所有的a标签,并遍历打印a标签的文本值

for item in bs.find_all("a"):

  print(item.get_text())
2.2 bs4 中四大对象种类
- Tag html中的一个个标签
- NavigableString 获取标签内部的文字用.string就行
- BeautifulSoup 一个文档的内容
- Comment 一个特殊类型的NavigableString对象,其输出的内容不包括注释符号
对于Tag,有两个重要的属性,name和attrs
一般对于标签来说,其name就是标签名字
attr是可以提取标签的属性的,得到的类型是一个字典
可以修改删除属性
2.3 遍历文档树
- .contents 获取Tag的所有子节点,返回一个list,因此可以按照list的方式提取值
- .children 获取Tag的所有子节点,返回一个生成器
初步认为这俩的不同是返回对象的类型不太一样
children用的多一点嘛?
**一般获取所有的xx节点就是上一个for循环就好了
for child in bs.body.children:

    print(children)
2.4 搜索文档树
2.4.1 find_all
find_all(name,attrs,recursive,text,%%kwargs)
name参数
- 字符串过滤,会查找与字符串完全匹配的内容,也就是精确查找
- 正则表达式:若是正则表达式那就通过search()来匹配内容
- 列表:与列表中的任一元素匹配的节点返回
t_list=bs.find_all(["meta","link"])

for item in t_list:

    print(item)
- 方法:传入方法就根据方法来匹配
def name_is_exists(tag):

    return tag.has_attr("name")

t_list=bs.find_all(name_is_exists)

for item in t_list:

    print(item)
kwargs
#查询id=head的Tag

t_list=bs.find_all(id="head")

print(t_list)

#查询所有包含class的Tag(因为class在python中属于关键字,所以加上_进行区别)

```python

t_list=bs.find_all(class_=True)

for item in t_list:

    print(item)
attr参数
不是所有的属性都可以用上面的方式进行搜索,比如html中的data-*属性,可以使用attr参数,定义一个字典素偶所包含特殊属性的tag:
t_list=bs.find_all(attrs={"data-foo":"values"})

for item in t_list:

    print(item)
text参数
可以通过线束搜索文档中的字符串内容,与name的可选参数一样
limit参数
传入一个limit参数;哎限制返回的数量
2.4.2 find
返回符合条件的第一个Tag
2.5 css选择器
.select()
爬虫学习笔记2requests库和beautifulsoup4库学习笔记的更多相关文章
- Python:requests库、BeautifulSoup4库的基本使用(实现简单的网络爬虫)
Python:requests库.BeautifulSoup4库的基本使用(实现简单的网络爬虫) 一.requests库的基本使用 requests是python语言编写的简单易用的HTTP库,使用起 ...
- 用requests库和BeautifulSoup4库爬取新闻列表
import requests from bs4 import BeautifulSoup url='http://news.gzcc.cn/html/xiaoyuanxinwen/' res=req ...
- Python学习---xml文件的解析[beautifulsoup4模块学习]
1.1. 安装beautifulsoup4 pip install beautifulsoup4 [更多参考]https://blog.csdn.net/sunhuaqiang1/article/de ...
- python应用之爬虫实战2 请求库与解析库
知识内容: 1.requests库 2.selenium库 3.BeautifulSoup4库 4.re正则解析库 5.lxml库 参考: http://www.cnblogs.com/wupeiqi ...
- python网络爬虫学习笔记(二)BeautifulSoup库
Beautiful Soup库也称为beautiful4库.bs4库,它可用于解析HTML/XML,并将所有文件.字符串转换为'utf-8'编码.HTML/XML文档是与“标签树一一对应的.具体地说, ...
- Mudo C++网络库第六章学习笔记
muduo网络库简介 高级语言(Java, Python等)的Sockects库并没有对Sockects API提供更高层的封装, 直接用它编写程序很容易掉到陷阱中: 网络库的价值还在于能方便地处理并 ...
- ArcGIS案例学习笔记_3_2_CAD数据导入建库
ArcGIS案例学习笔记_3_2_CAD数据导入建库 计划时间:第3天下午 内容:CAD数据导入,建库和管理 目的:生成地块多边形,连接属性,管理 问题:CAD存在拓扑错误,标注位置偏移 教程:pdf ...
- Python学习笔记011_模块_标准库_第三方库的安装
容器 -> 数据的封装 函数 -> 语句的封装 类 -> 方法和属性的封装 模块 -> 模块就是程序 , 保存每个.py文件 # 创建了一个hello.py的文件,它的内容如下 ...
- 自己在linux上编译、链接、动态库和静态库的学习笔记
在平常的项目中,我们都是使用公司要求的makefile.makedebug一类的文件,因此,在编译.链接.生成和链接动态库与静态库的时候,我们只是简单的使用一些已经设置的变量,只是简单的修改.添加一些 ...
随机推荐
- xmake v2.3.1 发布, 无缝对接其他构建系统
最近对xmake内部做了不少的重构来改进,并且新增了不少实用的新特性,欢迎来体验. 项目源码 官方文档 一些新特性: 一键编译其他构建系统维护的项目,实现无缝对接,并且支持交叉编译(比如autotoo ...
- mqttnet3.0用法
.net常用的mqtt类库有2个,m2mqtt和mqttnet两个类库 当然了,这两个库的教程网上一搜一大把 但mqttnet搜到的教程全是2.7及以下版本的,但3.0版语法却不再兼容,升级版本会导致 ...
- Ubuntu下LAMP的环境配置教程
总体来说,Ubuntu下安装LAMP环境是比较简单的,只需按照命令行执行即可,记录操作以备不时之需. 一,首先更新Ubuntu里面所有的软件 sudo apt-get update 二.之后安装Apa ...
- VSTO开发指南(VB2013版) 第四章 Excel编程
实例1:处理NewWorkbook和WorkSheet事件的控制台程序 书本第70页 程序清单 4.1 处理NewWorkbook和WorkSheet事件的控制台程序 Imports Excel = ...
- 生成JavaDoc文档
JavaDoc是一种将注释生成HTML文档的技术,生成的HTML文档类似于Java的API,易读且清晰明了.在简略介绍JavaDoc写法之后,再看一下在Intellij Idea 中如何将代码中的注释 ...
- Explain执行计划与索引优化实践
一.何为explain执行计划? 使用explain关键字可以模拟优化器执行SQL语句,从而知道MySQL是如何使用索引来处理你的SQL查询语句以及连接表,可以分析查询语句或是结构的性能瓶颈,帮助我们 ...
- author模块
一.auth模块简介 1.什么是auth模块,auth模块主要是解决什么问题 还是那句话,‘没有无缘无故的爱,也没有无缘无故的恨 凡是必有因’, 像我们开发一个网站,不可避免的设计网络用户系统,比 ...
- RHEL6 yum本地源配置
RHEL6 yum本地源配置 将RHEL6 的iso上传到/file1/xxx 新建目录/file1/xxx/mnt,将iso挂载到mnt目录 mount rhel-server-6.3-x86_64 ...
- #AcWing系列课程Level-2笔记——3. 整数二分算法
整数二分算法 编写整数二分,记住下面的思路,代码也就游刃有余了! 1.首先找到数组的中间值,mid=(left+right)>>1,区间[left, right]被划分成[left, mi ...
- H5测试方法
一 功能测试 1 关注页面请求:请求数据是否正确,相应是否正确,是否有重复请求,造成流量浪费,响应速度变慢 2 关注application cache:cokkie值是否正确,清除cokkie后表现是 ...