
NgDL:第四周深层神经网络
4.3核对矩阵维数

根据前向的矩阵,可以计算出右上的规律,对于第L层的w来说,其维数为(n[L],n[L-1]),n[L]表示第L层的单元数。
4.4为什么深层神经网络会好用?
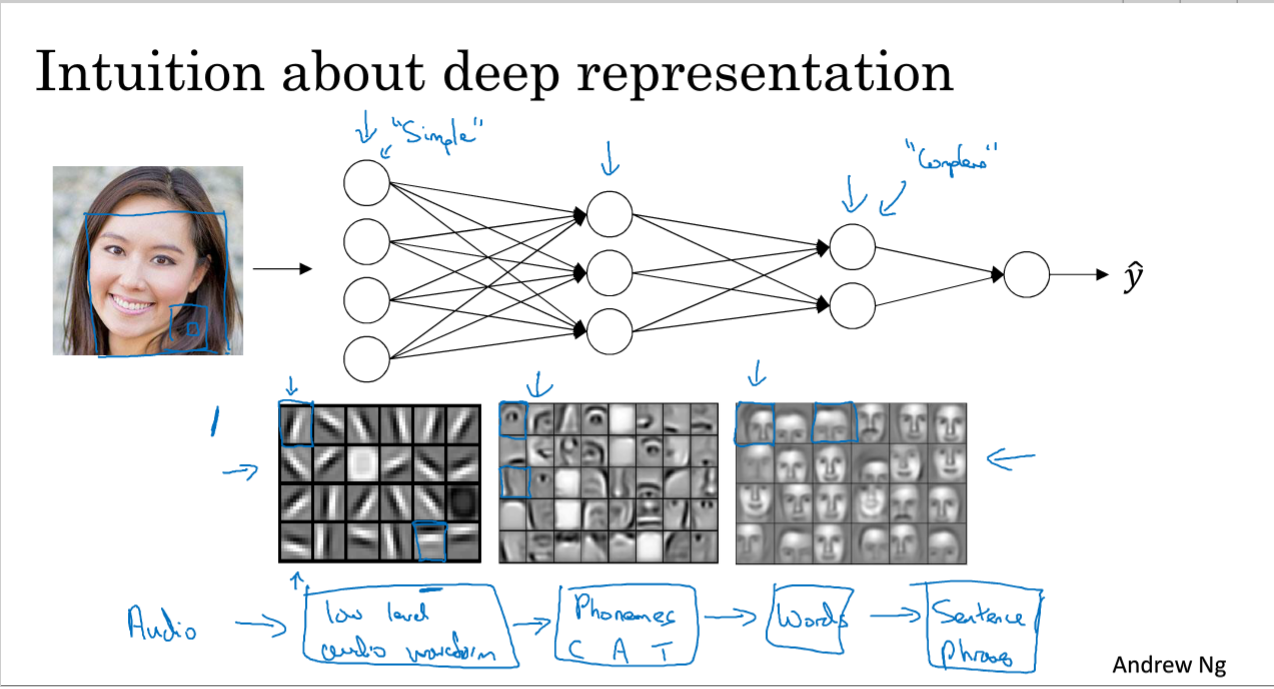
如果要做一个人脸识别的系统:那么浅层的神经网络,进行特征识别或边缘探测,第一张图中的一个小方块就是一个神经单元?无法理解。比如说有个神经单元去找眼睛的部分,这样每个神经元就可以找脸部不同的部位,最后将这些部分放在一起。
边缘探测中针对的都是比较小的,而到面部识别会针对较大的区域。金字塔形状的NN。
Ng讲到了在语音识别上的一个应用:
输入是一段音频,第一层神经网络可以探测比较低层次的音频波形特征,比如音调变高还是变低,然后可以去探测声音的基本单元(音位),cat中的“壳”就是一个音位,然后就可以识别单词,单词组合起来就是词组。
到网络深层时就可以做更复杂的事情,比如检测脸部或者词组。
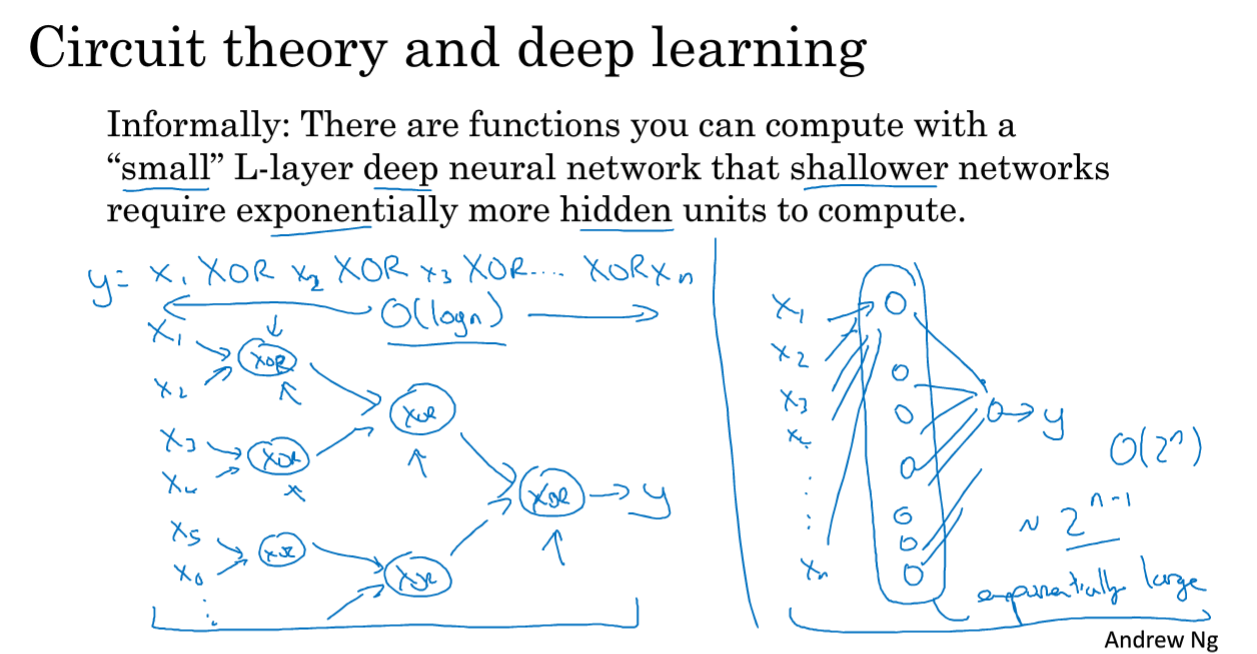
对于电路和深度学习的结合的例子说明为什么深度网络效果好。
假设要对输入特征计算异或,从x1 XOR....xn,如果画一个异或的树图,可建一个较深的异或树图,隐层数为log(n),就是一个二叉树的高度;
如果不允许使用多层神经网络的话,只能使用一个隐层,那就需要考虑所有可能的组合,需要隐层单元数程指数式增长;(需要考虑所有的可能的结合情况?)
4.7参数VS超参数
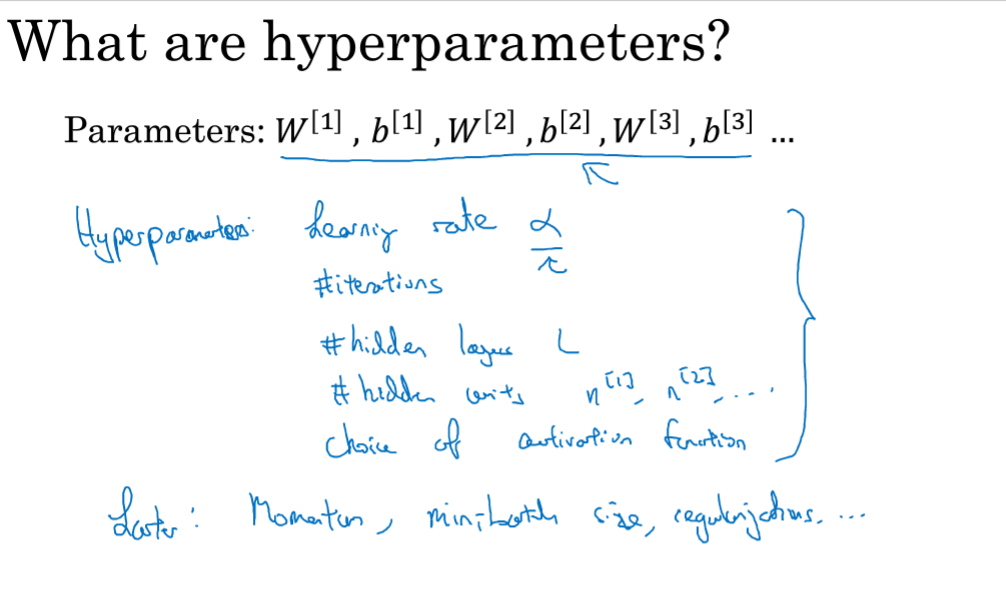
参数:就是比如NN模型中的权重和偏执单元值。
超参数:就是能控制参数的参数。比如学习率α,迭代次数,隐含层层数、隐含层中的单元数、激活函数的选择
还有一些其他的超参数:momentum,minibatch size,正则化规则等。
//头一次知道超参数的定义,原来是这样,不过另外的超参数还不太明白。
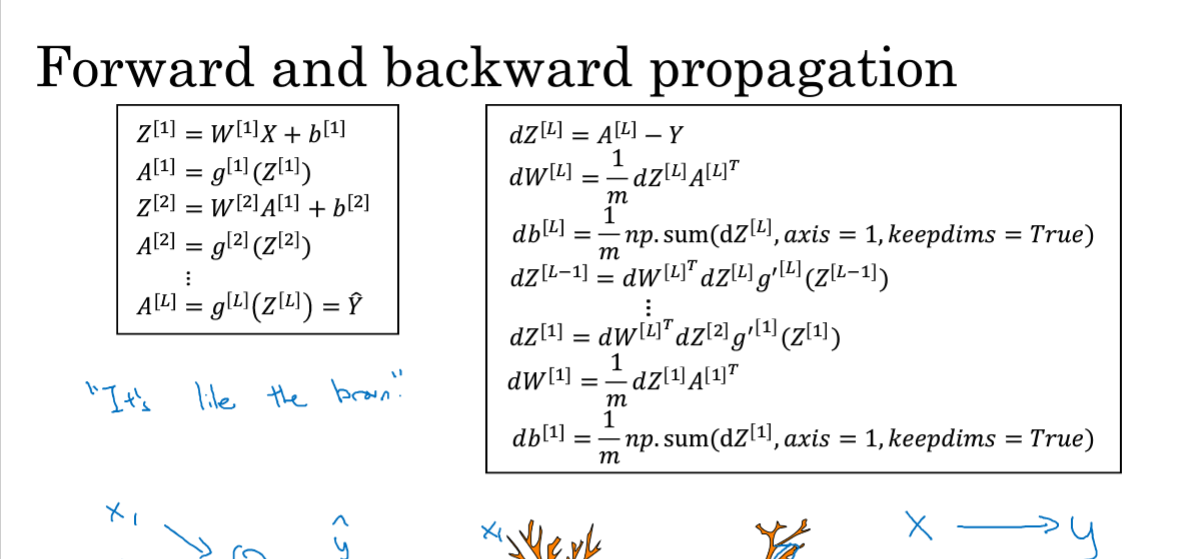
这种公式表述的我还看不太懂,保留一下:
NgDL:第四周深层神经网络的更多相关文章
- 吴恩达《深度学习》-第一门课 (Neural Networks and Deep Learning)-第四周:深层神经网络(Deep Neural Networks)-课程笔记
第四周:深层神经网络(Deep Neural Networks) 4.1 深层神经网络(Deep L-layer neural network) 有一些函数,只有非常深的神经网络能学会,而更浅的模型则 ...
- 吴恩达《深度学习》-课后测验-第一门课 (Neural Networks and Deep Learning)-Week 4 - Key concepts on Deep Neural Networks(第四周 测验 – 深层神经网络)
Week 4 Quiz - Key concepts on Deep Neural Networks(第四周 测验 – 深层神经网络) \1. What is the "cache" ...
- Neural Networks and Deep Learning 课程笔记(第四周)深层神经网络(Deep Neural Networks)
1. 深层神经网络(Deep L-layer neural network ) 2. 前向传播和反向传播(Forward and backward propagation) 3. 总结 4. 深层网络 ...
- DeepLearning.ai学习笔记(一)神经网络和深度学习--Week4深层神经网络
一.深层神经网络 深层神经网络的符号与浅层的不同,记录如下: 用\(L\)表示层数,该神经网络\(L=4\) \(n^{[l]}\)表示第\(l\)层的神经元的数量,例如\(n^{[1]}=n^{[2 ...
- [DeeplearningAI笔记]改善深层神经网络_深度学习的实用层面1.10_1.12/梯度消失/梯度爆炸/权重初始化
觉得有用的话,欢迎一起讨论相互学习~Follow Me 1.10 梯度消失和梯度爆炸 当训练神经网络,尤其是深度神经网络时,经常会出现的问题是梯度消失或者梯度爆炸,也就是说当你训练深度网络时,导数或坡 ...
- [3] TensorFlow 深层神经网络
深层神经网络简称为深度学习有两个非常重要的特性1. 多层2. 非线性 线性模型的局限性 :例如前面的神经网络有两层(不算输入层),但是它和单层的神经网络井没有区别,任意线性模型的组合仍然还是线性模型, ...
- tensorFlow(五)深层神经网络
TensorFlow基础见前博客 上实例: MNIST 数据集介绍 MNIST 是一个手写阿拉伯数字的数据集. 其中包含有 60000 个已经标注了的训练集,还有 10000 个用于测试的测试集. 本 ...
- 改善深层神经网络_优化算法_mini-batch梯度下降、指数加权平均、动量梯度下降、RMSprop、Adam优化、学习率衰减
1.mini-batch梯度下降 在前面学习向量化时,知道了可以将训练样本横向堆叠,形成一个输入矩阵和对应的输出矩阵: 当数据量不是太大时,这样做当然会充分利用向量化的优点,一次训练中就可以将所有训练 ...
- ng-深度学习-课程笔记-5: 深层神经网络(Week4)
1 深度L层神经网络( Deep L-layer Neural network ) 针对具体问题很难判断需要几层的网络,所以先试试逻辑回归是比较合理的做法,然后再试试单隐层,把隐层数量当作一个超参数, ...
随机推荐
- modbus ASCII和MODBUS RTU区别
下表是MODBUS ASCII协议和RTU协议的比较: 协议 开始标记 结束标记 校验 传输效率 程序处理 ASCII :(冒号) CR,LF LRC 低 直观,简单,易调试 RTU 无 无 CRC ...
- iOS - 高德地图将地图的多点连线
@property (nonatomic, strong) MAPolyline *commonPoly; #pragma mark -- 将地图的点连线 - (void)createBrokenLi ...
- day_5.17 飞机大战
ps:2018-7-24 20:58:11 重新整理这个飞机大战源码,我虽然这个时候没看源码,但是知道思路的话用其他语言还是可以写出来的! ''' 2018-5-13 19:53:46 完善成功 一个 ...
- Android Studio 工具窗口浮动与布局恢复【申明:来源于网络】
Android Studio 工具窗口浮动与布局恢复[申明:来源于网络] http://bbs.chinaunix.net/thread-4182438-1-1.html
- N!
求N! Problem Description Given an integer N(0 ≤ N ≤ 10000), your task is to calculate N! Input One N ...
- OOM
在mnist上测试卷积网络时,显存不够导致下面的报错: ResourceExhaustedError (see above for traceback): OOM when allocating te ...
- python与pip安装
# Install pip for 2.7 and then python 2.7 itself sudo apt install python-pip sudo apt install python ...
- Only the storage referenced by ptr is modified. No other storage locations are accessed by the call.
free - C++ Reference http://www.cplusplus.com/reference/cstdlib/free/ Data races Only the storage re ...
- 一个DRAM的存储单元存储的是0还是1取决于电容是否有电荷,有电荷代表1,无电荷代表0。
小结: 1.一个DRAM的存储单元存储的是0还是1取决于电容是否有电荷,有电荷代表1,无电荷代表0. https://baike.baidu.com/item/随机存取存储器/4099402?fr=a ...
- 转:eval(data)和eval("("+data+")")
http://www.w3school.com.cn/jsref/jsref_eval.asp JavaScript eval() 函数:eval() 函数可计算某个字符串,并执行其中的的 JavaS ...