
[MapReduce_add_3] MapReduce 通过分区解决数据倾斜
0. 说明
数据倾斜及解决方法的介绍与代码实现
1. 介绍
【1.1 数据倾斜的含义】
大量数据发送到同一个节点进行处理,造成此节点繁忙甚至瘫痪,而其他节点资源空闲
【1.2 解决数据倾斜的方式】
重新设计 Key(配合二次 MR 使用)
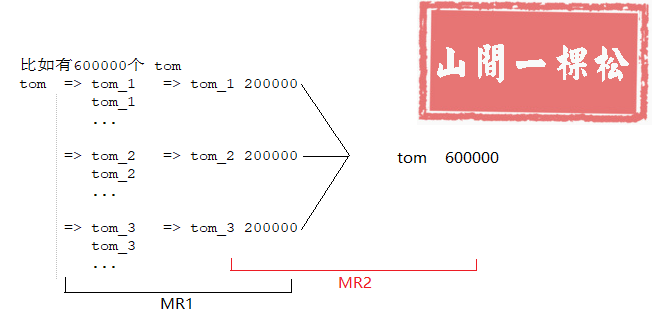
随机分区
伪代码如下:
RandomPartition extends Partitioner{

    return r.nextInt()

}
2. 重新设计 Key 代码编写
[2.1 WCMapper.java]
package hadoop.mr.dataskew;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

import java.util.Random;

/**

 * Mapper 程序

 * 重新设计 Key

 */

public class WCMapper extends Mapper<LongWritable, Text, Text, IntWritable> {

    Random r = new Random();

    int i;

    @Override

    protected void setup(Context context) throws IOException, InterruptedException {

        // 获取 reduce 的个数

        i = context.getNumReduceTasks();

    }

    /**

     * map 函数,被调用过程是通过 while 循环每行调用一次

     */

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        // 将 value 变为 String 格式

        String line = value.toString();

        // 将一行文本进行截串

        String[] arr = line.split(" ");

        for (String word : arr) {

            String newWord = word + "_" + r.nextInt(i);

            context.write(new Text(newWord), new IntWritable(1));

        }

    }

}
[2.2 WCReducer.java]
package hadoop.mr.dataskew;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

/**

 * Reducer 类

 */

public class WCReducer extends Reducer<Text, IntWritable, Text, IntWritable> {

    /**

     * 通过迭代所有的 key 进行聚合

     */

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        int sum = 0;

        for (IntWritable value : values) {

            sum += value.get();

        }

        context.write(key,new IntWritable(sum));

    }

}
[2.3 WCMapper2.java]
package hadoop.mr.dataskew;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

/**

 * Mapper 程序2

 * 重新设计 Key

 */

public class WCMapper2 extends Mapper<LongWritable, Text, Text, IntWritable> {

    /**

     * map 函数,被调用过程是通过 while 循环每行调用一次

     */

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        // 将 value 变为 String 格式

        String line = value.toString();

        // 切割一行文本分为 key 和 value

        String[] arr = line.split("\t");

        String word = arr[0];

        Integer count = Integer.parseInt(arr[1]);

        // 重新设计 Key

        String newWord = word.split("_")[0];

        context.write(new Text(newWord), new IntWritable(count));

    }

}
[2.4 WCReducer2.java]
package hadoop.mr.dataskew;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

/**

 * Reducer 类2

 */

public class WCReducer2 extends Reducer<Text, IntWritable, Text, IntWritable> {

    /**

     * 通过迭代所有的 key 进行聚合

     */

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        int sum = 0;

        for (IntWritable value : values) {

            sum += value.get();

        }

        context.write(key,new IntWritable(sum));

    }

}
[2.5 WCApp.java]
package hadoop.mr.dataskew;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

/**

 * 解决数据倾斜

 */

public class WCApp {

    public static void main(String[] args) throws Exception {

        // 初始化配置文件

        Configuration conf = new Configuration();

        // 仅在本地开发时使用

        conf.set("fs.defaultFS", "file:///");

        // 初始化文件系统

        FileSystem fs = FileSystem.get(conf);

        // 通过配置文件初始化 job

        Job job = Job.getInstance(conf);

        // 设置 job 名称

        job.setJobName("data skew");

        // job 入口函数类

        job.setJarByClass(WCApp.class);

        // 设置 mapper 类

        job.setMapperClass(WCMapper.class);

        // 设置 reducer 类

        job.setReducerClass(WCReducer.class);

        // 设置分区数量

        job.setNumReduceTasks(3);

        // 设置 map 的输出 K-V 类型

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(IntWritable.class);

        // 设置 reduce 的输出 K-V 类型

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        // 设置输入路径和输出路径

        Path pin = new Path("E:/test/wc/dataskew.txt");

        Path pout = new Path("E:/test/wc/out");

//        Path pin = new Path(args[0]);

//        Path pout = new Path(args[1]);

        FileInputFormat.addInputPath(job, pin);

        FileOutputFormat.setOutputPath(job, pout);

        // 判断输出路径是否已经存在,若存在则删除

        if (fs.exists(pout)) {

            fs.delete(pout, true);

        }

        // 执行 job

        boolean b = job.waitForCompletion(true);

        if (b) {

            // 通过配置文件初始化 job

            Job job2 = Job.getInstance(conf);

            // 设置 job 名称

            job2.setJobName("data skew2");

            // job 入口函数类

            job2.setJarByClass(WCApp.class);

            // 设置 mapper 类

            job2.setMapperClass(WCMapper2.class);

            // 设置 reducer 类

            job2.setReducerClass(WCReducer2.class);

            // 设置分区数量

//            job2.setNumReduceTasks(3);

            // 设置 map 的输出 K-V 类型

            job2.setMapOutputKeyClass(Text.class);

            job2.setMapOutputValueClass(IntWritable.class);

            // 设置 reduce 的输出 K-V 类型

            job2.setOutputKeyClass(Text.class);

            job2.setOutputValueClass(IntWritable.class);

            // 设置输入路径和输出路径

            Path pin2 = new Path("E:/test/wc/out");

            Path pout2 = new Path("E:/test/wc/out2");

//        Path pin = new Path(args[0]);

//        Path pout = new Path(args[1]);

            FileInputFormat.addInputPath(job2, pin2);

            FileOutputFormat.setOutputPath(job2, pout2);

            // 判断输出路径是否已经存在,若存在则删除

            if (fs.exists(pout2)) {

                fs.delete(pout2, true);

            }

            // 执行 job

            job2.waitForCompletion(true);

        }

    }

}
3. 随机分区代码编写
[3.1 WCMapper.java]
package hadoop.mr.dataskew2;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

/**

 * Mapper 程序

 * 重新设计 Key

 */

public class WCMapper extends Mapper<LongWritable, Text, Text, IntWritable> {

    /**

     * map 函数,被调用过程是通过 while 循环每行调用一次

     */

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        // 将 value 变为 String 格式

        String line = value.toString();

        // 将一行文本进行截串

        String[] arr = line.split(" ");

        for (String word : arr) {

            context.write(new Text(word), new IntWritable(1));

        }

    }

}
[3.2 WCReducer.java]
package hadoop.mr.dataskew2;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

/**

 * Reducer 类

 */

public class WCReducer extends Reducer<Text, IntWritable, Text, IntWritable> {

    /**

     * 通过迭代所有的 key 进行聚合

     */

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        int sum = 0;

        for (IntWritable value : values) {

            sum += value.get();

        }

        context.write(key, new IntWritable(sum));

    }

}
[3.3 WCMapper2.java]
package hadoop.mr.dataskew2;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

/**

 * Mapper 程序2

 * 重新设计 Key

 */

public class WCMapper2 extends Mapper<LongWritable, Text, Text, IntWritable> {

    /**

     * map 函数,被调用过程是通过 while 循环每行调用一次

     */

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        // 将 value 变为 String 格式

        String line = value.toString();

        // 切割一行文本分为 key 和 value

        String[] arr = line.split("\t");

        String word = arr[0];

        Integer count = Integer.parseInt(arr[1]);

        context.write(new Text(word), new IntWritable(count));

    }

}
[3.4 RandomPartitioner.java]
package hadoop.mr.dataskew2;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Partitioner;

import java.util.Random;

/**

 * 随机分区类

 */

public class RandomPartitioner extends Partitioner<Text, IntWritable> {

    Random r = new Random();

    @Override

    public int getPartition(Text text, IntWritable intWritable, int numPartitions) {

        return r.nextInt(numPartitions);

    }

}
[3.5 WCApp.java]
package hadoop.mr.dataskew2;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

/**

 * 随机分区解决数据倾斜

 */

public class WCApp {

    public static void main(String[] args) throws Exception {

        // 初始化配置文件

        Configuration conf = new Configuration();

        // 仅在本地开发时使用

        conf.set("fs.defaultFS", "file:///");

        // 初始化文件系统

        FileSystem fs = FileSystem.get(conf);

        // 通过配置文件初始化 job

        Job job = Job.getInstance(conf);

        // 设置 job 名称

        job.setJobName("data skew");

        // job 入口函数类

        job.setJarByClass(WCApp.class);

        // 设置 mapper 类

        job.setMapperClass(WCMapper.class);

        // 设置 reducer 类

        job.setReducerClass(WCReducer.class);

        // 设置 partition 类

        job.setPartitionerClass(RandomPartitioner.class);

        // 设置分区数量

        job.setNumReduceTasks(3);

        // 设置 map 的输出 K-V 类型

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(IntWritable.class);

        // 设置 reduce 的输出 K-V 类型

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        // 设置输入路径和输出路径

        Path pin = new Path("E:/test/wc/dataskew.txt");

        Path pout = new Path("E:/test/wc/out");

//        Path pin = new Path(args[0]);

//        Path pout = new Path(args[1]);

        FileInputFormat.addInputPath(job, pin);

        FileOutputFormat.setOutputPath(job, pout);

        // 判断输出路径是否已经存在,若存在则删除

        if (fs.exists(pout)) {

            fs.delete(pout, true);

        }

        // 执行 job

        boolean b = job.waitForCompletion(true);

        if (b) {

            // 通过配置文件初始化 job

            Job job2 = Job.getInstance(conf);

            // 设置 job 名称

            job2.setJobName("data skew2");

            // job 入口函数类

            job2.setJarByClass(hadoop.mr.dataskew.WCApp.class);

            // 设置 mapper 类

            job2.setMapperClass(WCMapper2.class);

            // 设置 reducer 类

            job2.setReducerClass(WCReducer.class);

            // 设置分区数量

//            job2.setNumReduceTasks(3);

            // 设置 map 的输出 K-V 类型

            job2.setMapOutputKeyClass(Text.class);

            job2.setMapOutputValueClass(IntWritable.class);

            // 设置 reduce 的输出 K-V 类型

            job2.setOutputKeyClass(Text.class);

            job2.setOutputValueClass(IntWritable.class);

            // 设置输入路径和输出路径

            Path pin2 = new Path("E:/test/wc/out");

            Path pout2 = new Path("E:/test/wc/out2");

//        Path pin = new Path(args[0]);

//        Path pout = new Path(args[1]);

            FileInputFormat.addInputPath(job2, pin2);

            FileOutputFormat.setOutputPath(job2, pout2);

            // 判断输出路径是否已经存在,若存在则删除

            if (fs.exists(pout2)) {

                fs.delete(pout2, true);

            }

            // 执行 job

            job2.waitForCompletion(true);

        }

    }

}
[MapReduce_add_3] MapReduce 通过分区解决数据倾斜的更多相关文章
- Hadoop_22_MapReduce map端join实现方式解决数据倾斜(DistributedCache)
1.Map端Join解决数据倾斜 1.Mapreduce中会将map输出的kv对,按照相同key分组(调用getPartition),然后分发给不同的reducetask 2.Map输出结果的时候 ...
- Spark性能调优之解决数据倾斜
Spark性能调优之解决数据倾斜 数据倾斜七种解决方案 shuffle的过程最容易引起数据倾斜 1.使用Hive ETL预处理数据 • 方案适用场景:如果导致数据倾斜的是Hive表.如果该Hiv ...
- MapReduce如何解决数据倾斜?
数据倾斜是日常大数据查询中隐形的一个BUG,遇不到它时你觉得数据倾斜也就是书本博客上的一个无病呻吟的偶然案例,但当你遇到它是你就会懊悔当初怎么不多了解一下这个赫赫有名的事故. https://www. ...
- 【Spark篇】---Spark解决数据倾斜问题
一.前述 数据倾斜问题是大数据中的头号问题,所以解决数据清洗尤为重要,本文只针对几个常见的应用场景做些分析 . 二.具体方法 1.使用Hive ETL预处理数据 方案适用场景: 如果导致数据倾斜的是 ...
- 专访周金可:我们更倾向于Greenplum来解决数据倾斜的问题
周金可,就职于听云,维护MySQL和GreenPlum的正常运行,以及调研适合听云业务场景的数据库技术方案. 听云周金可 9月24日,周金可将参加在北京举办的线下活动,并做主题为<GreenPl ...
- MapReduce分区数据倾斜
什么是数据倾斜? 数据不可避免的出现离群值,并导致数据倾斜,数据倾斜会显著的拖慢MR的执行速度 常见数据倾斜有以下几类 1.数据频率倾斜 某一个区域的数据量要远远大于其他区域 2.数据大小倾斜 ...
- Hadoop基础-MapReduce的数据倾斜解决方案
Hadoop基础-MapReduce的数据倾斜解决方案 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.数据倾斜简介 1>.什么是数据倾斜 答:大量数据涌入到某一节点,导致 ...
- Spark性能优化之道——解决Spark数据倾斜(Data Skew)的N种姿势
原创文章,同步首发自作者个人博客转载请务必在文章开头处注明出处. 摘要 本文结合实例详细阐明了Spark数据倾斜的几种场景以及对应的解决方案,包括避免数据源倾斜,调整并行度,使用自定义Partitio ...
- 实战 | Hive 数据倾斜问题定位排查及解决
Hive 数据倾斜怎么发现,怎么定位,怎么解决 多数介绍数据倾斜的文章都是以大篇幅的理论为主,并没有给出具体的数据倾斜案例.当工作中遇到了倾斜问题,这些理论很难直接应用,导致我们面对倾斜时还是不知所措 ...
随机推荐
- 【DB2】Event monitor for locking
Customer said, they got the following Errors in applications logs Caused by: financing.tools.hub.sha ...
- Spring Cloud Zuul 网关使用与 OAuth2.0 认证授权服务
API 网关的出现的原因是微服务架构的出现,不同的微服务一般会有不同的服务地址,而外部客户端可能需要调用多个服务的接口才能完成一个业务需求,如果让客户端直接与各个微服务通信,会有以下的问题: 客户端会 ...
- RC1015 cannot open include file 'atlres.h'
fatal error RC1015: cannot open include file 'atlres.h' 问题:此问题是由于rc文件没有找到 atlres.h导致的 (原因不详) 解决:工程 ...
- jq通过对象获取其ID值,再简单ajax传到后台改值
<tbody> <tr> <#if scopes?exists> <#list scopes as scopes> <td id='${(scop ...
- Facelets应用程序的生命周期
当客户端(如浏览器)向使用Facelets创建的页面发出新的请求时,会创建一个新的组件树或 javax.faces.component.UIViewRoot将其创建并放入FacesContext. 该 ...
- apache log4j打印日志源码出口
Throwable.class: public void printStackTrace(PrintStream s) { synchronized (s) { s.println(this); St ...
- 用Redis作Mysql数据库缓存
使用redis作mysql数据库缓存时,需要考虑两个问题: 1.确定用何种数据结构存储来自Mysql的数据; 2.在确定数据结构之后,用什么标识作为该数据结构的键. 直观上看,Mysql中的数据都是按 ...
- #6 Python数据类型及运算
前言 前文讲述了Python的输入输出以及变量的相关知识点,本节将探讨Python的数据类型以及数据之间的运算方式! 一.Python数据类型 上一节弄清了变量,其实变量所指向的值是有自己独特的数据类 ...
- C# ListView解读
一.ListView类 1.常用的基本属性: (1)FullRowSelect:设置是否行选择模式.(默认为false) 提示:只有在Details视图该属性才有意义. (2) GridLines:设 ...
- KM算法及其应用
在二分图匹配中有最大匹配问题,使用匈牙利算法或者网络流相关算法解决,如果给每条边增加一个权值,求权值和最大的匹配方案就叫做最大权匹配问题.其实之前所说的最大匹配就是权值为1的最大权匹配. 求最大权完备 ...