
(数据科学学习手札138)使用sklearnex大幅加速scikit-learn运算
本文示例代码已上传至我的
Github仓库https://github.com/CNFeffery/DataScienceStudyNotes
1 简介
大家好我是费老师,scikit-learn作为经典的机器学习框架,从诞生至今已发展了十余年,但其运算速度一直广受用户的诟病。熟悉scikit-learn的朋友应该清楚,scikit-learn中自带的一些基于joblib等库的运算加速功能效果有限,并不能很充分地利用算力。
而今天我要给大家介绍的知识,可以帮助我们在不改变原有代码的基础上,获得数十倍甚至上千倍的scikit-learn运算效率提升,let's go!
2 利用sklearnex加速scikit-learn
为了达到加速运算的效果,我们只需要额外安装sklearnex这个拓展库,就可以帮助我们在拥有intel处理器的设备上,获得大幅度的运算效率提升。
抱着谨慎尝鲜的态度,我们可以在单独的conda虚拟环境中做实验,全部命令如下,我们顺便安装jupyterlab作为IDE:
conda create -n scikit-learn-intelex-demo python=3.8 -c https://mirrors.sjtug.sjtu.edu.cn/anaconda/pkgs/main -y

conda activate scikit-learn-intelex-demo

pip install scikit-learn scikit-learn-intelex jupyterlab -i https://pypi.douban.com/simple/
完成实验环境的准备后,我们在jupyter lab中编写测试用代码来看看加速效果如何,使用方式很简单,我们只需要在代码中导入scikit-learn相关功能模块之前,运行下列代码即可:
from sklearnex import patch_sklearn, unpatch_sklearn

patch_sklearn()
成功开启加速模式后会打印以下信息:
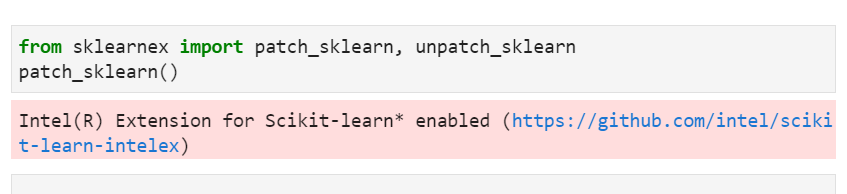
其他要做的仅仅是将你原本的scikit-learn代码在后面继续执行即可,我在自己平时写作以及开发开源项目的老款拯救者笔记本上简单测试了一下。
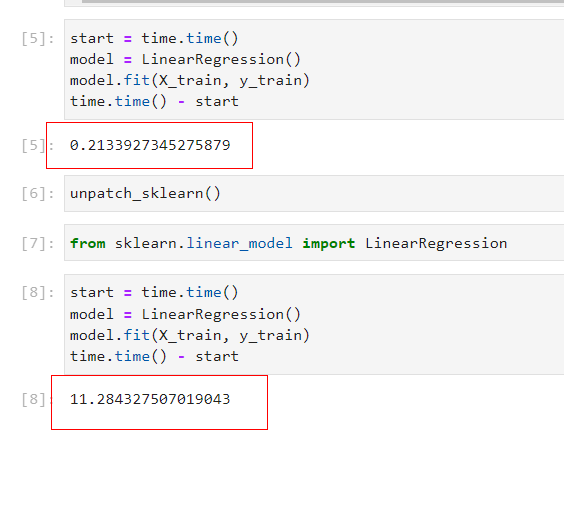
以线性回归为例,在百万级别样本量以及上百个特征的示例数据集上,开启加速后仅耗时0.21秒就完成对训练集的训练,而使用unpatch_sklearn()强制关闭加速模式后(注意scikit-learn相关模块需要重新导入),训练耗时随即上升到11.28秒,意味着通过sklearnex我们获得了50多倍的运算速度提升!
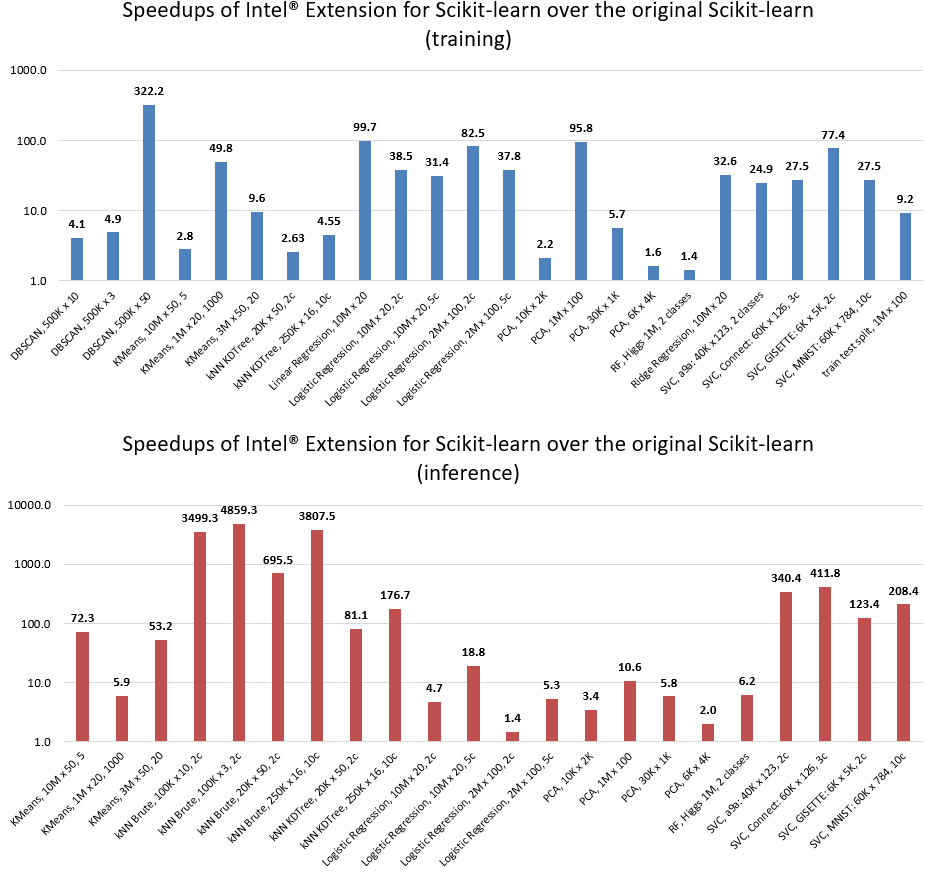
而按照官方的说法,越强劲的CPU可以获得的性能提升比例也会更高,下图是官方在Intel Xeon Platinum 8275CL处理器下测试了一系列算法后得出的性能提升结果,不仅可以提升训练速度,还可以提升模型推理预测速度,在某些场景下甚至达到数千倍的性能提升:
官方也提供了一些ipynb示例(https://github.com/intel/scikit-learn-intelex/tree/master/examples/notebooks),展示了包含K-means、DBSCAN、随机森林、逻辑回归、岭回归等多种常用算法示例,感兴趣的读者朋友们可以自行下载学习。
以上就是本文的全部内容,欢迎在评论区与我进行讨论~
(数据科学学习手札138)使用sklearnex大幅加速scikit-learn运算的更多相关文章
- (数据科学学习手札86)全平台支持的pandas运算加速神器
本文示例代码已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 随着其功能的不断优化与扩充,pandas已然成为 ...
- (数据科学学习手札55)利用ggthemr来美化ggplot2图像
一.简介 R中的ggplot2是一个非常强大灵活的数据可视化包,熟悉其绘图规则后便可以自由地生成各种可视化图像,但其默认的色彩和样式在很多时候难免有些过于朴素,本文将要介绍的ggthemr包专门针对原 ...
- (数据科学学习手札50)基于Python的网络数据采集-selenium篇(上)
一.简介 接着几个月之前的(数据科学学习手札31)基于Python的网络数据采集(初级篇),在那篇文章中,我们介绍了关于网络爬虫的基础知识(基本的请求库,基本的解析库,CSS,正则表达式等),在那篇文 ...
- (数据科学学习手札49)Scala中的模式匹配
一.简介 Scala中的模式匹配类似Java中的switch语句,且更加稳健,本文就将针对Scala中模式匹配的一些基本实例进行介绍: 二.Scala中的模式匹配 2.1 基本格式 Scala中模式匹 ...
- (数据科学学习手札47)基于Python的网络数据采集实战(2)
一.简介 马上大四了,最近在暑期实习,在数据挖掘的主业之外,也帮助同事做了很多网络数据采集的内容,接下来的数篇文章就将一一罗列出来,来续写几个月前开的这个网络数据采集实战的坑. 二.马蜂窝评论数据采集 ...
- (数据科学学习手札44)在Keras中训练多层感知机
一.简介 Keras是有着自主的一套前端控制语法,后端基于tensorflow和theano的深度学习框架,因为其搭建神经网络简单快捷明了的语法风格,可以帮助使用者更快捷的搭建自己的神经网络,堪称深度 ...
- (数据科学学习手札42)folium进阶内容介绍
一.简介 在上一篇(数据科学学习手札41)中我们了解了folium的基础内容,实际上folium在地理信息可视化上的真正过人之处在于其绘制图像的高度可定制化上,本文就将基于folium官方文档中的一些 ...
- (数据科学学习手札40)tensorflow实现LSTM时间序列预测
一.简介 上一篇中我们较为详细地铺垫了关于RNN及其变种LSTM的一些基本知识,也提到了LSTM在时间序列预测上优越的性能,本篇就将对如何利用tensorflow,在实际时间序列预测任务中搭建模型来完 ...
- (数据科学学习手札36)tensorflow实现MLP
一.简介 我们在前面的数据科学学习手札34中也介绍过,作为最典型的神经网络,多层感知机(MLP)结构简单且规则,并且在隐层设计的足够完善时,可以拟合任意连续函数,而除了利用前面介绍的sklearn.n ...
随机推荐
- c++对c的拓展_函数的引用
注意:1.引用可作为形参较指针更为直观 2可作为返回值 (判断标准:空间是否释放) #include <iostream> #include <stdlib.h> using ...
- springboot静态资源无法访问
前言 今天使用springboot+layui+shiro实现一个前后端分离的商城后台系统,一个小小静态资源(image)问题搞了一下午:还好坚持了下来,否者崩溃.吐血都是小事 这是引入的路径 这是图 ...
- Django + Taro 前后端分离项目实现企业微信登录
前言 还是最近在做的一个小项目,后端用的是Django搭配RestFramework做接口,前端第一次尝试用京东开源的Taro框架来做多端(目前需要做用于企业微信的H5端和微信小程序) 本文记录一下企 ...
- findmnt、lsblk、mount 命令查看磁盘、目录挂载、挂载点以及文件系统格式等情况
findmnt 展示出了目标挂载点( TARGET ).源设备( SOURCE ).文件系统类型( FSTYPE )以及相关的挂载选项( OPTIONS ),例如文件系统是否是可读可写或者只读的.根( ...
- hashlib加密模块、logging日志模块
hashlib模块 加密:将明文数据通过一系列算法变成密文数据 目的: 就是为了数据的安全 基本使用 基本使用 import hashlib # 1.先确定算法类型(md5普遍使用) md5 = ha ...
- js中的undefined
undefined,一个特殊值,通常用于指示变量尚未赋值,是一个JavaScript的 原始数据类型 . 如果后台返回前台数据为空(无数据),那么用该对象获取其中的属性会显示undefined. 如果 ...
- Git上传本地仓库文件到Gitee(Github同理)
前言:本来想把最近的代码更新到Github上,但是校园网打不开,于是决定暂时先更新到Gitee中,Github中的操作也同理. 1. 创建云仓库: 就是在Gitee/Github上创建仓库,这里不演示 ...
- SVG 和 CSS3 实现一个超酷爱心 Like 按钮
在现代网页中,我们经常可以在一些文章.视频和图片页面上找到"Like"按钮,并且通过点击该按钮来表示自己对该内容的喜欢或者不喜欢.大部分"Like"按钮是纯文本 ...
- 观察者模式与Google Guava EventBus实现
概述 观察者模式又被称为发布-订阅(Publish/Subscribe)模式,属于行为型模式的一种. 它定义了一种一对多的依赖关系,让多个观察者对象同时监听某一个主题对象.这个主题对象在状态变化时,会 ...
- Nacos在企业生产中如何使用集群环境?
点赞再看,养成习惯,微信搜索[牧小农]关注我获取更多资讯,风里雨里,小农等你,很高兴能够成为你的朋友. 项目源码地址:公众号回复 nacos,即可免费获取源码 前言 由于在公司,注册中心和配置中心都是 ...