
python反爬虫解决方法——模拟浏览器上网
之前第一次练习爬虫的时候看网上的代码有些会设置headers,然后后面的东西我又看不懂,今天终于知道了原来这东西是用来模拟浏览器上网用的,因为有些网站会设置反爬虫机制,所以如果要获取内容的话,需要使用浏览器上网才可以。
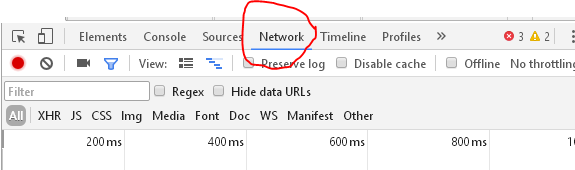
获取headers的方法很简单,首先打开审查元素界面,有个Network选项,点进去会显示如下:
接下来刷新一下:
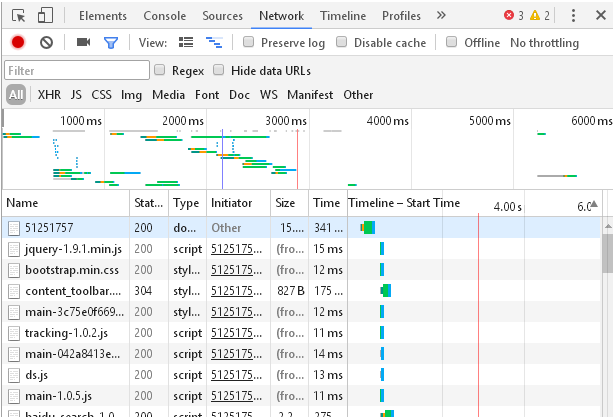
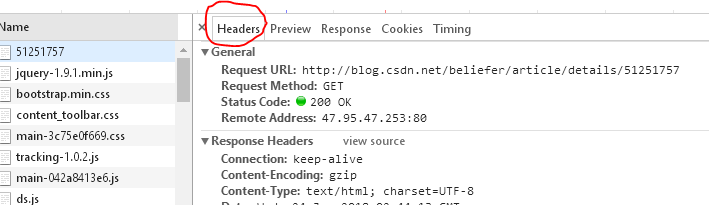
点击第一个5151757后右边会显示Headers选项,我们所需要的就在这个选项卡里面:
在最后面就有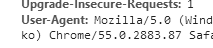 这样的一个信息,这就是我们所需要的。
 from urllib import request

 url = "http://blog.csdn.net/beliefer/article/details/51251757"

 header = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}

 req = request.Request(url, headers = header)

 text = request.urlopen(req).read().decode()

 print(text)
这样就能成功的爬取到网页信息了。
python反爬虫解决方法——模拟浏览器上网的更多相关文章
- python爬虫:使用Selenium模拟浏览器行为
前几天有位微信读者问我一个爬虫的问题,就是在爬去百度贴吧首页的热门动态下面的图片的时候,爬取的图片总是爬取不完整,比首页看到的少.原因他也大概分析了下,就是后面的图片是动态加载的.他的问题就是这部分动 ...
- 大型企业都在用的Python反爬虫手段,破了它!
SVG 映射反爬虫 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做案例的人,却不知道如何去学习更加高深的知识.那么针对这三类人 ...
- 编程中遇到的Python错误和解决方法汇总整理
这篇文章主要介绍了自己编程中遇到的Python错误和解决方法汇总整理,本文收集整理了较多的案例,需要的朋友可以参考下 开个贴,用于记录平时经常碰到的Python的错误同时对导致错误的原因进行分析, ...
- Python网络爬虫实战(四)模拟登录
对于一个网站的首页来说,它可能需要你进行登录,比如知乎,同一个URL下,你登录与未登录当然在右上角个人信息那里是不一样的. (登录过) (未登录) 那么你在用爬虫爬取的时候获得的页面究竟是哪个呢? 肯 ...
- python pip安装解决方法
一招解决python pip install 安装库失败 PIP是python强大的安装利器,但是我们经常遇到安装库失败的问题,以下本人觉得最有效的解决方法: 1.打开 https://www.l ...
- python 反爬虫策略
1.限制IP地址单位时间的访问次数 : 分析:没有哪个常人一秒钟内能访问相同网站5次,除非是程序访问,而有这种喜好的,就剩下搜索引擎爬虫和讨厌的采集器了. 弊端:一刀切,这同样会阻止搜索引擎对网站的收 ...
- 首次安装Pycharm出现No Python interpreter selected解决方法
刚装完Pycharm,新建Project的时候,出现了No Python interpreter selected.网上的教程里path interpret栏里应该选中python.exe,但是我搜遍 ...
- 引入less报错解决方法以及浏览器设计不同的地方
XMLHttpRequest cannot load file:///C:/Users/PAXST/Desktop/805/first.less. Cross origin requests are ...
- python一些模块的exe安装包在windows的64位系统里识别不到已安装Python目录的解决方法
在windows里安装python一些模块时候,有时候源码安装比较困难,pip install也各种报错,这时候最喜欢用别人编译好的exe或者whl文件来安装,但是在windows的64位系统里,如果 ...
随机推荐
- 使用Oozie中workflow的定时任务重跑hive数仓表的历史分期调度
在数仓和BI系统的开发和使用过程中会经常出现需要重跑数仓中某些或一段时间内的分区数据,原因可能是:1.数据统计和计算逻辑/口径调整,2.发现之前的埋点数据收集出现错误或者埋点出现错误,3.业务数据库出 ...
- <转>jmeter(三)SOAP/XML-RPC Request
本博客转载自:http://www.cnblogs.com/imyalost/category/846346.html 个人感觉不错,对jmeter讲解非常详细,担心以后找不到了,所以转发出来,留着慢 ...
- windows WTL使用命令行参数
两中方法: 第一种: int WINAPI _tWinMain(HINSTANCE hInstance, HINSTANCE /*hPrevInstance*/, LPTSTR lpstrCmdLin ...
- yield的理解
yield的理解:yield命令是异步两个阶段的分界线需要先对迭代器和生成器进行理解: 迭代器:是一种支持next()操作的对象.它包含一组元素,当执行next()时,返回其中一个元素:当所有元素都被 ...
- N-Gram的基本原理
1.N-Gram的介绍 N-Gram是基于一个假设:第n个词出现与前n-1个词相关,而与其他任何词不相关(这也是隐马尔可夫当中的假设).整个句子出现的概率就等于各个词出现的概率乘积.各个词的概率可以通 ...
- JS笔记—02
1.String截取:substr:截几位, substring:截到哪. 2.String的操作,例如变大写,小写,本身不会变,只是在栈里交换引用似的 var str = "hello w ...
- Solr基本操作
/update 使用/update进行索引维护,进入Solr管理界面SolrCore下的Document下: 我们进行更新操作可以用json和xml多种格式,这里以xml格式为例说明.先来看看界面上的 ...
- Codeforces 789D Weird journey - 欧拉路 - 图论
Little boy Igor wants to become a traveller. At first, he decided to visit all the cities of his mot ...
- 1. 元信息:Meta类 2. 基于对象查询的sql优化 3. 自定义:Group_Concat() 4. ajax前后台交互
一.元信息 ''' 1. 元信息 1. Model类可以通过元信息类设置索引和排序信息 2. 元信息是在Model类中定义一个Meta子类 class Meta: # 自定义表名 db_table = ...
- 一、虚拟环境.二、路由配置主页与404.三、2.x路由分发.四、伪静态.五、request对象.六、FBV与CBV.七、文件上传.
一.虚拟环境 ''' 解决版本共存 1. 用pycharm选择File点击NewProject然后选择virtualenv创建一个纯净环境 2. 打开下载的目录将venv文件夹下的所有文件(纯净的环境 ...