
HBase导入数据同时与Phoenix实现同步映射
1.HDFS上数据准备
2019-03-24 09:21:57.347,869454021315519,8,1

2019-03-24 22:07:15.513,867789020387791,8,1

2019-03-24 21:43:34.81,357008082359524,8,1

2019-03-24 16:05:32.227,860201045831206,8,1

2019-03-24 18:11:18.167,866676040163198,8,1

2019-03-24 22:01:24.877,868897026713230,8,1

2019-03-24 12:34:23.377,863119033590062,8,1

2019-03-24 20:16:32.53,862505041870010,8,1

2019-03-24 09:10:55.18,864765037658468,8,1

2019-03-24 16:18:41.503,869609023903469,8,1

2019-03-24 10:44:52.027,869982033593376,8,1

2019-03-24 20:00:08.007,866798025149107,8,1

2019-03-24 10:25:18.1,863291034398181,2,3

2019-03-24 10:33:48.56,867557030361332,8,1

2019-03-24 16:42:15.057,869841022390535,8,1

2019-03-24 10:08:00.277,867574031105048,8,1
注意: 分隔符是‘,’
2. HBase上创建表
create 'ALLUSER','INFO';
3. 在Phoenix中建立相同的表名以实现与hbase表的映射
create table if not exists ALLUSER(

    firsttime varchar primary key,

    INFO.IMEI varchar,

    INFO.COID varchar,

    INFO.NCOID varchar

)
注意:
- 除主键外,Phoenix表的表名和字段字段名要和HBase表中相同,包括大小写
- Phoneix中的column必须以HBase的columnFamily开头
4. 通过importtsv.separator指定分隔符,否则默认的分隔符是tab键
hbase org.apache.hadoop.hbase.mapreduce.ImportTsv \

-Dimporttsv.columns=HBASE_ROW_KEY,INFO:IMEI,INFO:IMEI,INFO:NCOID \

-Dimporttsv.separator=, -Dimporttsv.bulk.output=/warehouse/temp/alluser ALLUSER /user/hive/warehouse/toutiaofeedback.db/newuser/000001_0
5. 将生成的HFlie导入到HBase
hbase org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles /warehouse/temp/alluser ALLUSER
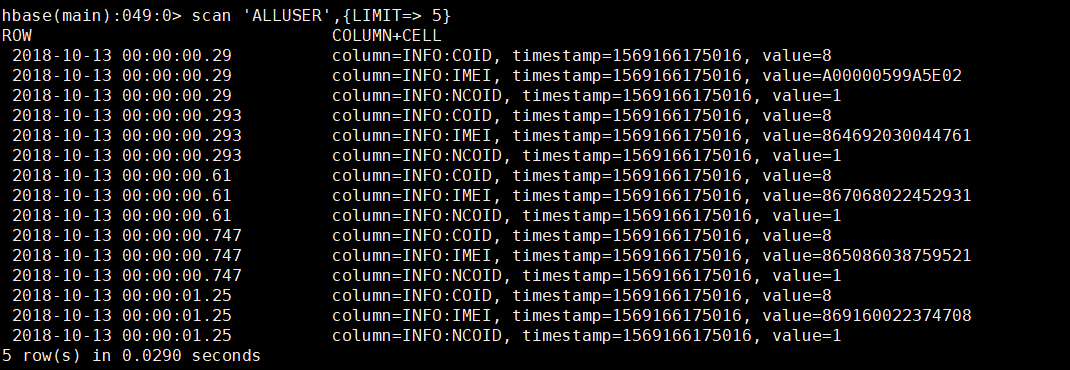
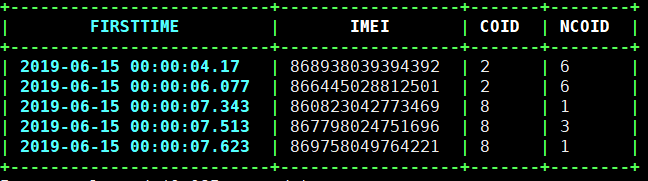
6. 查看HBase,Phoenix
查看HBase
查看Phoenix
HBase导入数据同时与Phoenix实现同步映射的更多相关文章
- Phoneix(四)hbase导入数据同时与phoenix实现映射同步
一.说明 先创建一个hbase表格,能够导入本地数据到hbase中,最后能够通过phoneix进行访问. 1.数据准备(10W条,样例如下),文件test.txt 0,20190520164020,1 ...
- 使用sqoop工具从oracle导入数据
sqoop工具是hadoop下连接关系型数据库和Hadoop的桥梁,支持关系型数据库和hive.hdfs,hbase之间数据的相互导入,可以使用全表导入和增量导入 从RDBMS中抽取出的数据可以被Ma ...
- sqoop工具从oracle导入数据2
sqoop工具从oracle导入数据 sqoop工具是hadoop下连接关系型数据库和Hadoop的桥梁,支持关系型数据库和hive.hdfs,hbase之间数据的相互导入,可以使用全表导入和增量导入 ...
- 通过phoenix导入数据到hbase出错记录
解决方法1 错误如下 -- ::, [hconnection-0x7b9e01aa-shared--pool11069-t114734] WARN org.apache.hadoop.hbase.ip ...
- 使用Sqoop从MySQL导入数据到Hive和HBase 及近期感悟
使用Sqoop从MySQL导入数据到Hive和HBase 及近期感悟 Sqoop 大数据 Hive HBase ETL 使用Sqoop从MySQL导入数据到Hive和HBase 及近期感悟 基础环境 ...
- hbase批量数据导入报错:NotServingRegionException
批量导入数据到hbase的时候,报错: org.apache.hadoop.hbase.client.RetriesExhaustedWithDetailsException: Failed 1 ac ...
- HBase 实战(1)--HBase的数据导入方式
前言: 作为Hadoop生态系统中重要的一员, HBase作为分布式列式存储, 在线实时处理的特性, 备受瞩目, 将来能在很多应用场景, 取代传统关系型数据库的江湖地位. 本篇博文重点讲解HBase的 ...
- HBase(三): Azure HDInsigt HBase表数据导入本地HBase
目录: hdfs 命令操作本地 hbase Azure HDInsight HBase表数据导入本地 hbase hdfs命令操作本地hbase: 参见 HDP2.4安装(五):集群及组件安装 , ...
- sqoop:mysql和Hbase/Hive/Hdfs之间相互导入数据
1.安装sqoop 请参考http://www.cnblogs.com/Richardzhu/p/3322635.html 增加了SQOOP_HOME相关环境变量:source ~/.bashrc ...
随机推荐
- poium测试库之JavaScript API封装原理
poium一直我在维护的一个开源项目,它的定位是以极简的方式在自动化项目中Page Objects设计模式.我在之前的文章中也有介绍. 本篇文章主要介绍一个JavaScript元素操作的封装原理. 为 ...
- 池化层的back proporgation 原理
转载:https://www.jianshu.com/p/6928203bf75b
- C#编写dll进行sql server数据库扩展储存过程
一.编写C#函数文件 1.新建一个类库文件 备注:sqlserver 2008只能用.net3.5版本. 2.如有想加入强命名的话可如下步骤: 参考博文:https://blog.csdn.net/d ...
- hibernate 报错com.mysql.jdbc.exceptions.jdbc4.MySQLSyntaxErrorException
解释:JavaBean的主键类型只能是int类型,因为在映射关系配置是自动增长的,String类型是不能自动增长的,所以会报错.
- CodeForces 909C
题意略. 思路: 开始的时候,定义dp[i]:当前行在第i行,i~n有多少种排列方式,如果i为f,那么dp[i] = dp[i + 1],因为第i + 1条语句只能放在f后且向右缩进一位: 如果i为s ...
- (七)分布式通信----Netty实现NIO通信
目录 1. 消息监听器 2. 指令执行器 3. 消息发送器 4. 客户端工厂 5. 序列化工具 6. 通信主机 项目文件结构图 通信主机: 1. 消息监听器(黄色框) 这部分由 Netty 实现,Ne ...
- linux命令名 用法及参数 功能注解
命令名 用法及参数 功能注解 1 文件管理 # ls ls -a 列出当前目录下的所有文件,包括以.头的隐含文件 文件管理 # l ...
- Unity进阶:PlayMaker
版权申明: 本文原创首发于以下网站: 博客园『优梦创客』的空间:https://www.cnblogs.com/raymondking123 优梦创客的官方博客:https://91make.top ...
- Keras 实例 MNIST
import numpy from keras.datasets import mnist from keras.models import Sequential from keras.layers ...
- CodeForces-714B-Filya and Homework+思路
Filya and Homework 题意: 给定一串数字,任选一个数a,把若干个数加上a,把若干个数减去a,能否使得数列全部相同: 思路: 我开始就想找出平均数,以为只有和偶数的可以,结果wa在 1 ...