
ELK快速入门(三)logstash收集日志写入redis
ELK快速入门三-logstash收集日志写入redis
用一台服务器部署redis服务,专门用于日志缓存使用,一般用于web服务器产生大量日志的场景。
这里是使用一台专门用于部署redis ,一台专门部署了logstash,在linux-elk1ELK集群上面进行日志收集存到了redis服务器上面,然后通过专门的logstash服务器去redis服务器里面取出数据在放到kibana上面进行展示
部署redis
下载安装redis
[root@linux-redis ~]# wget http://download.redis.io/releases/redis-5.0.0.tar.gz

[root@linux-redis ~]# tar -xvzf redis-5.0..tar.gz

[root@linux-redis ~]# mv redis-5.0. /usr/local/src/

[root@linux-redis ~]# ln -sv /usr/local/src/redis-5.0. /usr/local/redis

"/usr/local/redis" -> "/usr/local/src/redis-5.0.0"

[root@linux-redis ~]# cd /usr/local/redis/

[root@linux-redis ~]# make distclean

[root@linux-redis ~]# make
配置redis
[root@linux-redis redis]# vim redis.conf

daemonize yes

bind 192.168.1.30

requirepass

[root@linux-redis redis]# cp /usr/local/redis/src/redis-server /usr/bin/

[root@linux-redis redis]# cp /usr/local/redis/src/redis-cli /usr/bin/

[root@linux-redis redis]# redis-server /usr/local/redis/redis.conf

:C  Jul  ::30.367 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo

:C  Jul  ::30.367 # Redis version=5.0., bits=, commit=, modified=, pid=, just started

:C  Jul  ::30.367 # Configuration loaded

[root@linux-redis redis]# netstat -nlutp |grep

tcp               192.168.1.30:       0.0.0.0:*               LISTEN      /redis-server
测试redis
[root@linux-redis redis]# redis-cli -h 192.168.1.30

192.168.1.30:> AUTH

OK

192.168.1.30:> ping

PONG

192.168.1.30:> KEYS *

(empty list or set)

192.168.1.30:> quit
配置logstash将日志写入redis
将系统日志的通过logstash收集之后写入redis,然后通过另外的logstash将redis服务器的数据取出来。
配置logstash的配置文件
[root@linux-elk1 ~]# vim /etc/logstash/conf.d/system.conf

input {

    file {

        path => "/var/log/messages"

        type => "systemlog"

        start_position => "beginning"

        stat_interval => ""

    }

}

output {

    if [type] == "systemlog" {

        redis {

            data_type => "list"

            host => "192.168.1.30"

            password => ""

            port => ""

            db => ""

            key => "systemlog"

        }

    }

}
检查logstash配置语法是否正确
[root@linux-elk1 ~]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/system.conf -t

WARNING: Could not find logstash.yml which is typically located in $LS_HOME/config or /etc/logstash. You can specify the path using --path.settings. Continuing using the defaults

Could not find log4j2 configuration at path /usr/share/logstash/config/log4j2.properties. Using default config which logs errors to the console

[WARN ] -- ::46.324 [LogStash::Runner] multilocal - Ignoring the 'pipelines.yml' file because modules or command line options are specified

Configuration OK

[root@linux-elk1 ~]# systemctl restart logstash
写入messages日志测试
[root@linux-elk1 ~]# echo "redis-test" >> /var/log/messages

[root@linux-elk1 ~]# echo "systemlog" >> /var/log/messages
登录redis进行查看
[root@linux-redis ~]# redis-cli -h 192.168.1.30

192.168.1.30:> AUTH

OK

192.168.1.30:> SELECT

OK

192.168.1.30:> KEYS *

) "systemlog"

192.168.1.30:> LLEN systemlog

(integer)
配置logstash从redis中取出数据到elasticsearch
配置专门logstash服务器从redis服务器读取指定的key的数据,并写入到elasticsearch
编辑logstash配置文件
[root@logstash ~]# vim /etc/logstash/conf.d/redis-read.conf

input {

    redis {

        data_type => "list"

        host => "192.168.1.30"

        password => ""

        port => ""

        db => ""

        key => "systemlog"

    }

}

output {

    elasticsearch {

        hosts => ["192.168.1.31:9200"]

        index => "redis-systemlog-%{+YYYY.MM.dd}"

    }

}
测试logstash配置是否正确
[root@logstash ~]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/redis-read.conf -t

OpenJDK -Bit Server VM warning: If the number of processors is expected to increase from one, then you should configure the number of parallel GC threads appropriately using -XX:ParallelGCThreads=N

WARNING: Could not find logstash.yml which is typically located in $LS_HOME/config or /etc/logstash. You can specify the path using --path.settings. Continuing using the defaults

Could not find log4j2 configuration at path /usr/share/logstash/config/log4j2.properties. Using default config which logs errors to the console

[INFO ] -- ::50.576 [main] writabledirectory - Creating directory {:setting=>"path.queue", :path=>"/usr/share/logstash/data/queue"}

[INFO ] -- ::50.649 [main] writabledirectory - Creating directory {:setting=>"path.dead_letter_queue", :path=>"/usr/share/logstash/data/dead_letter_queue"}

[WARN ] -- ::51.498 [LogStash::Runner] multilocal - Ignoring the 'pipelines.yml' file because modules or command line options are specified

Configuration OK

[root@logstash ~]# systemctl restart logstash
验证redis的数据是否被取出
[root@linux-redis ~]# redis-cli -h 192.168.1.30

192.168.1.30:> AUTH

OK

192.168.1.30:> SELECT

OK

192.168.1.30:> KEYS *

(empty list or set)     #这里数据已经为空

192.168.1.30:> SELECT

OK

192.168.1.30:[]> KEYS *

(empty list or set)     #这里数据已经为空
head插件上验证数据

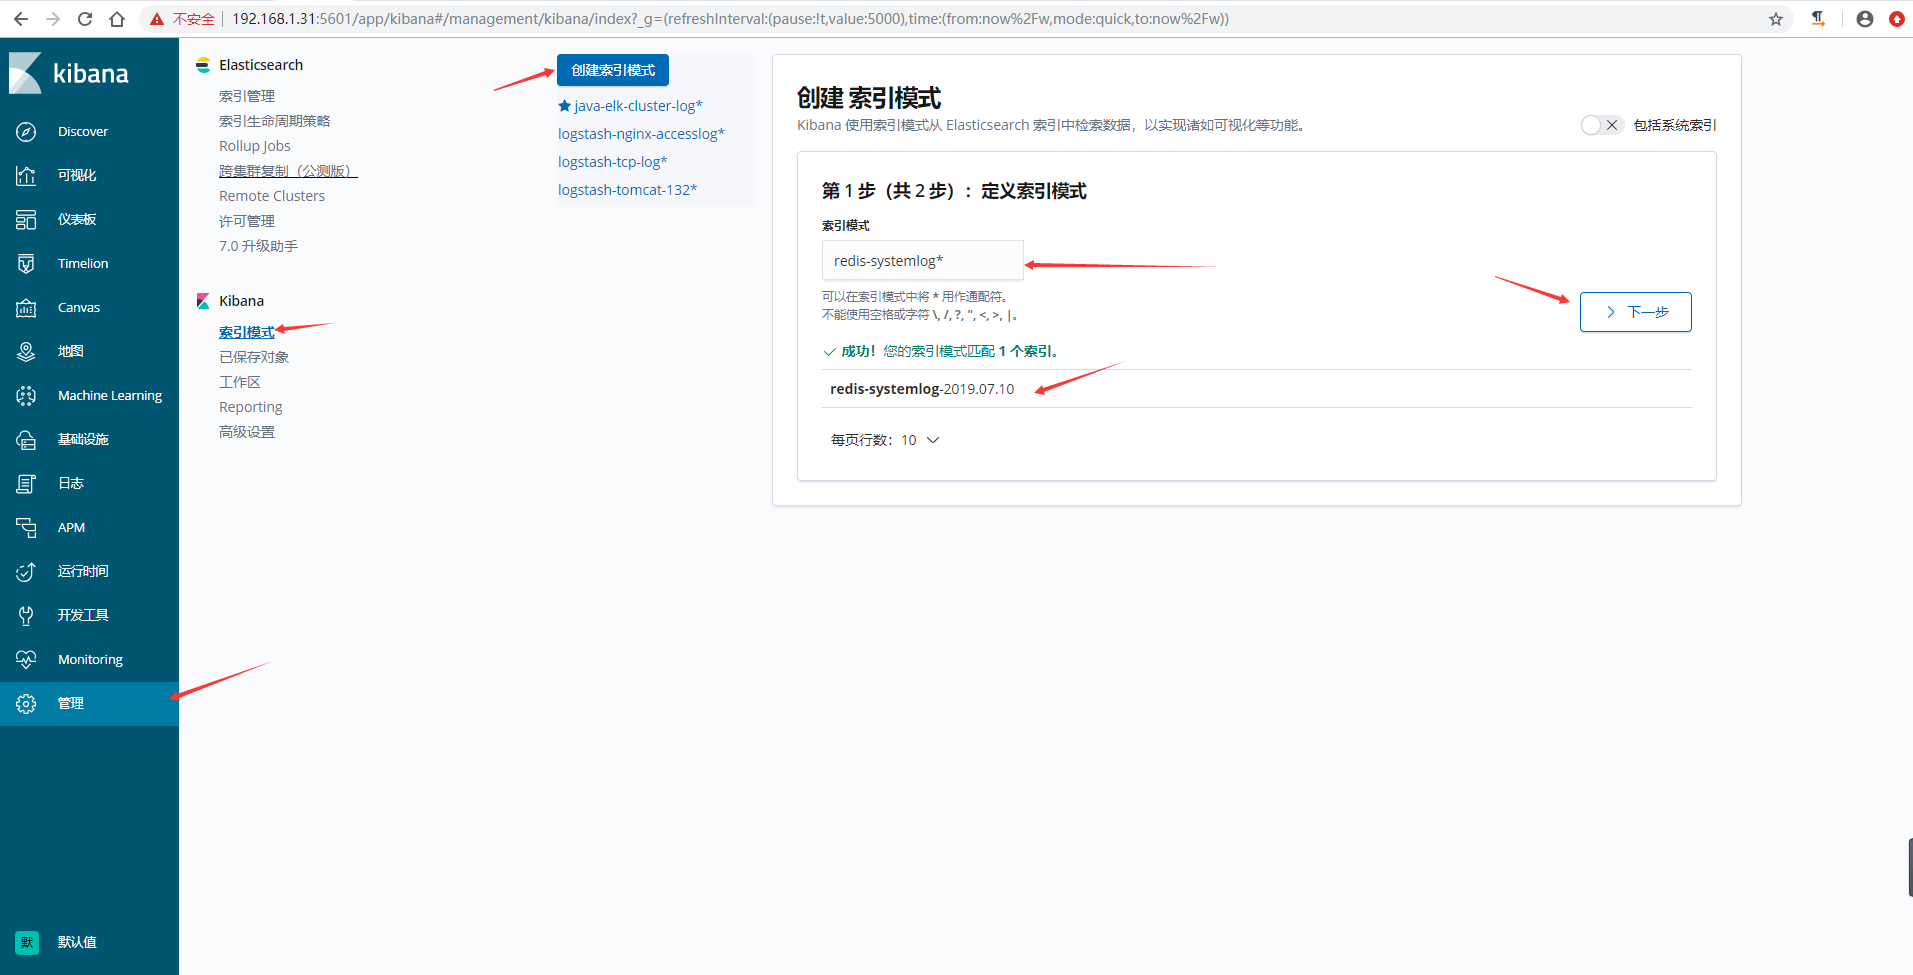
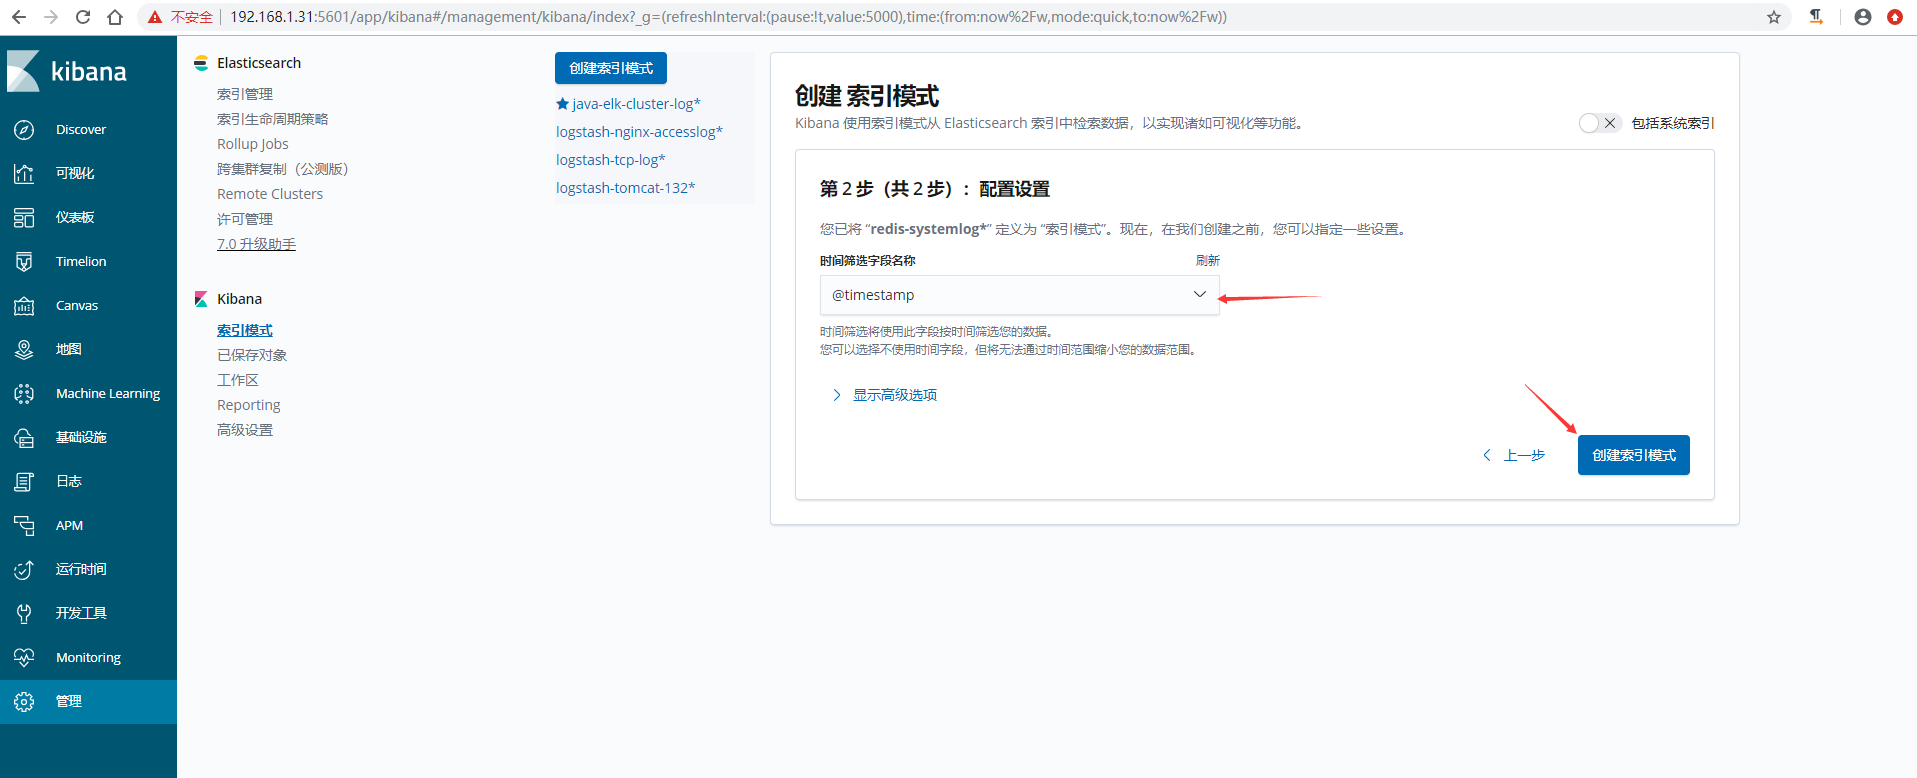
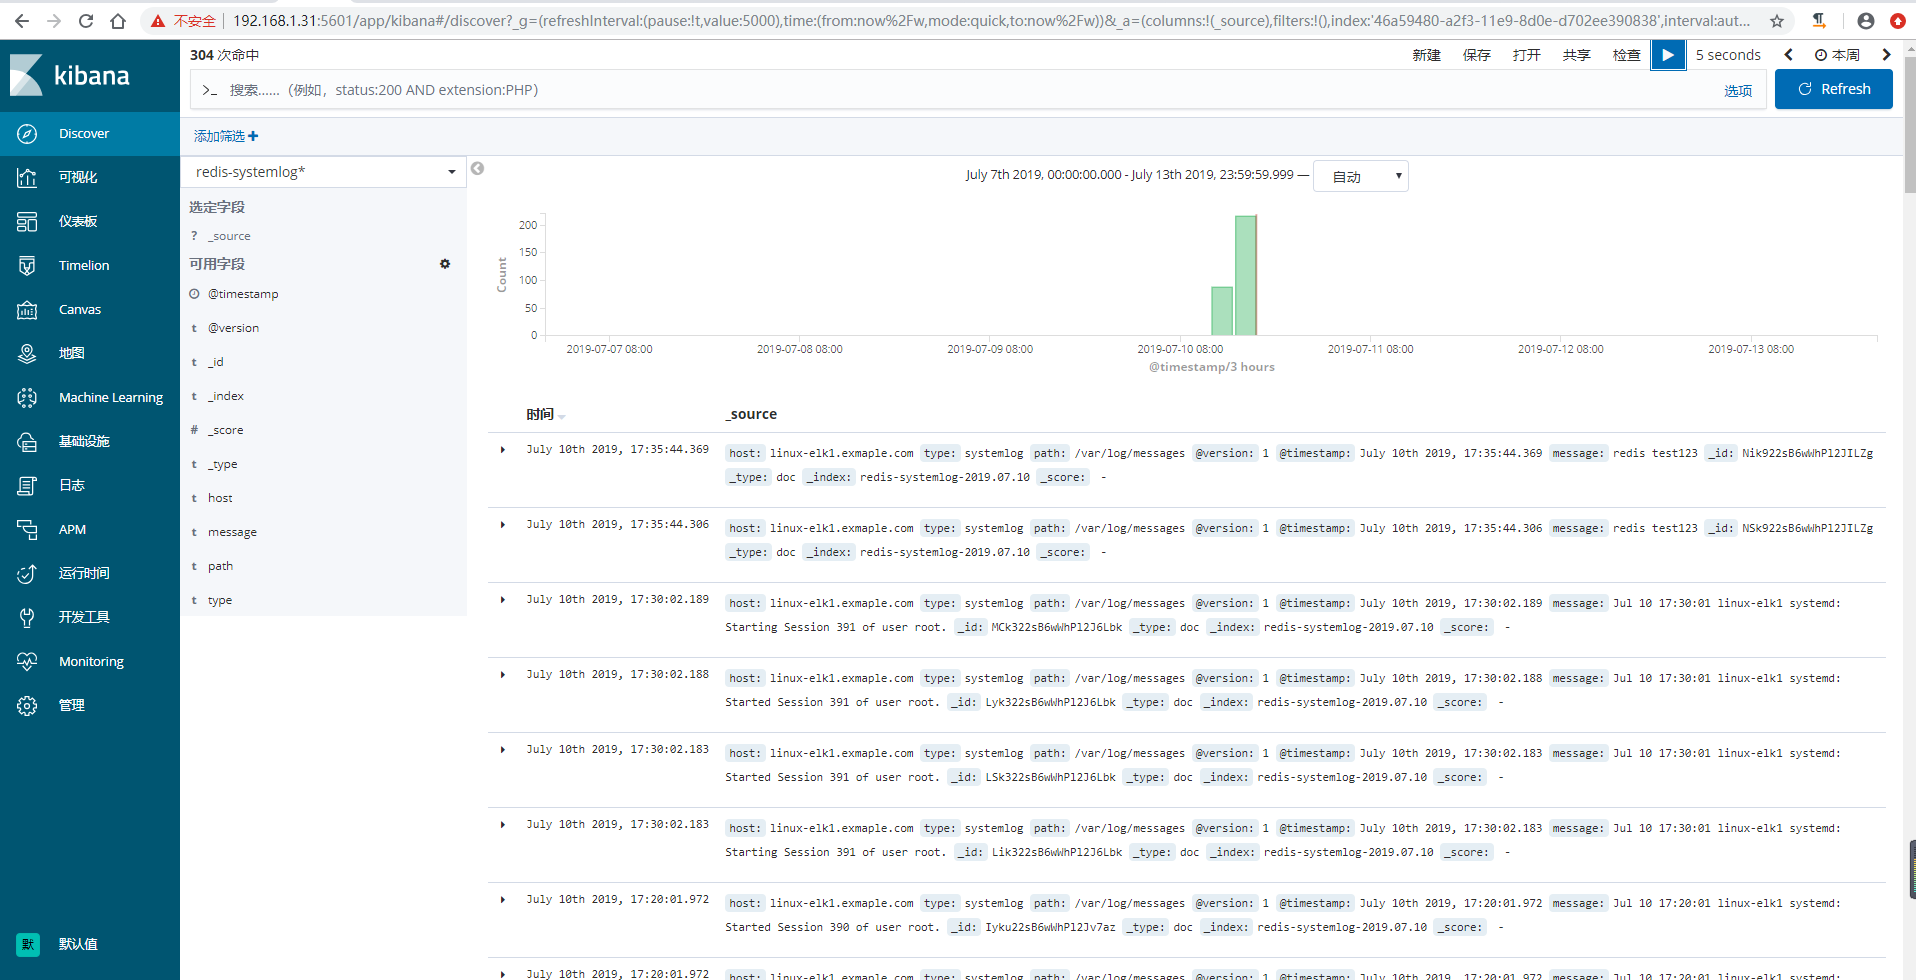
kibana界面创建索引模式并查看数据
ELK快速入门(三)logstash收集日志写入redis的更多相关文章
- ELKStack入门篇(三)之logstash收集日志写入redis
1.部署Redis 1.1.下载redis [root@linux-node2 ~]# wget http://download.redis.io/releases/redis-4.0.6.tar.g ...
- ELK之logstash收集日志写入redis及读取redis
logstash->redis->logstash->elasticsearch 1.安装部署redis cd /usr/local/src wget http://download ...
- ELK之filebeat替代logstash收集日志
filebeat->redis->logstash->elasticsearch 官网下载地址:https://www.elastic.co/downloads/beats/file ...
- ELK 使用filebeat替代Logstash收集日志
使用beats采集日志 之前也介绍过beats是ELK体系中新增的一个工具,它属于一个轻量的日志采集器,以上我们使用的日志采集工具是logstash,但是logstash占用的资源比较大,没有beat ...
- ELK快速入门(二)通过logstash收集日志
ELK快速入门二-通过logstash收集日志 说明 这里的环境接着上面的ELK快速入门-基本部署文章继续下面的操作. 收集多个日志文件 1)logstash配置文件编写 [root@linux-el ...
- ELK快速入门(四)filebeat替代logstash收集日志
ELK快速入门四-filebeat替代logstash收集日志 filebeat简介 Filebeat是轻量级单用途的日志收集工具,用于在没有安装java的服务器上专门收集日志,可以将日志转发到log ...
- ELK快速入门(一)基本部署
ELK快速入门一-基本部署 ELK简介 什么是ELK?通俗来讲,ELK是由Elasticsearch.Logstash.Kibana 三个开源软件组成的一个组合体,这三个软件当中,每个软件用于完成不同 ...
- ELK快速入门(五)配置nginx代理kibana
ELK快速入门五-配置nginx代理kibana 由于kibana界面默认没有安全认证界面,为了保证安全,通过nginx进行代理并设置访问认证. 配置kibana [root@linux-elk1 ~ ...
- elk快速入门-Logstash
Logstash1.功能:数据输入,数据筛选,数据输出2.特性:数据来源中立性,支持众多数据源:如文件log file,指标,网站服务日志,关系型数据库,redis,mq等产生的数据3.beats:分 ...
随机推荐
- Windows快速批量删除大量文件的命令
命令分别如下: rmdir [drive:]path [/S] [/Q] del [drive:]path [/S] [/Q] 其中rmdir 与rd命令相同. /S 表示除目录本身外,还将删除指定目 ...
- Docker环境下的前后端分离项目部署与运维(六)搭建MySQL集群
单节点数据库的弊病 大型互联网程序用户群体庞大,所以架构必须要特殊设计 单节点的数据库无法满足性能上的要求 单节点的数据库没有冗余设计,无法满足高可用 单节点MySQL的性能瓶领颈 2016年春节微信 ...
- Oracle_创建自增
create sequence SEQ_ChamberMapping_ID minvalue maxvalue start with increment by nocache order; CREAT ...
- stacking method house price in kaggle top10%
整合几部分代码的汇总 隐藏代码片段 导入python数据和可视化包 导入统计相关的工具 导入回归相关的算法 导入数据预处理相关的方法 导入模型调参相关的包 读取数据 特征工程 缺失值 类别特征处理-l ...
- 关于 Keras 模型
在 Keras 中有两类主要的模型:Sequential 顺序模型 和 使用函数式 API 的 Model 类模型. 1.Sequential 顺序模型 ====>>开始使用 Keras ...
- 读《PMI 分析手册》
目录 读<PMI 分析手册> 官方 PMI 基本概况 官方制造业 PMI 官方非制造业 PMI 综合 PMI 产出指数 PMI 分析框架 PMI 与经济周期 官方 PMI 分析 参考研报 ...
- Spring的JdbcTemplate使用教程
Spring对数据库的操作在jdbc上面做了基本的封装,让开发者在操作数据库时只需关注SQL语句和查询 结果处理器,即可完成功能(当然,只使用JdbcTemplate,还不能摆脱持久层实现类的编写). ...
- 微信公众号 --- 获取access_token
获取access_token 在左侧菜单栏中也可以找到 可以一步步的进行设置 , 身份验证的时候要 注意:密码是你创建微信公众号的密码 往一步步的执行就可以了 接下来就是获取ip 白名单,进行设置 ...
- [转帖]/var/log/wtmp文件的作用
/var/log/wtmp文件的作用 https://blog.51cto.com/oldyunwei/1658778 /var/log/wtmp是一个二进制文件,记录每个用户的登录次数和持续时间 ...
- eDiary
多年过去,您经历了BBS.论坛.博客.推特.微博 ...,但在电脑的某个 角落,eDiary始终为你守护发自你内心的声音. eDiary的作用不仅仅在于写日记,您也可以用它来记流水帐.写工作日志, 记 ...