
pandas处理各类表格数据
经常遇到Python读取excel和csv还有其他各种文件的内容。json还有web端的读取还是比较简单,但是excel和csv的读写是很麻烦。这里记录了
pandas库提供的方法来实现文本内容和DataFrame的转化。
一、读取文本格式数据
首先来看一下针对不同格式的文件的读取函数:
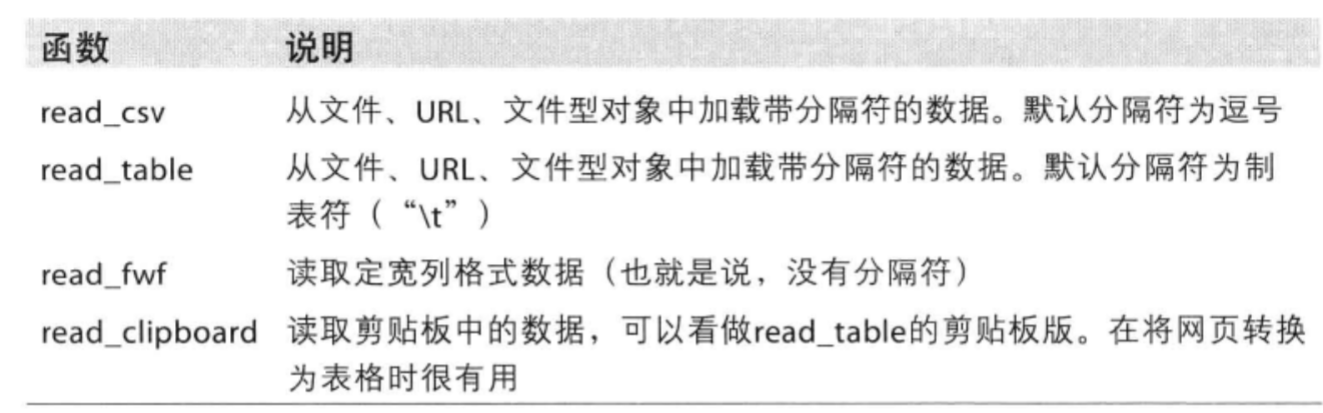
总结一下常见参数:(例子见下面代码)
| 参数 | 作用 |
|---|---|
| sep | 指定分隔符,可以是正则表达式 |
| header | 设置为None时处理没有header的文件 |
| names | 指定列 |
| index_col | 将列做成索引,可传入列表,可体现层次 |
| skiprows | 跳过注释行 |
| na_values | 接收表示缺失值的列表或字典 |
import pandas as pd

import numpy as np

import sys

import pymysql

df = pd.read_csv('ex1.csv')

print(df)
   a   b   c   d message

0  1   2   3   4   hello

1  5   6   7   8   world

2  9  10  11  12     foo
df = pd.read_table('ex1.csv',sep=',') #可以使用read_table,但必须指定分隔符

# sep还可以是正则表达式

print(df)
   a   b   c   d message

0  1   2   3   4   hello

1  5   6   7   8   world

2  9  10  11  12     foo
df = pd.read_csv('ex2.csv',header = None)#不是每一个csv都有header

print(df)
   0   1   2   3      4

0  1   2   3   4  hello

1  5   6   7   8  world

2  9  10  11  12    foo
df = pd.read_csv('ex2.csv',names=['a','b','c','d','names'])#指定名字

print(df)
   a   b   c   d  names

0  1   2   3   4  hello

1  5   6   7   8  world

2  9  10  11  12    foo
names=['a','b','c','d','names']

df = pd.read_csv('ex2.csv',names=names,index_col='names') #将names做成索引

print(df)

#names对应三个,abcd分别有对应的
       a   b   c   d

names

hello  1   2   3   4

world  5   6   7   8

foo    9  10  11  12
df = pd.read_csv('csv_mindex.csv')

print('原始样子:','\n',df)

df = pd.read_csv('csv_mindex.csv',index_col=['keys','key2'])

#层次化索引.

#请注意keys和key2的顺序

print(df)
原始样子:

   keys key2  value1  value2

0  one    a       1       2

1  one    b       3       4

2  two    a       9      10

3  two    c      13      14

           value1  value2

keys key2

one  a          1       2

     b          3       4

two  a          9      10

     c         13      14
df = pd.read_csv('ex4.csv')

print('原始样子:','\n',df)

#跳过文件的第几行

print()

df = pd.read_csv('ex4.csv',skiprows=[0,2])

print(df)
原始样子:

                                                           # hey!

a                                           b   c   d    message

# just wanted to make things more difficult NaN NaN NaN      NaN

1                                           2   NaN 4      hello

   a  b   c  d message

0  1  2 NaN  4   hello
pd.isnull(df)# 处理缺失值

df = pd.read_csv('ex4.csv',skiprows=[0,2],na_values=['hello'])# 接收一组用于表示缺失值的字符串

print(df)

print(pd.isnull(df))
   a  b   c  d  message

0  1  2 NaN  4      NaN

       a      b     c      d  message

0  False  False  True  False     True
sentinels = {'message':['foo','NA'],'d':['a','NaN']}# 用一个字典为各列指定不同的NA标记值

df = pd.read_csv('ex4.csv',skiprows=[0,2],na_values=sentinels)

print(df)
   a  b   c  d message

0  1  2 NaN  4   hello
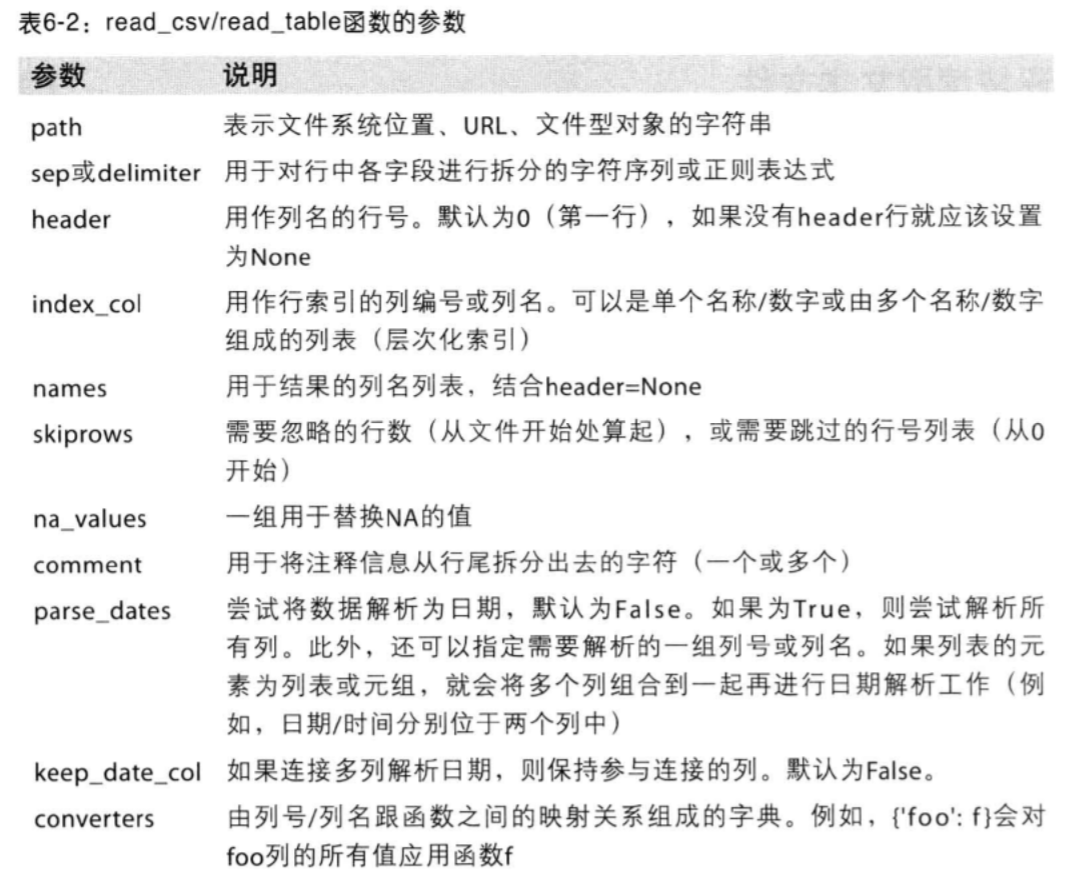
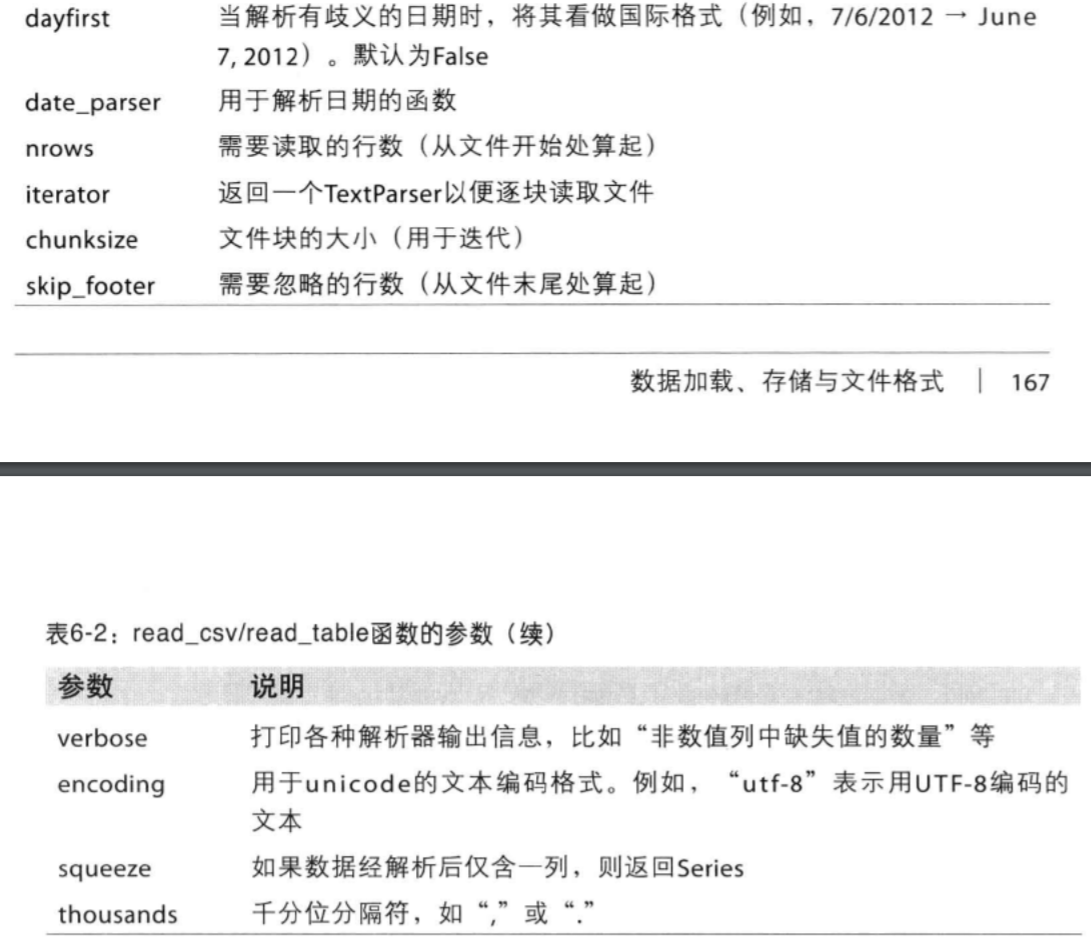
这里,给出了更详细的参数情况:
二、逐块读取文本文件
这里还是参数的调整问题。由于参数过少,这里不做统一整理。
# nrows参数指定只读取定行。算上第一行哦

pd.read_csv('ex1.csv',nrows=4)
.dataframe thead tr:only-child th {
text-align: right;
}
.dataframe thead th {

    text-align: left;

}

.dataframe tbody tr th {

    vertical-align: top;

}
| a | b | c | d | message | |
|---|---|---|---|---|---|
| 0 | 1 | 2 | 3 | 4 | hello |
| 1 | 5 | 6 | 7 | 8 | world |
| 2 | 9 | 10 | 11 | 12 | foo |
# chunksize 指定分块读取

chunks = pd.read_csv('ex1.csv',chunksize=2)

print(chunks)
<pandas.io.parsers.TextFileReader object at 0x0000007D7E4A39B0>
for chunk in chunks:

    print(chunk)

    print('='*10,)
   a  b  c  d message

0  1  2  3  4   hello

1  5  6  7  8   world

==========

   a   b   c   d message

2  9  10  11  12     foo

==========
三、将数据写出到文本格式
data = pd.read_csv('ex1.csv',nrows=3)
data.to_csv('ex1_1.csv') #to_csv写入
data.to_csv('ex1_2.csv',sep='|')# 别的分隔符
data.to_csv('ex1_1.csv',na_rep='NULL')# 缺失值会被替换为na_rep
data.to_csv(sys.stdout,index=False,header=False)

# 行、列标签被禁止

# 输出到控制台
1,2,3,4,hello

5,6,7,8,world

9,10,11,12,foo
data.to_csv(sys.stdout,index=False,columns=['a','b'])
a,b

1,2

5,6

9,10
data.to_csv(sys.stdout)
,a,b,c,d,message

0,1,2,3,4,hello

1,5,6,7,8,world

2,9,10,11,12,foo
四、DataFrame和数据库
# 可以将json格式的数据传给DataFreame

# 也可以数据将数据库的rows传给DataFrame
conn = pymysql.Connect(host='172.31.238.166',port=3306,user='luowang',passwd='root',\

                      charset='UTF8',db='dyx')

cursor=conn.cursor()

sql='select * from access_log';

cursor.execute(sql)

rows= cursor.fetchall()

print(cursor.description)
(('aid', 3, None, 16, 16, 0, False), ('site_id', 3, None, 16, 16, 0, False), ('count', 3, None, 32, 32, 0, False))
# cursor.description第一个保存了列的信息

# pd.DataFrame(rows,columns=[i[0] for i in cursor.description])

pd.DataFrame(list(rows),columns=[i[0] for i in cursor.description]) #rows必须是list类型
.dataframe thead tr:only-child th {
text-align: right;
}
.dataframe thead th {

    text-align: left;

}

.dataframe tbody tr th {

    vertical-align: top;

}
| aid | site_id | count | |
|---|---|---|---|
| 0 | 1 | 1 | 45 |
| 1 | 2 | 3 | 100 |
| 2 | 3 | 1 | 230 |
| 3 | 4 | 2 | 10 |
| 4 | 5 | 5 | 205 |
| 5 | 6 | 4 | 13 |
| 6 | 7 | 3 | 220 |
| 7 | 8 | 5 | 545 |
| 8 | 9 | 3 | 201 |
| 9 | 10 | 10 | 10 |
| 10 | 11 | 11 | 11 |
欢迎进一步交流本博文相关内容:
博客园地址 : http://www.cnblogs.com/AsuraDong/
CSDN地址 : http://blog.csdn.net/asuradong
也可以致信进行交流 : xiaochiyijiu@163.com
欢迎关注个人微博:http://weibo.com/AsuraDong
欢迎转载 , 但请指明出处 : )
pandas处理各类表格数据的更多相关文章
- 使用pandas中的raad_html函数爬取TOP500超级计算机表格数据并保存到csv文件和mysql数据库中
参考链接:https://www.makcyun.top/web_scraping_withpython2.html #!/usr/bin/env python # -*- coding: utf-8 ...
- 利用 pandas库读取excel表格数据
利用 pandas库读取excel表格数据 初入IT行业,愿与大家一起学习,共同进步,有问题请指出!! 还在为数据读取而头疼呢,请看下方简洁介绍: 数据来源为国家统计局网站下载: 具体方法 代码: i ...
- Python使用Tabula提取PDF表格数据
今天遇到一个批量读取pdf文件中表格数据的需求,样式大体是以下这样: python读取PDF无非就是三种方式(我所了解的),pdfminer.pdf2htmlEX 和 Tabula.综合考虑后,选择了 ...
- pandas读取各类sql数据源
大数据分析中,我们经常需要使用pandas工具读取各类数据源并将结果保存到数据库中. 本文总结了一些读取和写入常用数据库数据的一些方法,包括mysql,oracle,impala等. 其中读取数据库数 ...
- 另类爬虫:从PDF文件中爬取表格数据
简介 本文将展示一个稍微不一样点的爬虫. 以往我们的爬虫都是从网络上爬取数据,因为网页一般用HTML,CSS,JavaScript代码写成,因此,有大量成熟的技术来爬取网页中的各种数据.这次, ...
- @1-5使用pandas保存豆瓣短评数据
使用pandas保存豆瓣短评数据 Python爬虫(入门+进阶) DC学院 本节课程的内容是介绍open函数和pandas两种保存已爬取的数据的方法,并通过实际例子使用pandas保存数据. ...
- 利用Python进行数据分析-Pandas(第五部分-数据规整:聚合、合并和重塑)
在许多应用中,数据可能分散在许多文件或数据库中,存储的形式也不利于分析.本部分关注可以聚合.合并.重塑数据的方法. 1.层次化索引 层次化索引(hierarchical indexing)是panda ...
- 利用pandas读取Excel表格,用matplotlib.pyplot绘制直方图、折线图、饼图
利用pandas读取Excel表格,用matplotlib.pyplot绘制直方图.折线图.饼图 数据: 折线图代码: import pandas as pdimport matplotlib. ...
- 实操 | 内存占用减少高达90%,还不用升级硬件?没错,这篇文章教你妙用Pandas轻松处理大规模数据
注:Pandas(Python Data Analysis Library) 是基于 NumPy 的一种工具,该工具是为了解决数据分析任务而创建的.此外,Pandas 纳入了大量库和一些标准的数据模型 ...
随机推荐
- 洛谷 P1131 [ ZJOI 2007 ] 时态同步 —— 树形DP
题目:https://www.luogu.org/problemnew/show/P1131 记录 x 子树内同步的时间 f[x],同步所需代价 g[x]: 直接转移即可,让该儿子子树与其它儿子同步, ...
- IntelliJ IDEA 安装目录的核心文件讲解
转自:https://blog.csdn.net/qq_35246620/article/details/61916751 首先,我们回顾一下前两篇关于 IntelliJ IDEA 的博文的内容: 在 ...
- 11.Extjs登录页面js
/** * @author sux * @desc 登录 */ Ext.onReady(function(){ Ext.QuickTips.init(); //错误信息显示必须 var loginFo ...
- 31. ExtJs4回车事件监听
转自:https://710542316.iteye.com/blog/2148542 监听表单字段事件: Ext使得对用户某个动作的监听特别简单,诸如单击某个元素或者按下某个键盘上的键. 一个经常性 ...
- Linux 系统命令 - pwd - 显示当前所在的位置
命令详解 重要星级: ★★★★★ 功能说明: pwd命令是 "print working directory" 中每个单词的首字母缩写,其功能是显示当前工作目录的绝对路径.在实际工 ...
- hdu 2209 翻纸牌游戏【贪心】
本来是冲着搜索去的--其实可以贪心 因为能改变第一位的只有第一位和第二位,然后改完之后后面的同理,也就是说只要贪心的推一遍就可以 但是注意要在翻第一个和不翻第一个之间取个min #include< ...
- video 能播放声音不能播放视频,黑屏
与视频编码格式有关,mp4的视频编码有三种:MPEG4(DivX),MPEG4(Xvid),AVC(H264). 浏览器播放视频的支持有限,MP4格式的视频只支持h.264的视频: 视频编码: AVC ...
- 10046 trace and sql
1. SQLT 下载 从metalink上下载SQLT工具,参考文档 (以下大部分(SQL可以在sqlt\utl 目录下找到)) 1.1 SQLT 安装 SQLT安装在自己的schema SQLT ...
- [译]curl_multi_info_read
curl_multi_info_read - read multi stack informationals读取multi stack中的信息 SYNOPSIS#include <curl/cu ...
- C#基础 结构体 枚举类型
结构体:就是一个自定义的集合,里面可以放各种类型的元素,用法大体跟集合一样. 一.定义的例子: struct student { public int nianling; public int fen ...