
使用pandas中的raad_html函数爬取TOP500超级计算机表格数据并保存到csv文件和mysql数据库中
参考链接:https://www.makcyun.top/web_scraping_withpython2.html
#!/usr/bin/env python

# -*- coding: utf-8 -*-

from multiprocessing.pool import Pool

import pandas as pd

import requests

from sqlalchemy import create_engine

# 数据库相关信息

HOSTNAME = '127.0.0.1'

PORT = ''

DATABASE = 'top500'

USERNAME = 'root'

PASSWORD = 'root'

SQLALCHEMY_DATABASE_URI = "mysql+mysqlconnector://{username}:{password}@{host}:{port}/{db}?charset=utf8mb4".format(

    username=USERNAME,

    password=PASSWORD,

    host=HOSTNAME,

    port=PORT,

    db=DATABASE)

SQLALCHEMY_TRACK_MODIFICATIONS = False

SQLALCHEMT_ENCODING = 'utf8mb4'

engine = create_engine(SQLALCHEMY_DATABASE_URI, echo=True)

# 获取网页收据

def get_one_page(url):

    response = requests.get(url)

    if response.status_code == 200:

        return response.text

    else:

        return None

# 保存到csv文件

def save_csv(html):

    dataframe = pd.read_html(html)

    tb = dataframe[0].drop([0])  # 获取网页数据中的第一个表格数据,然后再去掉第一个表格数据中的的第一行(去掉的话csv文件中没有列名,不去掉的话多次写入列名)

    # tb.columns = ['rank', 'site', 'system', 'cores', 'rmax', 'rpeak', 'power'] # 重命名列名

    tb.to_csv(r'top500.csv', mode='a', encoding='utf_8_sig', index=True, header=False)  #

def save_mysql(html):

    dataframe = pd.read_html(html)

    tb = dataframe[0].drop([0])

    tb.columns = ['rank', 'site', 'system', 'cores', 'rmax', 'rpeak', 'power']

    try:

        tb.to_sql('top500', con=engine, if_exists='append', index=False)  # 需要事先建好top500数据表,并注意字段名称跟数据列名一一对应,字段值的长度要足够

        print('success')

    except:

        print('fail')

def main(offset):

    url = 'https://www.top500.org/list/2018/11/?page=' + str(offset)

    html = get_one_page(url)

    # save_csv(html)

    save_mysql(html)

if __name__ == '__main__':

    pool = Pool()

    pool.map(main, [i for i in range(1, 6)])
csv文件效果:

csv文件待优化的地方:加上列名
mysql效果:
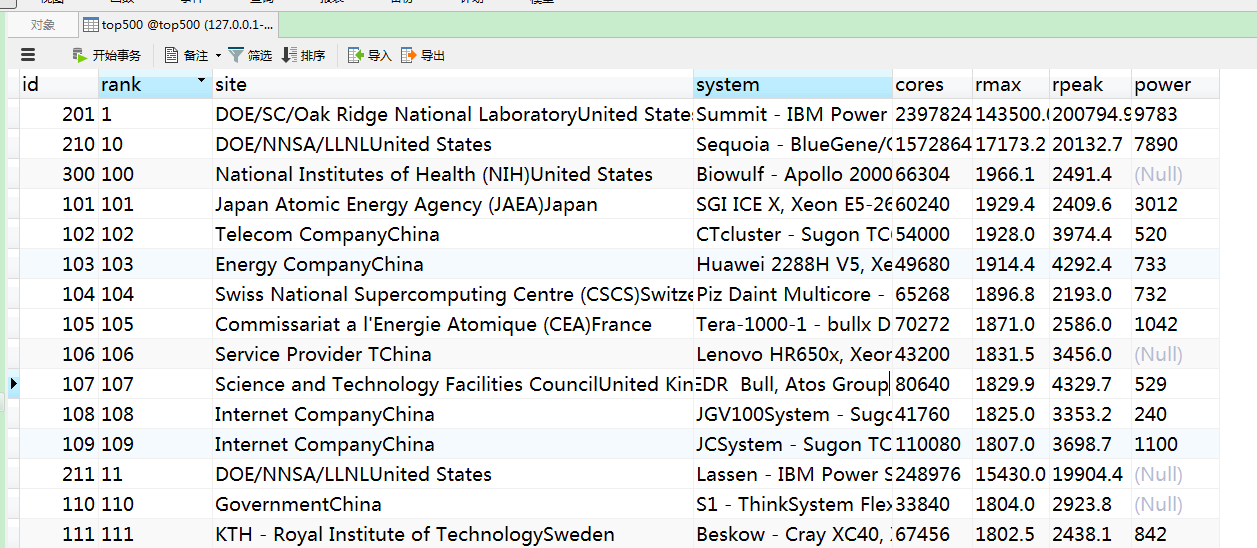
问题:
1.不论是csv文件还是mysql表格数据,根据rank字段进行排序,竟然排序的不怎么准确
2.site字段的最后部分数据是国家,这个需要想办法给剥离出来,再弄一列数据展示
使用pandas中的raad_html函数爬取TOP500超级计算机表格数据并保存到csv文件和mysql数据库中的更多相关文章
- JAVA读取CSV文件到MySQL数据库中
maven项目pom配置: <dependency> <groupId>net.sourceforge.javacsv</groupId> <artifact ...
- 记录python爬取猫眼票房排行榜(带stonefont字体网页),保存到text文件,csv文件和MongoDB数据库中
猫眼票房排行榜页面显示如下: 注意右边的票房数据显示,爬下来的数据是这样显示的: 网页源代码中是这样显示的: 这是因为网页中使用了某种字体的缘故,分析源代码可知: 亲测可行: 代码中获取的是国内票房榜 ...
- 使用scrapy爬取的数据保存到CSV文件中,不使用命令
pipelines.py文件中 import codecs import csv # 保存到CSV文件中 class CsvPipeline(object): def __init__(self): ...
- python爬取当当网的书籍信息并保存到csv文件
python爬取当当网的书籍信息并保存到csv文件 依赖的库: requests #用来获取页面内容 BeautifulSoup #opython3不能安装BeautifulSoup,但可以安装Bea ...
- 爬取某网站景区列表并保存为csv文件
网址:http://www.halehuo.com/jingqu.html 经过查看可以发现,该景区页面没有分页,不停的往下拉,页面会进行刷新显示后面的景区信息 通过使用浏览器调试器,发现该网站使用的 ...
- 爬取拉勾网python工程师的岗位信息并生成csv文件
转载自:https://www.cnblogs.com/sui776265233/p/11146969.html 代码写得很好,但是目前只看得懂前一部分 一.爬取和分析相关依赖包 Python版本: ...
- 简单又强大的pandas爬虫 利用pandas库的read_html()方法爬取网页表格型数据
文章目录 一.简介 二.原理 三.爬取实战 实例1 实例2 一.简介 一般的爬虫套路无非是发送请求.获取响应.解析网页.提取数据.保存数据等步骤.构造请求主要用到requests库,定位提取数据用的比 ...
- 使用requests、BeautifulSoup、线程池爬取艺龙酒店信息并保存到Excel中
import requests import time, random, csv from fake_useragent import UserAgent from bs4 import Beauti ...
- 使用requests、re、BeautifulSoup、线程池爬取携程酒店信息并保存到Excel中
import requests import json import re import csv import threadpool import time, random from bs4 impo ...
随机推荐
- 怎么修改tomcat端口
tomcat默认的端口是8080,还会占用8005,8009和8443端口.如果已经启动了tomcat,再启动一个tomcat会发现这些端口已经被占用了,这个时候就需要修改端口号. 工具/原料 ...
- 人见人爱A+B(杭电2033)
/*人见人爱A+B Problem Description HDOJ上面已经有10来道A+B的题目了,相信这些题目以前是大家的最爱,希望今天的这个A+B能给大家带来好运.也希望这个题目能唤起大家对AC ...
- JavaScript模式读书笔记 第4章 函数
2014年11月10日 1.JavaScript函数具有两个特点: 函数是第一类对象 函数能够提供作用域 函数即对象,表现为: -1,函数能够在执行时动态创建,也 ...
- 一步步玩pcDuino3--mmc下的bootloader
pcDuino3下支持mmc启动.官方的Uboot是採用SPL框架实现的,由于内部的SRAM空间达到32K,我们全然能够在这32K空间内编写一个完整可用小巧的bootloader来完毕引导Linux ...
- XMPP 协议工作流程具体解释
XMPP 要点. 1. client(C) 和server端(S) 通过TCP连接5222port进行全双工通信. 2. XMPP 信息均包括在 XML streams中.一个XMPP会话, 開始于& ...
- 弹出框中选项卡的运用(easyUI)
先看一下页面效果: 此处有两个知识点:一个是弹出框的运用,一个是选项卡的运用 分析一下该HTML代码,最外面一个div是弹出框的,默认是关闭状态,可通过ID来控制弹出框的开关,该div的样式是easy ...
- Android源码编译全过程记录(基于最新安卓5.1.0)【转】
本文转载自:http://blog.csdn.net/drg1612/article/details/44802533 我的编译条件: 1 Ubuntu Kylin 14.04 长期支持版 下载地址 ...
- Anaconda/kickstart
http://fedoraproject.org/wiki/Anaconda/Kickstart/zh-cn
- iOS版本、iPhone版本、Xcode版本比对
iOS版本 iPhone版本 Xcode版本 其他 2003年 Xcode1.0 2005年4月29日 Xcode2.0 2007年1月9日 iPhone OS(iOS1): 虚拟键盘.谷歌地图 第一 ...
- Spring Boot 打 war 包的步骤
## Spring Boot 打 war 包的步骤 1. 添加 spring-boot-start-tomcat 的 provided 依赖 ``` <dependency> <gr ...