
中国农产品信息网站scrapy-redis分布式爬取数据
---恢复内容开始---
基于scrapy_redis和mongodb的分布式爬虫
项目需求:
1:自动抓取每一个农产品的详细数据
2:对抓取的数据进行存储
第一步:
创建scrapy项目
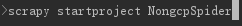
创建爬虫文件

在items.py里面定义我们要爬取的数据
# -*- coding: utf-8 -*-

# Define here the models for your scraped items
#
# See documentation in:
# https://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class NongcpspiderItem(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()
    # 供求关系
    supply = scrapy.Field()
    # 标题
    title = scrapy.Field()
    # 发布时间
    create_time = scrapy.Field()
    # 发布单位
    unit = scrapy.Field()
    # 联系人
    contact = scrapy.Field()
    # 手机号码
    phone_number = scrapy.Field()
    # 地址
    address = scrapy.Field()
    # 详细地址
    detail_address = scrapy.Field()
    # 上市时间
    market_time = scrapy.Field()
    # 价格
    price = scrapy.Field()
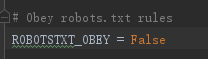
将settings.py改为false
写spider爬虫文件nongcp_spider.py,进行字段解析使用xpath,正则表达式
# -*- coding: utf-8 -*-
import scrapy
import re
from ..items import NongcpspiderItem
class NongcpSpiderSpider(scrapy.Spider):
name = 'nongcp_spider'
# allowed_domains = ['http://www.nongnet.com/']
start_urls = ['http://www.nongnet.com/']
def parse(self, response):
"""
解析详情页和下一页url
:param response:
:return:
"""
detail_urls = response.xpath('//li[@class="lileft"]/a/@href').extract()
for detail_url in detail_urls:
yield scrapy.Request(url=self.start_urls[0]+detail_url, callback=self.detail_parse)
next_url = response.xpath("//span[@id='ContentMain_lblPage']/a/@href").extract()
if next_url:
yield scrapy.Request(url=self.start_urls[0]+next_url[-2])
def detail_parse(self, response):
"""
解析具体的数据
:param response:
:return:
"""
items = NongcpspiderItem()
title_result = response.xpath('//h1[@class="h1class"]/text()').extract_first()
if title_result:
items['supply'] = title_result.strip()[1:2]
items['title'] = title_result.strip()[3:]
creatte_time = re.findall(r"<font color='999999'>时间:(\d+/\d+/\d+ \d+:\d+)  ", response.text)
if creatte_time:
items['create_time'] = creatte_time[0]
unit = re.findall(r"发布单位</div><div class='xinxisxr'><a href='.*?.aspx'>(.*?)</a>", response.text, re.S)
if unit:
items['unit'] = unit[0]
price = response.xpath('//div[@class="scdbj1"]/text()').extract()
if price:
items['price'] = ''.join(price)
yield items
编写pipelines.py,往mongodb里面存储数据
# -*- coding: utf-8 -*-

# Define your item pipelines here
#
# Don't forget to add your pipeline to the ITEM_PIPELINES setting
# See: https://doc.scrapy.org/en/latest/topics/item-pipeline.html
import pymongo

class NongcpspiderPipeline(object):
    def process_item(self, item, spider):
        return item

class MongoPipeline(object):
    def __init__(self):
        client = pymongo.MongoClient(host='127.0.0.1', port=27017)
        self.db = client['nong']
        self.connection = self.db['Info']
        self.dbinfo = self.db.authenticate('xxxx', 'xxxx')

    def process_item(self, item, spider):
        self.connection.save(dict(item))
        return item
完成以上步骤就可以进行数据的爬取了,接下来我们来测试一下爬取的效果
编写启动脚本start.py
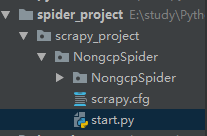
#encoding: utf-8

from scrapy import cmdline

# cmdline.execute("scrapy crawl qsbk_spider".split())
cmdline.execute(["scrapy", 'crawl', 'nongcp_spider'])
开启settings.py pipelines字段

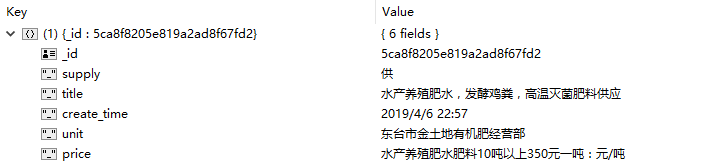
运行程序,爬取到的效果如下
接下来实现分布式去重爬取
先安装scrapy-redis
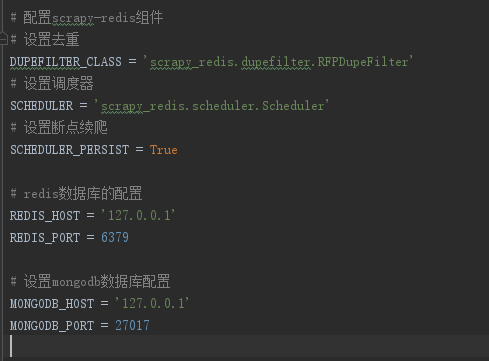
在settings.py里面配置scrapy-redis组件
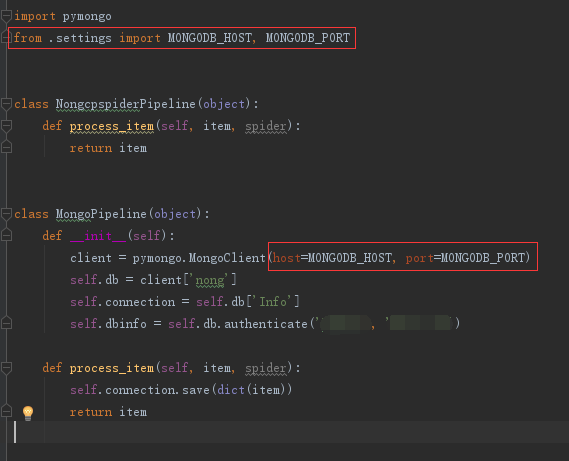
在pipelines.py引入mongdb配置
修改nongcp_spider.py文件
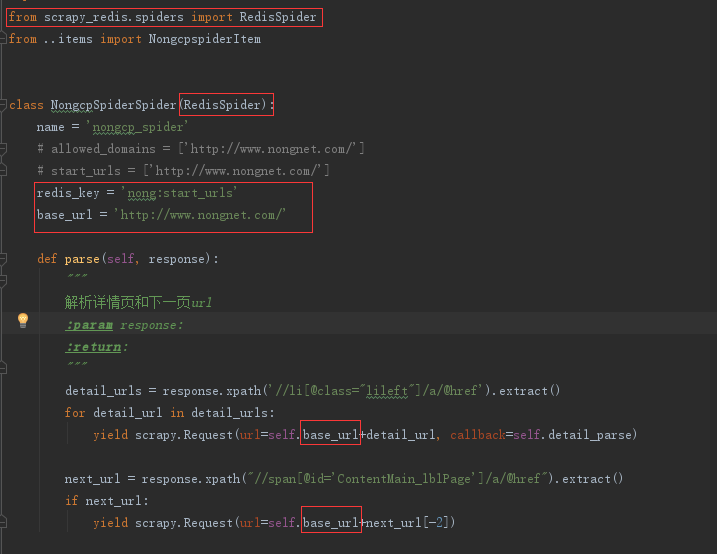
如果爬取过程中出现封ip的操作,我们可以设置middlewares.py,,在该文件设置代理
使用阿布云代理

先启动start.py文件,在运行redis-cli
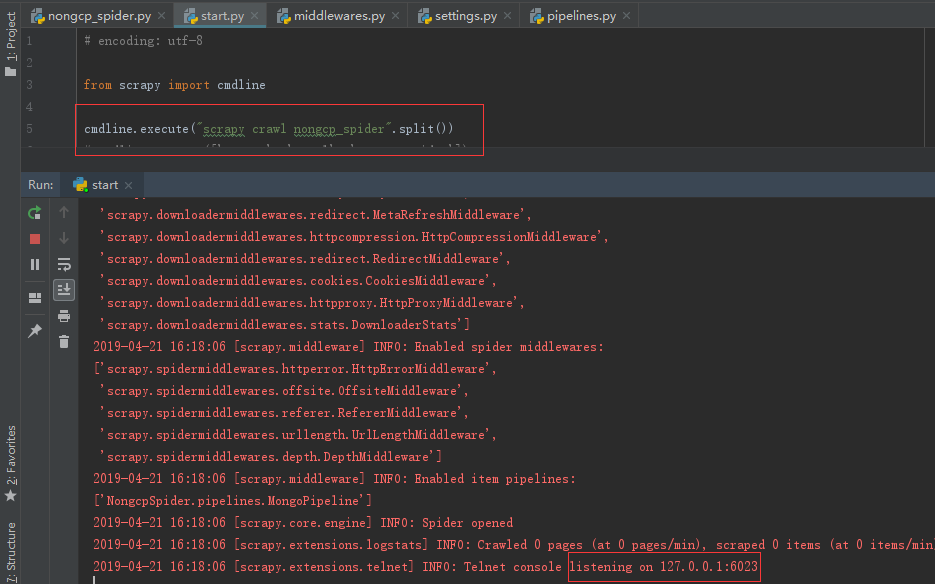
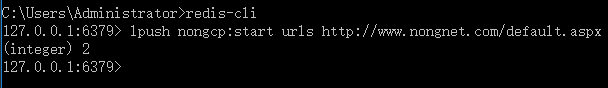
然后就可以抓取数据了到mongdb里面了
---恢复内容结束---
中国农产品信息网站scrapy-redis分布式爬取数据的更多相关文章
- 爬虫--scrapy+redis分布式爬取58同城北京全站租房数据
作业需求: 1.基于Spider或者CrawlSpider进行租房信息的爬取 2.本机搭建分布式环境对租房信息进行爬取 3.搭建多台机器的分布式环境,多台机器同时进行租房数据爬取 建议:用Pychar ...
- Scrapy持久化存储-爬取数据转义
Scrapy持久化存储 爬虫爬取数据转义问题 使用这种格式,会自动帮我们转义 'insert into wen values(%s,%s)',(item['title'],item['content' ...
- scrapy使用PhantomJS爬取数据
环境:python2.7+scrapy+selenium+PhantomJS 内容:测试scrapy+PhantomJS 爬去内容:涉及到js加载更多的页面 原理:配置文件打开中间件+修改proces ...
- scrapy-redis + Bloom Filter分布式爬取tencent社招信息
scrapy-redis + Bloom Filter分布式爬取tencent社招信息 什么是scrapy-redis 什么是 Bloom Filter 为什么需要使用scrapy-redis + B ...
- scrapy-redis分布式爬取tencent社招信息
scrapy-redis分布式爬取tencent社招信息 什么是scrapy-redis 目标任务 安装爬虫 创建爬虫 编写 items.py 编写 spiders/tencent.py 编写 pip ...
- Scrapy 分布式爬取
由于受到计算机能力和网络带宽的限制,单台计算机运行的爬虫咋爬取数据量较大时,需要耗费很长时间.分布式爬取的思想是“人多力量大”,在网络中的多台计算机同时运行程序,公童完成一个大型爬取任务, Scrap ...
- scrapy-redis实现爬虫分布式爬取分析与实现
本文链接:http://blog.csdn.net/u012150179/article/details/38091411 一 scrapy-redis实现分布式爬取分析 所谓的scrapy-redi ...
- scrapy-redis分布式爬取知乎问答,使用docker布置多台机器。
先上结果: 问题: 答案: 可以看到现在答案文档有十万多,十万个为什么~hh 正文开始: 分布式爬虫应该是在多台服务器(A B C服务器)布置爬虫环境,让它们重复交叉爬取,这样的话需要用到状态管理器. ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
随机推荐
- C# xml转换成ini格式
最近一直在写一个关于自动转换文件格式的代码,一点小心得. 目标xml文件内容,我的命名是data2.xml <?xml version="1.0" encoding=&quo ...
- Bootstrap后台管理模板调研
Bootstrap后台管理模板调研 SB Admin 2(推荐) SB Admin 2是一款开源的基于Bootstrap搭建的后台管理模板,简约,易用.没有复杂的组件和花炫的设计,很质朴,但较为美观. ...
- ORACLE_ALIAS
Oracle / PLSQL: ALIASES website:https://www.techonthenet.com/oracle/alias.php This Oracle tutorial e ...
- 【Spring实战】—— 10 AOP针对参数的通知
通过前面的学习,可以了解到 Spring的AOP可以很方便的监控到方法级别的执行 ,针对于某个方法实现通知响应. 那么对于方法的参数如何呢? 比如我们有一个方法,每次传入了一个字符串,我想要知道每次传 ...
- 深度剖析hdfs原理
大数据底层技术的三大基石起源于Google在2006年之前的三篇论文GFS.Map-Reduce. Bigtable,其中GFS.Map-Reduce技术直接支持了Apache Hadoop项目的诞生 ...
- 一个自动生成awr报告的shell脚本
最近在学习shell编程,搞一点点小工具自动完成awr报告的收集工作,方便系统出现问题时问题排查.脚本内容如下,系统收集每天开始时间6点结束时间20点的awr报告并存储在/u01/shell_t/aw ...
- 用一个实际例子理解Docker volume工作原理
要了解Docker Volume,首先我们需要理解Docker文件系统的工作原理.Docker镜像是由多个文件系统的只读层叠加而成.当一个容器通过命令docker run启动时,Docker会加载只读 ...
- note02-计算机网络
2.物理层 通信系统模型(源->发送器->XXX->接收器->终),源发出数字信号,调制器编码为模拟信号,进行传输,解调器解码模拟信号为数字信号给终 信噪比,香农公式,C=B ...
- 【洛谷5286】[HNOI2019] 鱼(计算几何)
点此看题面 大致题意: 给你\(n\)个点,让你求鱼形图的数量. 核心思路 首先,考虑到\(n\)这么小,我们可以枚举线段\(AD\),再去找符合条件的\(BC,EF\). 然后,不难发现\(BC\) ...
- Node.js使用MySQL数据库中对RowDataPacket对象的使用
使用Node.js开发使用MySQL数据库的网站,在查询后返回一RowDataPacket类型的对象 原先使用toString()方法一直得到仅为object的字符串,无法使用 后思考,才发现忽略了其 ...