
【小白学PyTorch】21 Keras的API详解(下)池化、Normalization层
文章来自微信公众号:【机器学习炼丹术】。作者WX:cyx645016617.
参考目录:
下篇的内容中,主要讲解这些内容:
- 四个的池化层;
- 两个Normalization层;
1 池化层
和卷积层相对应,每一种池化层都有1D,2D,3D三种类型,这里主要介绍2D处理图像的一个操作。1D和3D可以合理的类推。
1.1 最大池化层
tf.keras.layers.MaxPooling2D(

    pool_size=(2, 2), strides=None, padding="valid", data_format=None, **kwargs

)
这个strides在默认的情况下就是步长为2 下面看个例子:
import tensorflow as tf

x = tf.random.normal((4,28,28,3))

y = tf.keras.layers.MaxPooling2D(

    pool_size=(2,2))

print(y(x).shape)

>>> (4, 14, 14, 3)
如果你把strides改成1:
import tensorflow as tf

x = tf.random.normal((4,28,28,3))

y = tf.keras.layers.MaxPooling2D(

    pool_size=(2,2),

    strides = 1)

print(y(x).shape)

>>> (4, 27, 27, 3)
如果再把padding改成‘same’:
import tensorflow as tf

x = tf.random.normal((4,28,28,3))

y = tf.keras.layers.MaxPooling2D(

    pool_size=(2,2),

    strides = 1,

    padding='same')

print(y(x).shape)

>>> (4, 28, 28, 3)
这个padding默认是'valid',一般strides为2,padding是valid就行了。
1.2 平均池化层
和上面的最大池化层同理,这里就展示一个API就不再多说了。
tf.keras.layers.AveragePooling2D(

    pool_size=(2, 2), strides=None, padding="valid", data_format=None, **kwargs

)
1.3 全局最大池化层
tf.keras.layers.GlobalMaxPooling2D(data_format=None, **kwargs)
这个其实相当于pool_size等于特征图尺寸的一个最大池化层。看一个例子:
import tensorflow as tf

x = tf.random.normal((4,28,28,3))

y = tf.keras.layers.GlobalMaxPooling2D()

print(y(x).shape)

>>> (4, 3)
可以看到,一个通道只会输出一个值,因为我们的输入特征图的尺寸是\(28\times 28\),所以这里的全局最大池化层等价于pool_size=28的最大池化层。
1.4 全局平均池化层
与上面的全局最大池化层等价。
tf.keras.layers.GlobalAveragePooling2D(data_format=None, **kwargs)
2 Normalization
Keras官方只提供了两种Normalization的方法,一个是BatchNormalization,一个是LayerNormalization。虽然没有提供InstanceNormalization和GroupNormalization的方法,我们可以通过修改BN层的参数来构建。
2.1 BN
tf.keras.layers.BatchNormalization(

    axis=-1,

    momentum=0.99,

    epsilon=0.001,

    center=True,

    scale=True,

    beta_initializer="zeros",

    gamma_initializer="ones",

    moving_mean_initializer="zeros",

    moving_variance_initializer="ones",

    beta_regularizer=None,

    gamma_regularizer=None,

    beta_constraint=None,

    gamma_constraint=None,

    renorm=False,

    renorm_clipping=None,

    renorm_momentum=0.99,

    fused=None,

    trainable=True,

    virtual_batch_size=None,

    adjustment=None,

    name=None,

    **kwargs

)
我们来详细讲解一下参数:
- axis:整数。表示哪一个维度是通道数维度,默认是-1,表示是最后一个维度。如果之前设置了
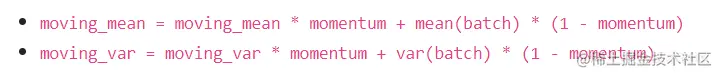
channels_first,那么需要设置axis=1. - momentum:当training过程中,Batch的均值方差会根据batch计算出来,在预测或者验证的时候,这个均值方差是采用training过程中计算出来的滑动均值和滑动方差的。具体的计算过程是:
- epsilon:一个防止运算除法除以0的一个极小数,一般不做修改;
- center:True的话,则会有一个可训练参数beta,也就是beta均值的这个offset;如果是False的话,这个BN层则退化成以0为均值,gamma为标准差的Normalization。默认是True,一般不做修改。
- scale:与center类似,默认是True。如果是False的话,则不使用gamma参数,BN层退化成以beta为均值,1为标准差的Normalization层。
- 其他都是初始化的方法和正则化的方法,一般不加以限制,使用的方法在上节课也已经讲解了,在此不加赘述。
这里需要注意的一点是,keras的API中并没有像PyTorch的API中的这个参数group,这样的话,就无法衍生成GN和InstanceN层了,在之后的内容,会在Tensorflow_Addons库中介绍
2.2 LN
tf.keras.layers.LayerNormalization(

    axis=-1,

    epsilon=0.001,

    center=True,

    scale=True,

    beta_initializer="zeros",

    gamma_initializer="ones",

    beta_regularizer=None,

    gamma_regularizer=None,

    beta_constraint=None,

    gamma_constraint=None,

    trainable=True,

    name=None,

    **kwargs

)
参数和BN的参数基本一致。直接看一个例子:
import tensorflow as tf

import numpy as np

x = tf.constant(np.arange(10).reshape(5,2)*10,

                dtype=tf.float32)

print(x)

y = tf.keras.layers.LayerNormalization(axis=1)

print(y(x))
运行结果为:
tf.Tensor(

[[ 0. 10.]

 [20. 30.]

 [40. 50.]

 [60. 70.]

 [80. 90.]], shape=(5, 2), dtype=float32)

tf.Tensor(

[[-0.99998  0.99998]

 [-0.99998  0.99998]

 [-0.99998  0.99998]

 [-0.99998  0.99998]

 [-0.99998  0.99998]], shape=(5, 2), dtype=float32)
我在之前的文章中已经介绍过了LN,BN,GN,IN这几个归一化层的详细原理,不了解的可以看本文最后的相关链接中找一找。
【小白学PyTorch】21 Keras的API详解(下)池化、Normalization层的更多相关文章
- 【小白学PyTorch】21 Keras的API详解(上)卷积、激活、初始化、正则
[新闻]:机器学习炼丹术的粉丝的人工智能交流群已经建立,目前有目标检测.医学图像.时间序列等多个目标为技术学习的分群和水群唠嗑答疑解惑的总群,欢迎大家加炼丹兄为好友,加入炼丹协会.微信:cyx6450 ...
- 小白如何学习PyTorch】25 Keras的API详解(下)缓存激活,内存输出,并发解决
[新闻]:机器学习炼丹术的粉丝的人工智能交流群已经建立,目前有目标检测.医学图像.时间序列等多个目标为技术学习的分群和水群唠嗑答疑解惑的总群,欢迎大家加炼丹兄为好友,加入炼丹协会.微信:cyx6450 ...
- 【小白学AI】GBDT梯度提升详解
文章来自微信公众号:[机器学习炼丹术] 文章目录: 目录 0 前言 1 基本概念 2 梯度 or 残差 ? 3 残差过于敏感 4 两个基模型的问题 0 前言 先缕一缕几个关系: GBDT是gradie ...
- 【小白学PyTorch】20 TF2的eager模式与求导
[新闻]:机器学习炼丹术的粉丝的人工智能交流群已经建立,目前有目标检测.医学图像.时间序列等多个目标为技术学习的分群和水群唠嗑的总群,欢迎大家加炼丹兄为好友,加入炼丹协会.微信:cyx64501661 ...
- Java 8 Stream API详解--转
原文地址:http://blog.csdn.net/chszs/article/details/47038607 Java 8 Stream API详解 一.Stream API介绍 Java8引入了 ...
- hibernate学习(2)——api详解对象
1 Configuration 配置对象 /详解Configuration对象 public class Configuration_test { @Test //Configuration 用户 ...
- 转】Mahout推荐算法API详解
原博文出自于: http://blog.fens.me/mahout-recommendation-api/ 感谢! Posted: Oct 21, 2013 Tags: itemCFknnMahou ...
- Java8学习笔记(五)--Stream API详解[转]
为什么需要 Stream Stream 作为 Java 8 的一大亮点,它与 java.io 包里的 InputStream 和 OutputStream 是完全不同的概念.它也不同于 StAX 对 ...
- Android Developer -- Bluetooth篇 开发实例之四 API详解
http://www.open-open.com/lib/view/open1390879771695.html 这篇文章将会详细解析BluetoothAdapter的详细api, 包括隐藏方法, 每 ...
随机推荐
- 测试JsonAnalyzer解析Json的十一个测试用例
目测以下测试用例都是通过的. 01. 原文={"status":"","message":"success"," ...
- Java程序取MySQL的datetime字段,如何消除时间尾后讨厌的".0"
Problem: 直接取datetime字段的内容会有".0"后缀,如2020-05-03 18:21:39.0,虽无伤大雅但总觉得有些别扭. Solution:使用转化函数Dat ...
- leetcode刷题-61旋转链表
题目 给定一个链表,旋转链表,将链表每个节点向右移动 k 个位置,其中 k 是非负数. 示例 1: 输入: 1->2->3->4->5->NULL, k = 2输出: 4 ...
- linux下限定连接ip和端口
1.限制端口 vim /etc/ssh/sshd_config 修改连接端口 修改之后重启sshd服务 service sshd restart 再次连接时就需要使用修改后的端口去连接了 备注:判断修 ...
- 内存管理初始化源码5:free_area_init_nodes
start_kernel ——> setup_arch ——> arch_mem_init ——> |——> bootmem_init |——> device_tree ...
- .Net EF 学习之model first
新建一个控制台项目,然后点击添加新建项,选择ADO.Net 实体数据模型 选择空模型 右击设计器,新增,实体 右击新增,标量属性, 右侧可以设置最大长度和一些属性信息: 建好对象后右击根据模型生成数据 ...
- redis.conf讲解
转自https://www.cnblogs.com/zhang-ke/p/5981108.html #redis.conf # Redis configuration file example. # ...
- RXJAVA之创建被观察者
RXJava中提供了多种创建数据源的方式 使用create方法 Observable<String> observable = Observable.create(new Observab ...
- Spring学习(八)AOP详解
文章更新时间:2020/04/06 一.一个例子 在上面的例子中,包租婆的核心业务就是签合同,收房租,那么这就够了,灰色框起来的部分都是重复且边缘的事,交给中介商就好了,这就是 AOP 的一个思想:让 ...
- Java Web学习(五)session、cookie、token
文章更新时间:2020/09/14 一.引言 动态网页兴起后,会话管理变成开发者需要考虑的一个问题,由于HTTP请求是无状态的,为了区分每个用户,此时引入了会话标识(sessionId)的概念,但是存 ...