
San Francisco Crime Classification非数值性多分类问题
给出了旧金山以往犯罪活动的相关信息,预测特定条件下的犯罪情况
分析数据集和测试集信息:
训练集给出的信息有:
1.Dates:时间日期和时间,这里考虑时间对犯罪活动有影响,日期和下边的周几有相似处,取周几作为特征,因为节日是少数情况
2.category:犯罪分类,就是实例的标签
3.descript:对于犯罪的描述,没用的信息
4.DayOfWeek:周几,可能是有影响的
5.PdDistrict:地区,重要信息
6.Resolution:缺失值太多,弃用
7.Address:分类太多,而且和地区重复,弃用
8.坐标:和地区重复,弃用
测试集给出的信息有Dates,DayOfWeek,PdDistrict,Address,坐标
所以最后的特征选择为:Dates,DayOfWeek,PdDistrict
这个题的特征比较好选择,所以没有数据分析和可视化的过程,数据特征分析是很重要的能力,但是一直不会,不知道应该用怎么样的模式系统地进行分析。
这个新手题目最重要的地方我觉得应该是多分类,对于非数值类型的编码处理和朴素贝叶斯算法
看一下官方给出的提交样例:
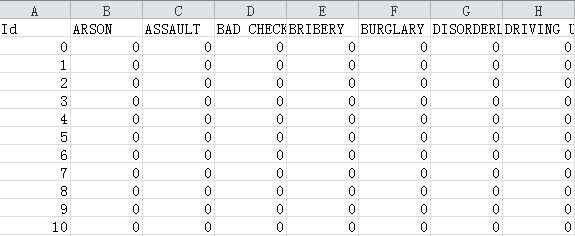
可以看出,最后每个id的结果不是直接显示分类,而是不同的分类显示概率(这也符合生成模型)
解题过程和代码:
1.导包
import numpy as np

import pandas as pd

import matplotlib.pyplot as plt

from sklearn.naive_bayes import BernoulliNB

from sklearn.metrics import log_loss

from sklearn.model_selection import train_test_split
2.数据处理,主要是读文件、对非数值类型进行编码,组合特征(特征筛选这次基本没有)
# 读入文件,并指定第一列为日期时间

train = pd.read_csv('train.csv', parse_dates=['Dates'])

test = pd.read_csv('test.csv', parse_dates=['Dates'])

# 分类

cate = train['Category']

'''

离散特征的编码分为两种情况:

1、离散特征的取值之间没有大小的意义,比如color:[red,blue],那么就使用one-hot编码

2、离散特征的取值有大小的意义,比如size:[X,XL,XXL],那么就使用数值的映射{X:1,XL:2,XXL:3}

'''

# 对区域和星期几和时间进行独热编码

days = pd.get_dummies(train['DayOfWeek'])

dist = pd.get_dummies(train['PdDistrict'])

# 以后时间格式的数据可以在一开始就指定出那一列是时间数据,然后通过下边的方法提取时间或者日期,就不用自己进行提取了

hour = train.Dates.dt.hour

hour = pd.get_dummies(hour)

# 组合特征

# 可以将刚才处理好的一列数据直接添加到数据新建的一个列

# 也可以用pandas的concat()函数,其中参数axis为0时是把列相同的多行数据进行收尾拼接,axis=1时是将多列进行拼接

trainData = pd.concat([days, dist, hour], axis=1)

trainData['cate'] = cate

# 对测试数据进行处理

# 经过get_dummies()进行one-hot处理后series会变成dataframe,列就是原来series中的各类数据

days = pd.get_dummies(test['DayOfWeek'])

dist = pd.get_dummies(test['PdDistrict'])

# 提取出时间信息,记住这个Dates数据的方法

hour = test.Dates.dt.hour

hour = pd.get_dummies(hour)

# pandas库中的concat方法是将DataFrame拼接,当axis=0时将行拼接,当axis=1时将列拼接

testData = pd.concat([days, dist, hour], axis=1)

features = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday', 'Saturday', 'Sunday',

            'BAYVIEW', 'CENTRAL', 'INGLESIDE', 'MISSION',

            'NORTHERN', 'PARK', 'RICHMOND', 'SOUTHERN', 'TARAVAL', 'TENDERLOIN']

hou = [x for x in range(24)]

features = features + hou
3.交叉验证
# 交叉验证

# 训练数据和测试数据分离

training,validation = train_test_split(trainData,train_size=0.6)

# 建立模型

bayes = BernoulliNB()

bayes.fit(training[features],training['cate'])

# 测试集预测,计算错误率

# predict_proba返回一个矩阵,矩阵每一行对应每个实例,一行中的各个float代表判为各个分类的概率

predict = np.array(bayes.predict_proba(validation[features]))

result = pd.DataFrame(predict,columns=bayes.classes_)

# log_loss要求参数都是one-hot编码

print log_loss(validation['cate'],predict)
4.建模预测
# 伯努利朴素贝叶斯

bayes = BernoulliNB()

bayes.fit(trainData[features], trainData['cate'])

predict = np.array(bayes.predict_proba(testData[features]))

result = pd.DataFrame(predict, columns=bayes.classes_)

result.to_csv('result.csv', index=True, index_label='Id')
San Francisco Crime Classification非数值性多分类问题的更多相关文章
- 微软BI 之SSAS 系列 - 多维数据集中度量值设计时的聚合函数 (累加性_半累加性和非累加性)
在 SSAS 系列 - 实现第一个 Cube 以及角色扮演维度,度量值格式化和计算成员的创建 中主要是通过已存在的维度和事实数据创建了一个多维数据集,并同时解释了 Role-Playing Dimen ...
- 写出将字符串中的数字转换为整型的方法,如:“as31d2v”->312,并写出相应的单元测试,正则去掉非数值、小数点及正负号外的字符串
写出将字符串中的数字转换为整型的方法,如:"as31d2v"->312,并写出相应的单元测试,输入超过int范围时提示不合法输入. public struct Convert ...
- AWS Summit 2014 San Francisco站总结
我上个月去San Francisco参加了AWS Summit 2014 会议,总结一下参加这个会议的情况. 什么是AWS Summit? AWS Summit 是AWS在全球各地举办的,针对AWS用 ...
- iOS 9之New System Fonts(San Francisco 字体)
金田 此次苹果发布的iOS 9系统测试版目前已经开放下载,新系统将弃用Helvetica字体,改用了San Francisco字体, 包括系统菜单.App名称等各个部分. 最初San Francisc ...
- 在JS中如何判断所输入的是一个数、整数、正数、非数值?
1.判断是否为一个数字: Number(num)不为 NaN,说明为数字 2. 判断一个数为正数: var num=prompt("请输入:"); if(Number(num)&g ...
- 在javaScript中把非数值类型的数据自动转换为数值类型的两种方式
一.使用Number()函数. 二.使用parseInt()/parseFloat()函数. 详情: 一.使用Number()函数将非数值类型的数据自动的转化为数组类型 Number()函数可以将任何 ...
- [转]React表单无法输入原因----约束性和非约束性组件
转自:http://blog.csdn.net/lihongxun945/article/details/46730835 表单是前端非常重要的一块内容,并且往往包含了错误校验等逻辑. React对表 ...
- js非数值的比较
/** * 非数值的比较: * 1.对于非数值的比较时,会将其转换成数字然后再比较 * 2.如果符号两端是字符串的值进行比较时,不会将其转换为数字进行比较,而是 * 分别比较字符串中的字符的 unic ...
- 七、React表单详解 约束性和非约束性组件 input text checkbox radio select textarea 以及获取表单的内容
一.约束性和非约束性组件: 非约束性组: MV: <input type="text" defaultValue="a" /> 这个 default ...
随机推荐
- CentOS6.5上增加中文字体库,确保前端WEB可以正常显示
1 下载字体 可以在网上下载,也可以在 windows 目录下(C:\Windows\Fonts)找到对应字体,这里是从另一套系统上 copy simsun.ttf 文件. 2 查看当前系统中已安装的 ...
- CentOS SSH安全和配置无密码登录
CentOS ssh默认监听端口 22端口,允许root用户ssh登录.server投入生产后很有必要更改默认ssh监听端口和禁止root登录. 步骤1:确认安装有ssh包 [appuser@su17 ...
- 用PyCharm打个专业的招呼
PyCharm 是什么 PyCharm(读作"拍恰姆")是 JetBrains 全家桶中的一员,专门用来写 Python 的: 官方网址是: https://www.jetbrai ...
- 【NOIP2017提高A组模拟9.12】Arrays and Palindrome
[NOIP2017提高A组模拟9.12]Arrays and Palindrome[SPJ] 题目 Description Input Output Sample Input 1 6 Sample O ...
- Spark存储Parquet数据到Hive,对map、array、struct字段类型的处理
利用Spark往Hive中存储parquet数据,针对一些复杂数据类型如map.array.struct的处理遇到的问题? 为了更好的说明导致问题的原因.现象以及解决方案,首先看下述示例: -- 创建 ...
- SpringBoot系列:六、集成Swagger文档
本篇开始介绍Api文档Swagger的集成 一.引入maven依赖 <dependency> <groupId>io.springfox</groupId> < ...
- 第15.46节、PyQt显示部件:OpenGL Widget部件功能简介及使用案例
专栏:Python基础教程目录 专栏:使用PyQt开发图形界面Python应用 专栏:PyQt入门学习 老猿Python博文目录 老猿学5G博文目录 一.概述 OpenGL Widget部件是一个Op ...
- PyQt(Python+Qt)学习随笔:QTableWidgetItem的构造方法
老猿Python博文目录 专栏:使用PyQt开发图形界面Python应用 老猿Python博客地址 QTableWidgetItem类为QTableWidget类的项实例类,用于保存表格部件的信息.项 ...
- 深海 => 暴力扫描挖掘机
平时总是联动这个联动那个,写一些小脚本,感觉零碎又没啥意思,想把市面上一些比较知名的工具集合一下,弄个方便点的躺着挖洞的工具,看看效果会不会更好,暂时名字取深海吧,估计又是一个迟迟不填的坑,灌灌灌灌水
- 学习一下 SpringCloud (一)-- 从单体架构到微服务架构、代码拆分(maven 聚合)
一.架构演变 1.系统架构.集群.分布式系统 简单理解 (1)什么是系统架构? [什么是系统架构?] 系统架构 描述了 在应用程序内部,如何根据 业务.技术.灵活性.可扩展性.可维护性 等因素,将系统 ...