
常用RDD
只作为我个人笔记,没有过多解释
Transfor
map
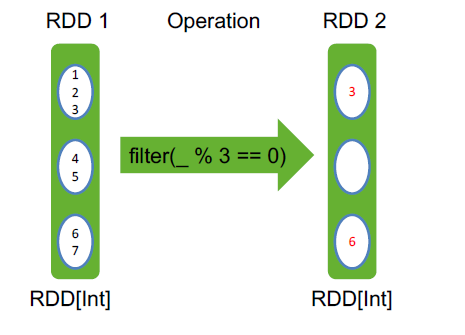
filter filter之后,依然有三个分区,第二个分区为空,但不会消失
flatMap
reduceByKey
groupByKey()
sortByKey()
val pets = sc.parallelize(

    List((“cat”, 1), (“dog”, 1), (“cat”, 2))

)

pets.reduceByKey(_ + _) // => {(cat, 3), (dog, 1)}

pets.groupByKey() // => {(cat, Seq(1, 2)), (dog, Seq(1)}

pets.sortByKey() // => {(cat, 1), (cat, 2), (dog, 1)}
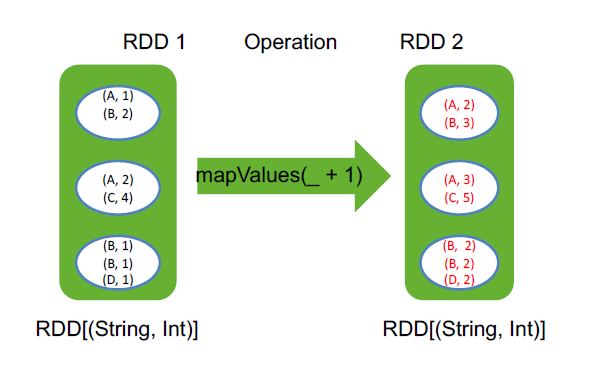
mapValues(_ + 1) mapvalues是忽略掉key,只把value进行操作
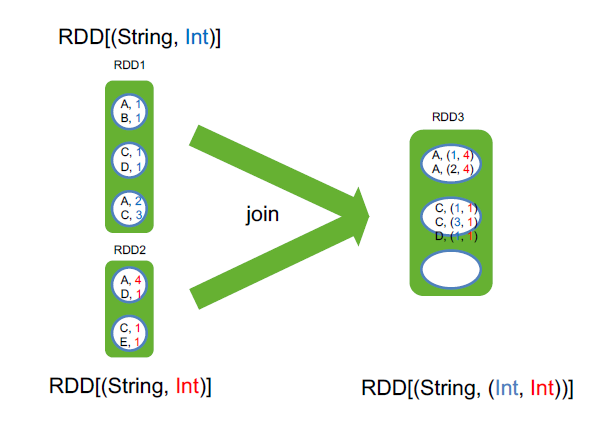
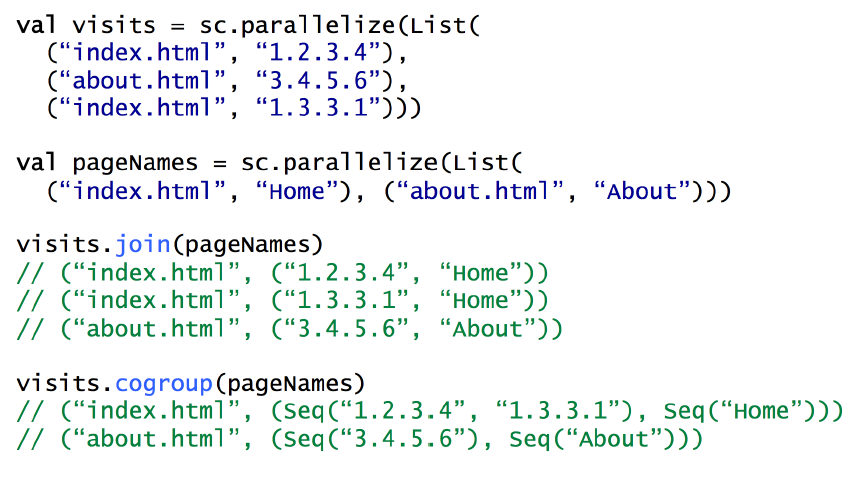
join RDD[(String, Int)].join(RDD[(String, Long)]) => RDD[(String, (Int, Long))]
join这两个rdd的value类型可以不一样,至于分区是根据hash来指定的
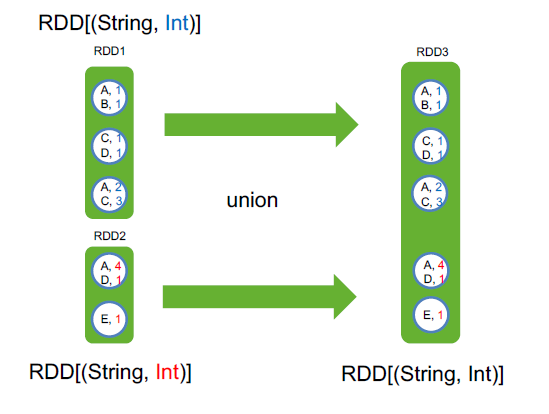
union
cogroup

用 cogroup 实现 join

sample() 从数据集中采样
cartesian() 求笛卡尔积
pipe() 传入一个外部程序
coalesce(口莱斯) 合并一个RDD的分区
rdd4 = rdd1 ++ rdd2 ++ rdd3
rdd4.coalesce(3)
rdd4.coalesce(3,true)
repartition 合并分区 rdd3.repartition(10)
并不是真的将分区合并,而是让一个task处理多个分区,如1k、10k、100k、1m、10m这五种文件,一共10w个,在hdfs上会有10w个block,取数据的时候会有10w个分区,同样有10w个task,这并不合适,如果能将这些分区合并,比如有10个task,每个task读1w个文件,速度会快很多,这个时候,有两种合并方式,coalesce和repartition
coalesce优点是简单粗暴,合并分区速度很快,缺点是很可能每个task所处理的数据不均匀。如果文件天生是比较均匀的,那coalesce合适
repartition优点是合并很均匀,用的是归并排序,缺点是计算开销比较大
举例,repartition合并的方法,10w个文件如何均匀的分成3个分区?
将每个文件均匀分成3分份,然后每一个分区从每个文件中拿一份
zip 将两个RDD的元素一一映射,合在一起
Action
collect()
take(2)
count()
reduce
foreach(println)
常用RDD的更多相关文章
- 08、Spark常用RDD变换
08.Spark常用RDD变换 8.1 概述 Spark RDD内部提供了很多变换操作,可以使用对数据的各种处理.同时,针对KV类型的操作,对应的方法封装在PairRDDFunctions trait ...
- 04、常用RDD操作整理
常用Transformation 注:某些函数只有PairRDD只有,而普通的RDD则没有,比如gropuByKey.reduceByKey.sortByKey.join.cogroup等函数要根据K ...
- Spark常用RDD操作总结
aggregate 函数原型:aggregate(zeroValue, seqOp, combOp) seqOp相当于Map combOp相当于Reduce zeroValue是seqOp每一个par ...
- 033 Java Spark的编程
1.Java SparkCore编程 入口是:JavaSparkContext 基本的RDD是:JavaRDD 其他常用RDD: JavaPairRDD JavaRDD和JavaPairRDD转换: ...
- Spark常用函数讲解之键值RDD转换
摘要: RDD:弹性分布式数据集,是一种特殊集合 ‚ 支持多种来源 ‚ 有容错机制 ‚ 可以被缓存 ‚ 支持并行操作,一个RDD代表一个分区里的数据集RDD有两种操作算子: Trans ...
- Spark学习之路(四)—— RDD常用算子详解
一.Transformation spark常用的Transformation算子如下表: Transformation算子 Meaning(含义) map(func) 对原RDD中每个元素运用 fu ...
- Spark 系列(四)—— RDD常用算子详解
一.Transformation spark 常用的 Transformation 算子如下表: Transformation 算子 Meaning(含义) map(func) 对原 RDD 中每个元 ...
- spark学习(10)-RDD的介绍和常用算子
RDD(弹性分布式数据集,里面并不存储真正要计算的数据,你对RDD的操作,他会在Driver端转换成Task,下发到Executor计算分散在多台集群上的数据) RDD是一个代理,你对代理进行操作,他 ...
- sparkRDD:第3节 RDD常用的算子操作
4. RDD编程API 4.1 RDD的算子分类 Transformation(转换):根据数据集创建一个新的数据集,计算后返回一个新RDD:例如:一个rdd进行map操作后生了一个新的rd ...
随机推荐
- 关于PostgreSQL的SQL注入必知必会
一.postgresql简介 postgresql是一款关系型数据库,广泛应用在web编程当中,由于其语法与MySQL不尽相同,所以其SQL注入又自成一派. 二.postgresql的SQL注入:(注 ...
- Memcached 之 .NET(C#)实例分析
一:Memcached的安装 step1. 下载memcache(http://jehiah.cz/projects/memcached-win32)的windows稳定版(这里我下载了memcach ...
- 基于Consul+Upsync+Nginx实现动态负载均衡
基于Consul+Upsync+Nginx实现动态负载均衡 1.Consul环境搭建 下载consul_0.7.5_linux_amd64.zip到/usr/local/src目录 cd /usr/l ...
- 数组和对象常用API
数组API: 1. forEach 遍历所有元素 var arr = [1,2,3] arr.forEach(function(item,index){ // 遍历数组的所有元素 console.lo ...
- 160314、MVC设计模式
MVC的由来 精彩内容 MVC模式最早由Trygve Reenskaug在1978年提出 ,是施乐帕罗奥多研究中心(Xerox PARC)在20世纪80年代为程序语言Smalltalk发明的一种软件设 ...
- Java中static关键字用法总结
1. 静态方法 通常,在一个类中定义一个方法为static,那就是说,无需本类的对象即可调用此方法 声明为static的方法有以下几条限制: · 它们仅能调用其他的static 方法. · ...
- Struts2中的拦截器详解
exception:异常拦截器,拦截异常aliasservletConfig18nprepare:预备拦截器,这个拦截器就是为了ModelDriven准备对象的,若Action类实现了preparab ...
- Redis集群部署文档(Ubuntu15.10系统)
Redis集群部署文档(Ubuntu15.10系统)(要让集群正常工作至少需要3个主节点,在这里我们要创建6个redis节点,其中三个为主节点,三个为从节点,对应的redis节点的ip和端口对应关系如 ...
- MYSQL--表分区、查看分区(转)
一. mysql分区简介 数据库分区 数据库分区是一种物理数据库设计技术.虽然分区技术可以实现很多效果,但其主要目的是为了在特定的SQL操作中减少数据读写的总量以缩减sql语句的响应时间, ...
- Ubentu下安装Docker
具体可以查看Docker官网,我是在服务器上面操作 1,sudo apt-get install -y apt-transport-https ca-certificates curl softwar ...