
Kafka学习笔记(2)----Kafka的架构
1. 架构图
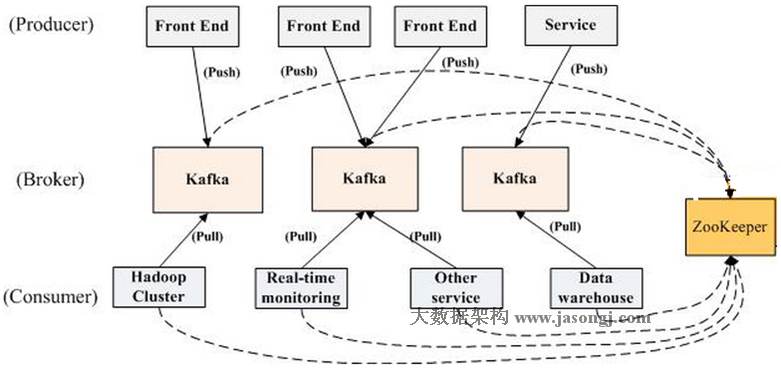
一个Kafka集群中包含若干个Broker(消息实例),Kafka支持Broker横向扩展,Broker越多,吞吐量越大,同时也包含了若干个Producer(可以是web前端产生的Page View,或者是服务器日志,系统CPU、Memory等)和若干个Consumer(消费者)以及一个zookeeper集群,Kafka通过Zookeeper管理集群配置,选举leader,以及在Consumer Group发生变化时进行rebalance。Producer使用push模式将消息发布到broker,Consumer使用pull模式从broker订阅并消费消息。
2. Topic和Partition


Topic:是一个逻辑的概念,它可以认为类似于其他中间件中queue的概念,作为一组消息的一个集合,跟其他的消息中间件一样,每个消息的发送或者是消费都必须要指定Topic,表明将消息存在哪个Topic中。一个Topic可以接受多个Producer发送的消息和被多个Consumer消费。
Partition:了使得Kafka的吞吐率可以线性提高,物理上把Topic分成一个或多个Partition,每个Partition在物理上对应一个文件夹,该文件夹下存储这个Partition的所有消息和索引文件,同意Topic下不同分区包含的消息是不同的,当每个消息发送到分区时,都会分配到一个offset(偏移量)它是消息在此分区中的唯一编号,kafka通过offset保证消息在分区内的顺序,offset的顺序不跨分区,即kafka只保证在同一个分区内的消息是有序的;Partition是以文件的形式存储在文件系统中,存储在kafka-log目录下,命名规则为<topic_name>-<partition_id>,如新建一个Topic,

查看kafka_log目录

3. kafka高吞吐量的原因
因为每条消息都被append到该Partition中,属于顺序写磁盘,因此效率非常高,顺序写磁盘效率比随机写内存还要高,这是Kafka高吞吐率的一个很重要的保证。
对于传统的message queue而言,一般会删除已经被消费的消息,而Kafka集群会保留所有的消息,无论其被消费与否。当然,因为磁盘限制,不可能永久保留所有数据(实际上也没必要),因此Kafka提供两种策略删除旧数据。一是基于时间,二是基于Partition文件大小。例如可以通过配置$KAFKA_HOME/config/server.properties,让Kafka删除一周前的数据,也可在Partition文件超过1GB时删除旧数据,配置如下所示。
#The minimum age of a log file to be eligible for deletion

log.retention.hours=

# The maximum size of a log segment file. When this size is reached a new log segment will be created.

log.segment.bytes=

# The interval at which log segments are checked to see if they can be deleted according to the retention policies

log.retention.check.interval.ms=

# If log.cleaner.enable=true is set the cleaner will be enabled and individual logs can then be marked for log compaction.

log.cleaner.enable=false
因为Kafka读取特定消息的时间复杂度为O(1),即与文件大小无关,所以这里删除过期文件与提高Kafka性能无关。选择怎样的删除策略只与磁盘以及具体的需求有关。另外,Kafka会为每一个Consumer Group保留一些metadata信息——当前消费的消息的position,也即offset。这个offset由Consumer控制。正常情况下Consumer会在消费完一条消息后递增该offset。当然,Consumer也可将offset设成一个较小的值,重新消费一些消息。因为offset由Consumer控制,所以Kafka broker是无状态的,它不需要标记哪些消息被哪些消费过,也不需要通过broker去保证同一个Consumer Group只有一个Consumer能消费某一条消息,因此也就不需要锁机制,这也为Kafka的高吞吐率提供了有力保障。
在异步消息发送模式中,kafka允许进行批量发送,也就是先讲消息缓存到内存中,然后一次请求批量发送出去。这样减少了磁盘频繁io以及网络IO造成的性能瓶颈。
零拷贝也是提高吞吐量的一个点。
Kafka学习笔记(2)----Kafka的架构的更多相关文章
- Kafka学习笔记之Kafka背景及架构介绍
0x00 概述 本文介绍了Kafka的创建背景,设计目标,使用消息系统的优势以及目前流行的消息系统对比.并介绍了Kafka的架构,Producer消息路由,Consumer Group以及由其实现的不 ...
- Kafka学习笔记(三)——架构深入
之前搭建好了Kafka的学习环境,了解了具体的配置文件内容,并且测试了生产者.消费者的控制台使用方式,也学习了基本的API.那么下一步,应该学习一下具体的内部流程~ 1.Kafka的工作流程 大致的工 ...
- Kafka学习笔记之Kafka性能测试方法及Benchmark报告
0x00 概述 本文主要介绍了如何利用Kafka自带的性能测试脚本及Kafka Manager测试Kafka的性能,以及如何使用Kafka Manager监控Kafka的工作状态,最后给出了Kafka ...
- Kafka学习笔记之Kafka三款监控工具
0x00 概述 在之前的博客中,介绍了Kafka Web Console这 个监控工具,在生产环境中使用,运行一段时间后,发现该工具会和Kafka生产者.消费者.ZooKeeper建立大量连接,从而导 ...
- Kafka学习笔记之Kafka Consumer设计解析
0x00 摘要 本文主要介绍了Kafka High Level Consumer,Consumer Group,Consumer Rebalance,Low Level Consumer实现的语义,以 ...
- 【kafka学习笔记】kafka的基本概念
在了解了背景知识后,我们来整体看一下kafka的基本概念,这里不做深入讲解,只是初步了解一下. kafka的消息架构 注意这里不是设计的架构,只是为了方便理解,脑补的三层架构.从代码的实现来看,kaf ...
- Kafka学习笔记之Kafka High Availability(下)
0x00 摘要 本文在上篇文章基础上,更加深入讲解了Kafka的HA机制,主要阐述了HA相关各种场景,如Broker failover,Controller failover,Topic创建/删除,B ...
- Kafka学习笔记之Kafka High Availability(上)
0x00 摘要 Kafka在0.8以前的版本中,并不提供High Availablity机制,一旦一个或多个Broker宕机,则宕机期间其上所有Partition都无法继续提供服务.若该Broker永 ...
- Kafka学习笔记1——Kafka的安装和启动
一.准备工作 1. 安装JDK 可以用命令 java -version 查看版本
- Kafka学习笔记之Kafka自身操作日志的清理方法(非Topic数据)
0x00 概述 本文主要讲Kafka自身操作日志的清理方法(非Topic数据),Topic数据自己有对应的删除策略,请看这里. Kafka长时间运行过程中,在kafka/logs目录下产生了大量的ka ...
随机推荐
- 配平化学方程式的C++代码实现
配平化学方程式的C++代码实现 纪念一下我今天写过了 20171006. (去年的这个时候我就有了这个大胆的想法, 当时的思路是:字符串处理->暴力搜系数,可是太年轻写不对,我那会还是个只会模拟 ...
- 函数(day08)
C语言里可以采用分组的方式管理语句 每个语句分组叫做一个函数 多函数程序执行的时候时间分配情况必须 遵守以下规则 .整个程序的执行时间被划分成几段,每段 时间都被分配给一个函数使用 .不同时间段不能互 ...
- vue 对图片进行拖拽到另一个位置
1.拖动元素代码: 使用html5原生拖拽属性,在需要拖拽的图片中添加draggable="true"属性,并使用v-on添加拖动事件 2.被放置的区域事件代码: 使用html5原 ...
- python orm框架-----SQLALchemy-查询篇
似乎ORM最难设计的部分是查询.特别是面向对象的查询,今天学习SQLAlchemy,发现SQLAlchemy的查询语法竟如此灵活,惊叹其如此强大的表达能力的同时也对Python也有了更深的认识.下面看 ...
- Python 实现 Excel 里单元格的读写与清空操作
#coding=utf-8 # coding=utf-8 作用是声明python代码的文本格式是utf-8,python按照utf-8的方式来读取程序. # 如果不加这个声明,无论代码中还是注释中有中 ...
- ExtJs之Ext.ElementLoader.load
稍微书上代码不适合. var btns = Ext.select('input'); 需要更改为: var btns = Ext.select('input', true); 不然报错: [E] Ex ...
- 【slighttpd】基于lighttpd架构的Server项目实战(6)—预备知识之Http
接下来,我们開始http部分的开发. 在此之前.有必要先学习一下HTTP协议- http1.1 的rfc文档:http://www.ietf.org/rfc/rfc2616.txt 简单介绍 超文本传 ...
- IOS - 查找未使用的图片
实现细节都在代码里面, 帮助 -h. # -*- coding: utf-8 -*- """ 检查IOS应用图片是否使用 1. 读取有效文件: 图片(.png, .jpg ...
- 国内物联网平台初探(五) ——机智云IoT物联网云服务平台及智能硬件自助开发平台
平台定位 机智云平台是致力于物联网.智能硬件云服务的开放平台.平台提供了从定义产品.设备端开发调试.应用开发.产测.运营管理等覆盖智能硬件接入到运营管理全生命周期服务的能力. 机智云平台为开发者提供了 ...
- HP Z240组建磁盘阵列RAID1