
Python Scrapy 爬取煎蛋网妹子图实例(二)
上篇已经介绍了 图片的爬取,后来觉得不太好,每次爬取的图片 都在一个文件下,不方便区分,且数据库中没有爬取的时间标识,不方便后续查看 数据时何时爬取的,所以这里进行了局部修改
修改一:修改爬虫执行方式
之前爬虫的执行 是通过在终端输入命令:scrapy crawl spiderName 执行
缺点:
1、需要记住并输入命令;
2、需要在终端切换到爬虫上一级目录下执行。
创建执行入口
如图
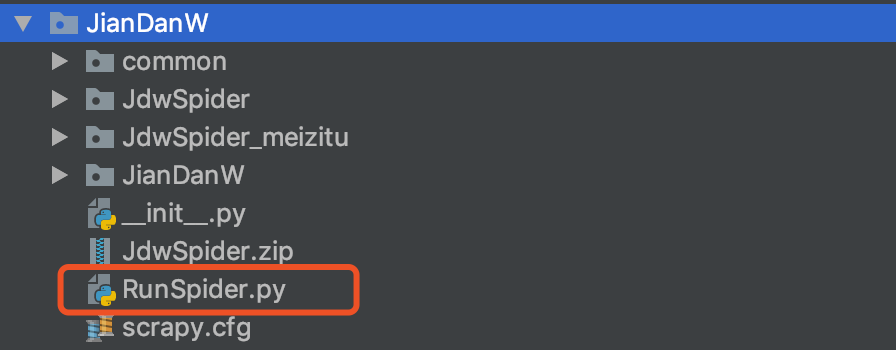
代码如下
# FileName : RunSpider.py

# Author   : Adil

# DateTime : 2018/12/4 2:51 PM

# SoftWare : PyCharm

from scrapy.crawler import CrawlerProcess

from scrapy.utils.project import get_project_settings

process = CrawlerProcess(get_project_settings())

# 此处添加 执行爬虫 名字,具体可以查看 源码

process.crawl('JdwSpider')

process.start()
修改二:修改图片存放路径
之前是在执行路径下依照spiderName 创建了一个文件夹,用来存放图片。
缺点:
1、每次执行爬虫所有图片都会存放在该文件下,日积月累,图片会越来越多,不方便查找和归类
创建新的文件路径
根据爬取日期创建文件进而分类,方便查看不同时间对应的爬取结果
展示结果如下:

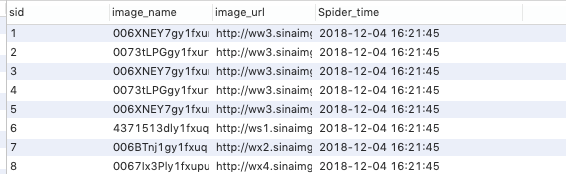
修改三:数据增加爬取时间
如图,方便以爬取时间进行区分爬取内容。
最后修改后代码如下:
# -*- coding: utf-8 -*-

# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: https://doc.scrapy.org/en/latest/topics/item-pipeline.html

import os

import urllib

import time

import common.DBHandle as DBHandle

class JiandanwPipeline(object):

    def __init__(self):

        '''

        初始化文件路径及 爬取时间

        '''

        # 获取当前路径

        currentPath = os.getcwd()

        # 拼接图片存放路径

        file_path = os.path.join(currentPath, 'JdwSpider')

        # 增加 按日期创建文件

        localTime = time.localtime(time.time())

        localTimeStrs = time.strftime("%Y-%m-%d %H:%M:%S", localTime)

        # 再次拼接路径

        file_path = os.path.join(file_path, localTimeStrs)

        if not os.path.exists(file_path):

            os.makedirs(file_path)

        # 初始化 两个 变量,方便 后面的 方法使用

        self.file_path = file_path

        self.localTimeStrs = localTimeStrs

        # 数据库连接 这里的 数据库信息,因为是本地数据库,后面如果是公司数据库 不方便透露的话,可以存放到配置文件中

        host = '127.0.0.1'

        username = 'adil'

        password = 'helloyyj'

        database = 'AdilTest'

        port = 3306

        # 实例化 数据库 连接

        self.DbHandle = DBHandle.DataBaseHandle(host, username, password, database, port)

    def process_item(self, item, spider):

        ''' 爬虫文件数据处理函数 '''

        # 这里是一页 算一个 item ,所以如果 将 文件信息 写在这里,会导致一页创建一次,所以 放在初始化函数内进行

        # # 获取当前路径

        # currentPath = os.getcwd()

        # # 拼接图片存放路径

        # file_path = os.path.join(currentPath, spider.name)

        #

        # # 增加 按日期创建文件

        # localTime = time.localtime(time.time())

        # localTimeStrs = time.strftime("%Y-%m-%d %H:%M:%S", localTime)

        # # 再次拼接路径

        # file_path = os.path.join(file_path, localTimeStrs)

        #

        # if not os.path.exists(file_path):

        #     os.makedirs(file_path)

        for image_url in item['image_urls']:

            # 截图图片链接

            list_name = image_url.split('/')

            # 获取图片名称

            file_name = list_name[len(list_name) - 1]  # 图片名称

            # 补全图片路径

            path_name = os.path.join(self.file_path,file_name)

            # 获取有效的url 因为 image_url = //wx4.sinaimg.cn/mw600/66b3de17gy1fxo6jis4iej21ma0u0x6r.jpg

            image_url = 'http:' + image_url

            # 此处执行 数据库插入,将 图片名称、url 插入到数据库   注意 这里的 values('占位符 一定要用 引号引起来,要不然执行不成功,血的教训')

            sql = "insert into JdwSpider(image_name,image_url,Spider_time) values ('%s','%s','%s')" % (file_name,image_url,self.localTimeStrs)

            # 如果不执行插入,可以注释改该行代码

            self.DbHandle.insertDB(sql)

            # 图片保存

            with open(path_name, 'wb') as file_writer:

                conn = urllib.request.urlopen(image_url)  # 下载图片

                # 保存图片

                file_writer.write(conn.read())

            file_writer.close()

        return item

    def close_spider(self,spider):

        ''' 定义爬虫结束处理函数  此处会在 爬虫结束后执行该方法 '''

        # 关闭数据库,

        print('****'*50)

        print('数据库关闭')

        self.DbHandle.closeDb()
Python Scrapy 爬取煎蛋网妹子图实例(二)的更多相关文章
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- python爬虫–爬取煎蛋网妹子图片
前几天刚学了python网络编程,书里没什么实践项目,只好到网上找点东西做. 一直对爬虫很好奇,所以不妨从爬虫先入手吧. Python版本:3.6 这是我看的教程:Python - Jack -Cui ...
- python爬虫爬取煎蛋网妹子图片
import urllib.request import os def url_open(url): req = urllib.request.Request(url) req.add_header( ...
- Python 爬虫 爬取 煎蛋网 图片
今天, 试着爬取了煎蛋网的图片. 用到的包: urllib.request os 分别使用几个函数,来控制下载的图片的页数,获取图片的网页,获取网页页数以及保存图片到本地.过程简单清晰明了 直接上源代 ...
- Python 爬取煎蛋网妹子图片
#!/usr/bin/env python # -*- coding: utf-8 -*- # @Date : 2017-08-24 10:17:28 # @Author : EnderZhou (z ...
- selenium爬取煎蛋网
selenium爬取煎蛋网 直接上代码 from selenium import webdriver from selenium.webdriver.support.ui import WebDriv ...
- python3爬虫爬取煎蛋网妹纸图片(上篇)
其实之前实现过这个功能,是使用selenium模拟浏览器页面点击来完成的,但是效率实际上相对来说较低.本次以解密参数来完成爬取的过程. 首先打开煎蛋网http://jandan.net/ooxx,查看 ...
- scrapy从安装到爬取煎蛋网图片
下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/pip install wheelpip install lxmlpip install pyopens ...
- 爬虫实例——爬取煎蛋网OOXX频道(反反爬虫——伪装成浏览器)
煎蛋网在反爬虫方面做了不少工作,无法通过正常的方式爬取,比如用下面这段代码爬取无法得到我们想要的源代码. import requests url = 'http://jandan.net/ooxx' ...
随机推荐
- API网关性能比较:NGINX vs. ZUUL vs. Spring Cloud Gateway vs. Linkerd(转)
前几天拜读了 OpsGenie 公司(一家致力于 Dev & Ops 的公司)的资深工程师 Turgay Çelik 博士写的一篇文章(链接在文末),文中介绍了他们最初也是采用 Nginx 作 ...
- Vmware 安装centos7与网络配置
一.下载linux镜像 下载地址:http://isoredirect.centos.org/centos/7/isos/x86_64/CentOS-7-x86_64-DVD-1804.iso 二.创 ...
- CIL锁,GIL与线程池的区别,进程池和线程池,同步与异步
一.GIL锁 什么是GIL? 全局解释器锁,是加在解释器上的互斥锁 GC是python自带的内存管理机制,GC的工作原理:python中的内存管理使用的是应用计数,每个数会被加上一个整型的计数器,表示 ...
- 纯注解方式配置spring+springMVC
1.新建类initConfig,继承AbstractAnnotationConfigDispatcherServletInitializer,并重写getRootConfigClasses().get ...
- 做了一道cf水题
被一道cf水题卡了半天的时间,主要原因时自己不熟悉c++stl库的函数,本来一个可以用库解决的问题,我用c语言模拟了那个函数半天,结果还超时了. 题意大概就是,给定n个数,查询k次,每次查询过后,输出 ...
- Python3基础 list + *运算 扩充列表
Python : 3.7.0 OS : Ubuntu 18.04.1 LTS IDE : PyCharm 2018.2.4 Conda ...
- MongDB 数据库使用技巧及注意事项
说明 本文记录MongoDB数据库的使用技巧总结,特性发现. 利用TTL特性实现数据定时删除 限制: 你不能创建TTL索引,如果要索引的字段已经在其他索引中使用. 索引不能包含多个字段. 索引的字段必 ...
- Spring核心简介
Spring简介 Spring是一个开源.轻量级框架.在诞生之初,创建Spring的主要目的是用来替代更加重量级的企业级Java技术,尤其是EJB(Enterprise JavaBean).从最初的挑 ...
- ocacle sql: 两张表左连接 ,1对多,取一条数据,取按时间最新的
说明: MBGL_GZJH jh_id 对应 mbgl_gzjh_fkmx jh_id mbgl_gzjh_fkmx jh_id 有重复多条,但是 FKRQ 不一样,我们去 FKRQ 最新的一条. s ...
- 给Ubuntu添加清华的软件源
找到 sources.list 文件 cd /etc/apt/ 编辑 vim sources.list 在最后面加上下面这几条语句 # 默认注释了源码镜像以提高 apt update 速度,如有需要可 ...