
DataNode的工作机制
DataNode的工作机制
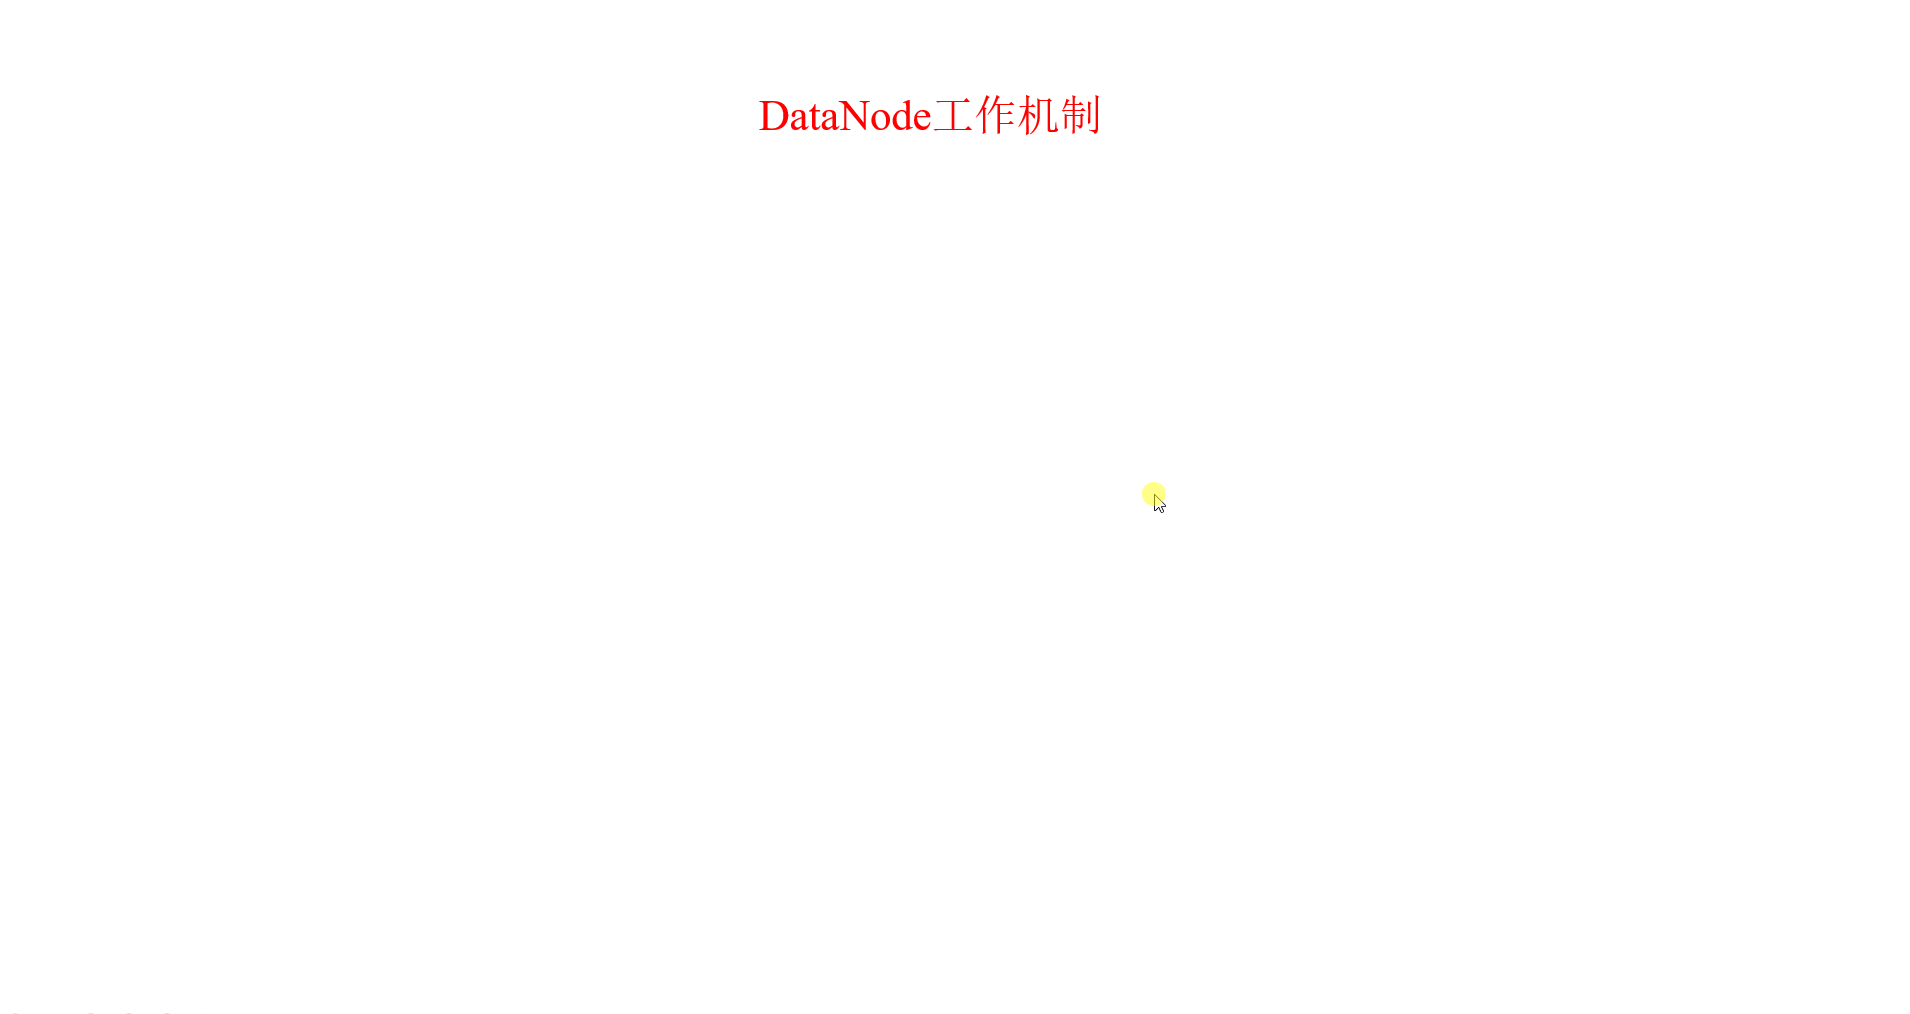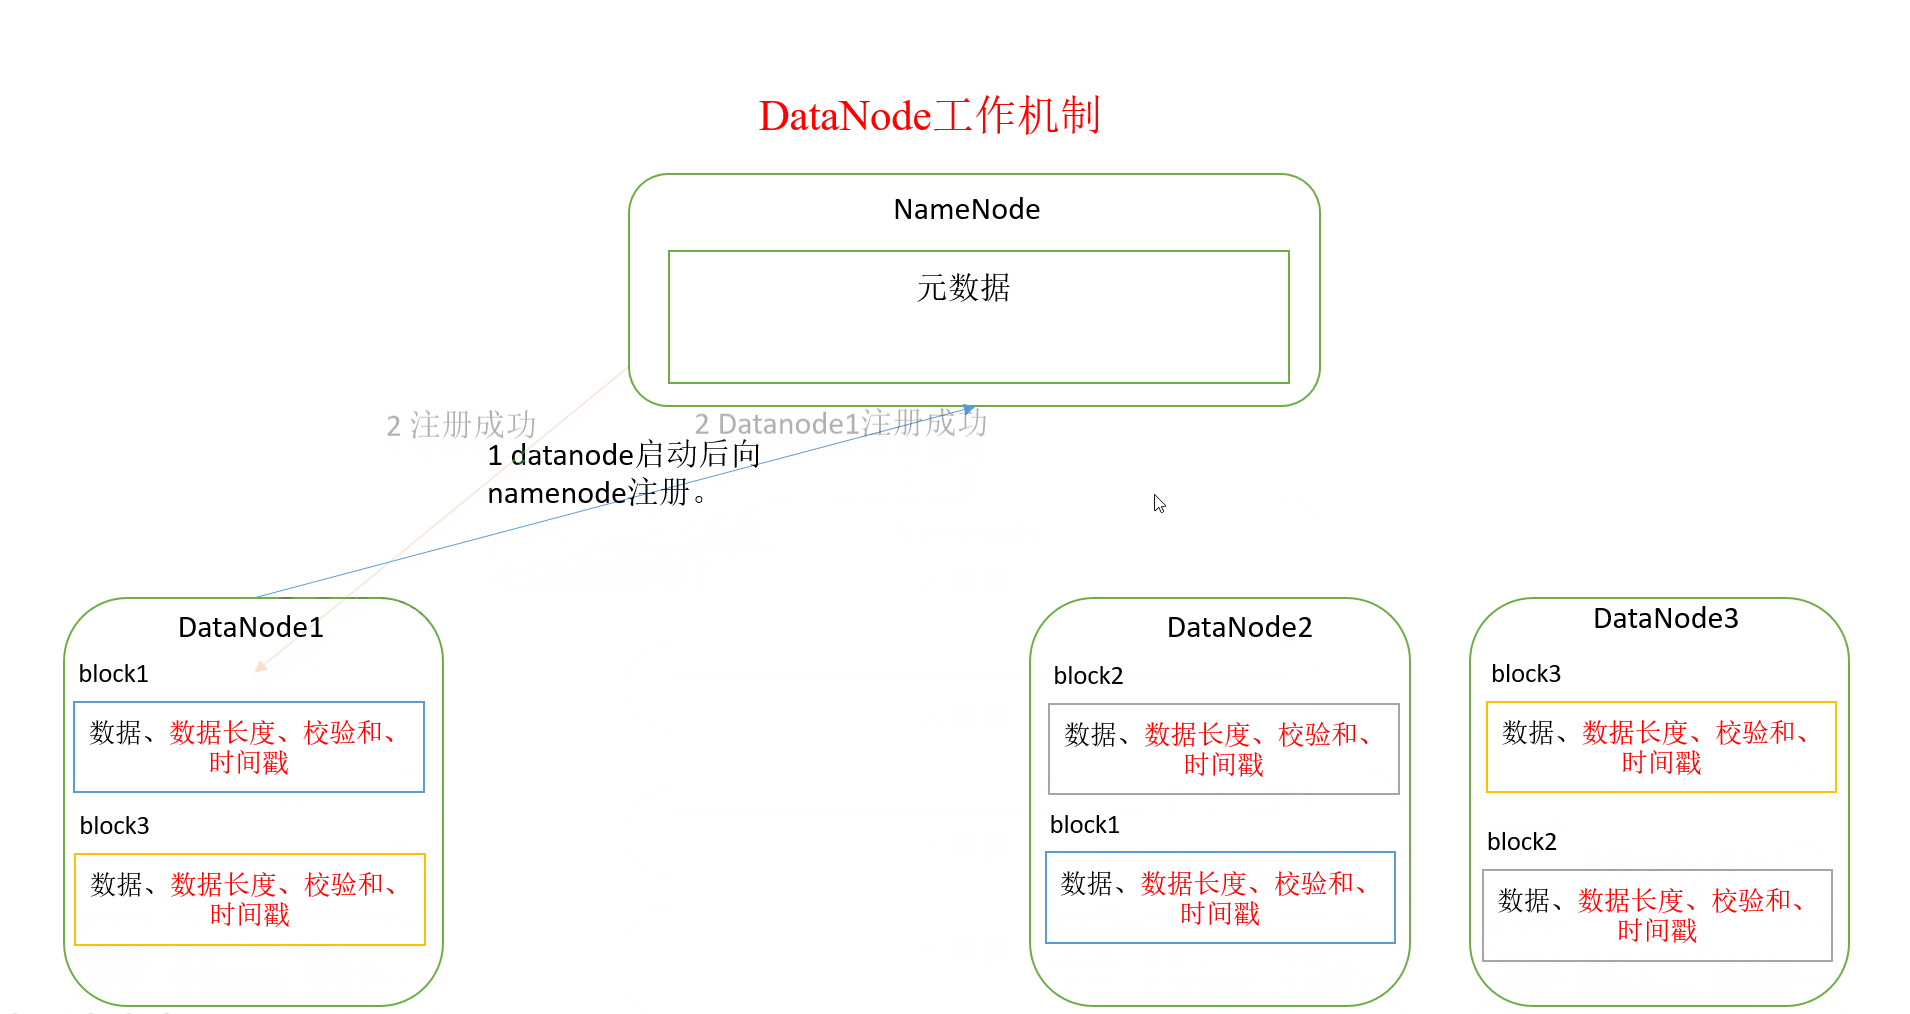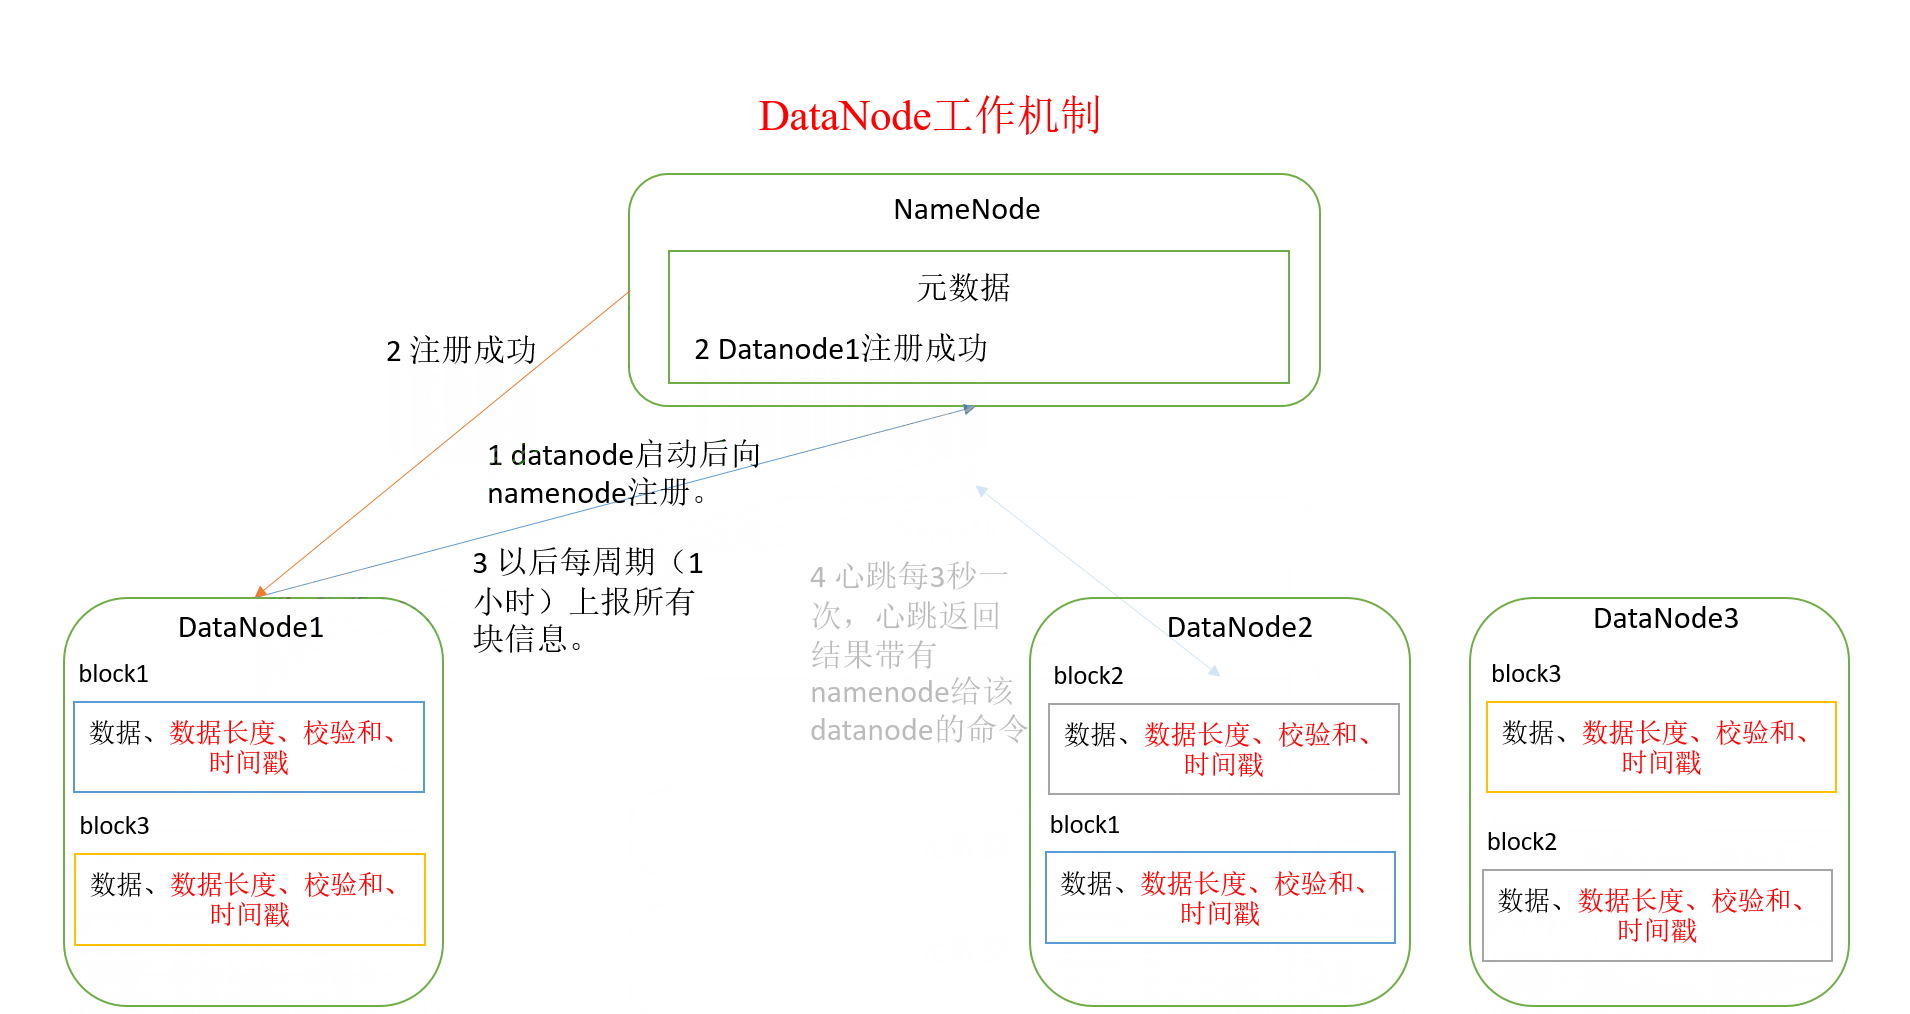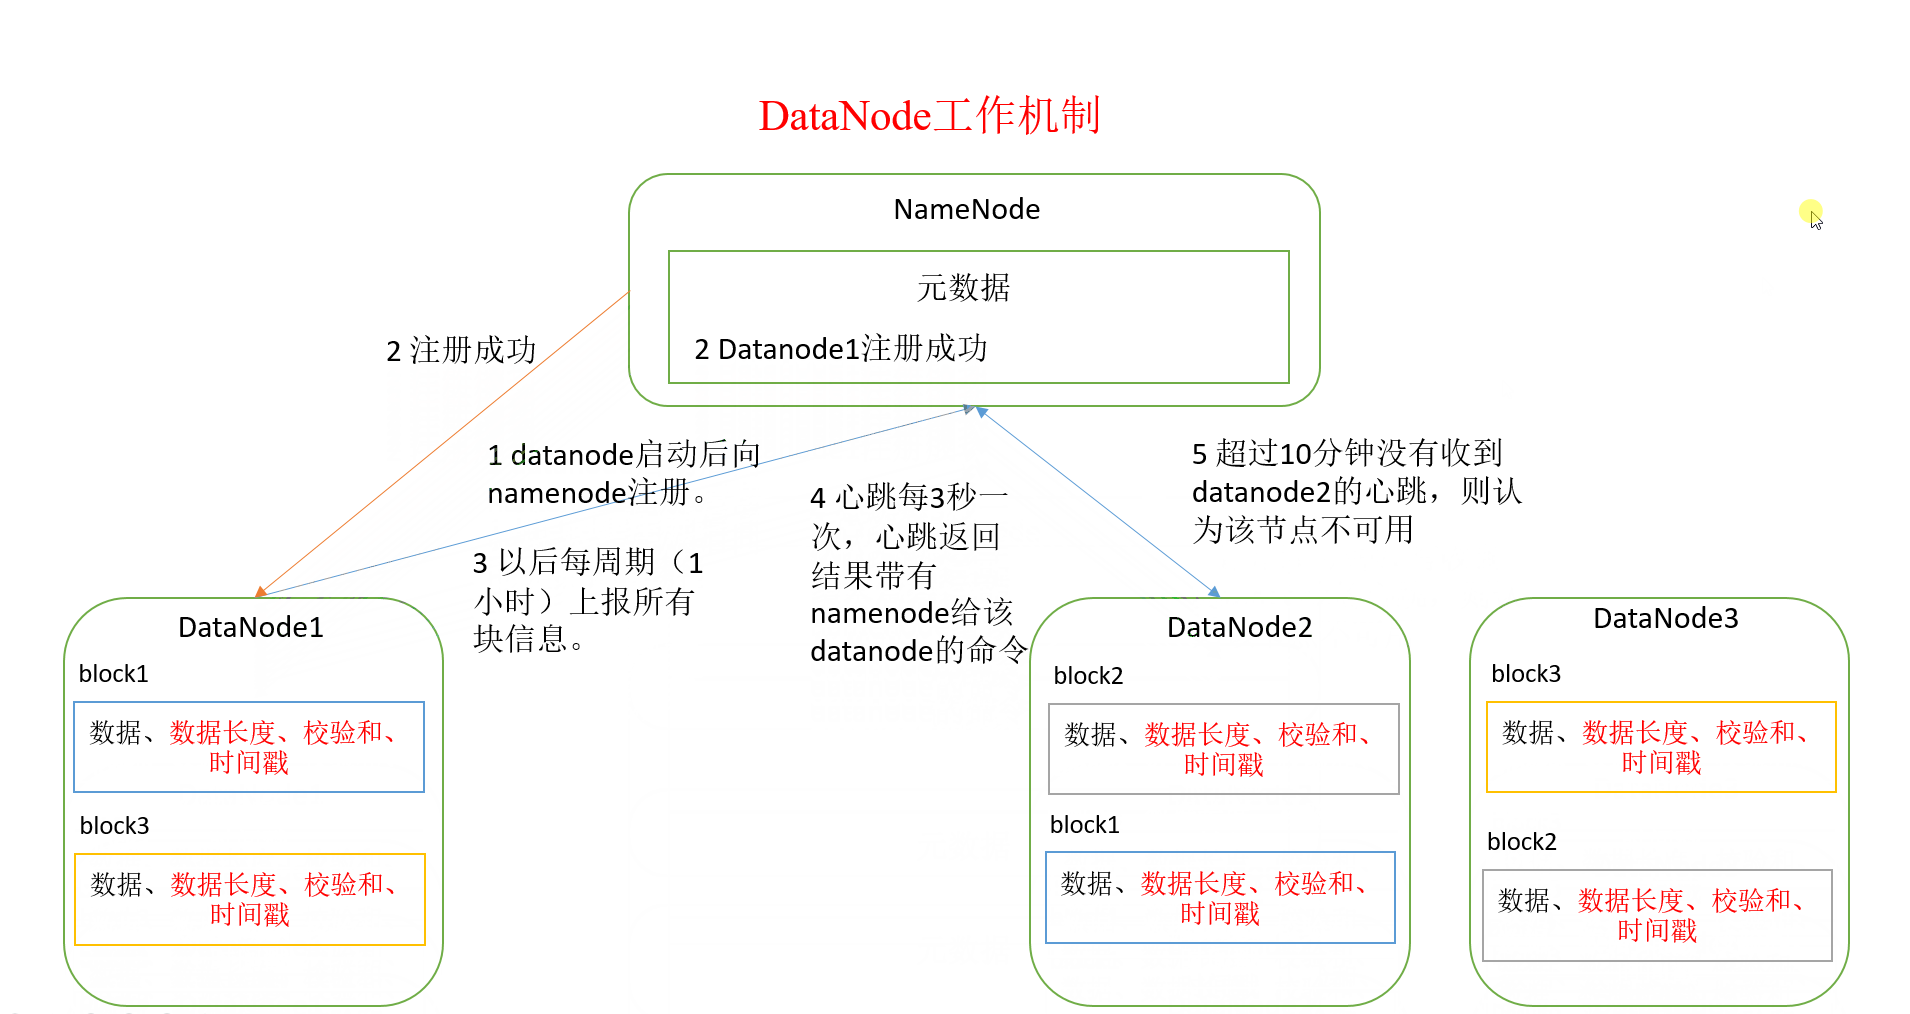
一个数据块在DataNode以文件的形式在磁盘上保存,分为两个文件,一个是数据本身,

一个是元数据信息(包括数据的长度,校验和,时间戳)

1.DataNode启动后,向NameNode进行注册

2.NameNode返回注册成功

3.以后按照每周期(1小时)上报所有块信息

4.心跳每3秒一次,心跳返回带有NameNode给DataNode的命令

5.超过10分钟+timestamp(可配置)没有接收到心跳包,那么认定该接点不可用
掉线时限参数设置
datanode 进程死亡或者网络故障造成 datanode 无法与 namenode 通信,namenode 不会立

即把该节点判定为死亡,要经过一段时间,这段时间暂称作超时时长。HDFS 默认的超时时

长为 10 分钟+30 秒。如果定义超时时间为 timeout,则超时时长的计算公式为:

timeout = 2 * dfs.namenode.heartbeat.recheck-interval + 10 * dfs.heartbeat.interval。

而默认的 dfs.namenode.heartbeat.recheck-interval 大小为 5 分钟,dfs.heartbeat.interval 默

认为 3 秒。

需要注意的是 hdfs-site.xml 配置文件中的 heartbeat.recheck.interval 的单位为毫秒,

dfs.heartbeat.interval 的单位为秒。

	<property>

		<name>dfs.namenode.heartbeat.recheck-interval</name>

		<value>300000</value>

	</property>

	<property>

		<name> dfs.heartbeat.interval </name>

		<value>3</value>

	</property>
服役新数据节点
在原有集群基础上动态添加新的数据节点
步骤:

	(1)在 namenode 的/opt/module/hadoop-2.7.2/etc/hadoop 目录下创建 dfs.hosts 文件

		$ pwd

		/opt/module/hadoop-2.7.2/etc/hadoop

		$ touch dfs.hosts

		$ vi dfs.hosts

		添加主机名称(包含新服役的节点)

	(2)在 namenode 的 hdfs-site.xml 配置文件中增加 dfs.hosts 属性

		<property>

			<name>dfs.hosts</name>

			<value>/opt/module/hadoop-2.7.2/etc/hadoop/dfs.hosts</value>

		</property>

	(3)刷新 namenode

		$ hdfs dfsadmin -refreshNodes

		Refresh nodes successful

	(4)更新 resourcemanager 节点

		$ yarn rmadmin -refreshNodes

		19/03/24 14:17:11 INFO client.RMProxy: Connecting to ResourceManager athostname/ip:8033

	(5)在 namenode 的 slaves 文件中增加新主机名称(不需要分发)

	(6)单独命令启动新的数据节点和节点管理器

		$ sbin/hadoop-daemon.sh start datanode

		$ sbin/yarn-daemon.sh start nodemanager

	(7)在 web 浏览器上检查是否 ok

如果数据不均衡,可以用命令实现集群的再平衡

		102:$ ./start-balancer.sh
退役旧节点
步骤:

	(1)在 namenode 的/opt/module/hadoop-2.7.2/etc/hadoop 目录下创建 dfs.hosts.exclude 文件

		$ pwd

		/opt/module/hadoop-2.7.2/etc/hadoop

		$ touch dfs.hosts.exclude

		$ vi dfs.hosts.exclude

		添加主机名称(要退役的节点)

	(2)在 namenode 的 hdfs-site.xml 配置文件中增加 dfs.hosts.exclude 属性

		<property>

			<name>dfs.hosts.exclude</name>

			<value>/opt/module/hadoop-2.7.2/etc/hadoop/dfs.hosts.exclude</value>

		</property>

	(3)刷新 namenode、刷新 resourcemanager

		$ hdfs dfsadmin -refreshNodes

		Refresh nodes successful

		$ yarn rmadmin -refreshNodes

	(4)检查 web 浏览器,退役节点的状态为 decommission in progress(退役中),说明数据节点正在复制块到其他节点

	(5)等待退役节点状态为 decommissioned(所有块已经复制完成),停止该节点及节点资源管理器。

		注意:如果副本数是 3,服役的节点小于等于 3,是不能退役成功的,需要修改副本数后才能退役。

如果失败:

		$ sbin/hadoop-daemon.sh stop datanode

		$ sbin/yarn-daemon.sh stop nodemanager

6)从 include 文件中删除退役节点,再运行刷新节点的命令

	(1)从 namenode 的 dfs.hosts 文件中删除退役节点

	(2)刷新 namenode,刷新 resourcemanager

7)从 namenode 的 slave 文件中删除退役节点 hadoop105

8)如果数据不均衡,可以用命令实现集群的再平衡
DataNode多目录配置
DataNode也可以配置成多个目录,每个目录存储的数据不一样。即:数据不是副本
hdfs-site.xml:

	<property>

		<name>dfs.datanode.data.dir</name>

		<value>file:///${hadoop.tmp.dir}/dfs/data1,file:///${hadoop.tmp.dir}/dfs/data2</value>

	</property>
本博客仅为博主学习总结,感谢各大网络平台的资料。蟹蟹!!
DataNode的工作机制的更多相关文章
- Hadoop_10_HDFS 的 DataNode工作机制
1.DataNode的工作机制: 1.DataNode工作职责:存储管理用户的文件块数据 定期向namenode汇报自身所持有的block信息(通过心跳信息上报) (这点很重要,因为,当集群中发生某 ...
- Hadoop的namenode的管理机制,工作机制和datanode的工作原理
HDFS前言: 1) 设计思想 分而治之:将大文件.大批量文件,分布式存放在大量服务器上,以便于采取分而治之的方式对海量数据进行运算分析: 2)在大数据系统中作用: 为各类分布式运算框架(如:mapr ...
- hdfs namenode/datanode工作机制
一. namenode工作机制 1. 客户端上传文件时,namenode先检查有没有同名的文件,如果有,则直接返回错误信息.如果没有,则根据要上传文件的大小以及block的大小,算出需要分成几个blo ...
- DataNode 工作机制
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明.本文链接:https://blog.csdn.net/qq_35641192/article/d ...
- HDFS中DataNode工作机制
1.DataNode工作机制 1)一个数据块在datanode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据(包括数据块的长度,块数据的校验和,以及时间戳). 2)DataNod ...
- Hadoop框架:DataNode工作机制详解
本文源码:GitHub·点这里 || GitEE·点这里 一.工作机制 1.基础描述 DataNode上数据块以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是数据块元数据包括长度.校验.时 ...
- Hadoop(五)—— HDFS NameNode、DataNode工作机制
一.NN与2NN工作机制 NameNode(NN) 1.当HDFS启动时,会加载日志(edits)和镜像文件(fsImage)到内存中. 2-4.当元数据的增删改查请求进来时,NameNode会先将操 ...
- 云计算分布式大数据Hadoop实战高手之路第七讲Hadoop图文训练课程:通过HDFS的心跳来测试replication具体的工作机制和流程
这一讲主要深入使用HDFS命令行工具操作Hadoop分布式集群,主要是通过实验的配置hdfs-site.xml文件的心跳来测试replication具体的工作和流程. 通过HDFS的心跳来测试repl ...
- 1 weekend110的NN元数据管理机制 + NN工作机制 + DN工作原理
第一天的笔记,是伪分布hadoop集群搭建, 后面是hadoop Ha的分布式集群搭建 第一天,是HDFS的shell操作 NN工作机制 里面是二进制 DN工作原理 上传完了之后,在hdfs的虚拟路径 ...
随机推荐
- 教你如何快速使用Github
以前看过几篇github的使用教程,感觉还是不是很清晰,自从看到了这篇,通俗易懂,也学会基本的使用了,在此为大家推荐.(转自知乎,为了能让更多的人看到,请允许我使用 “原创”,如果侵权请联系.) Gi ...
- OpenSSL所有版本的变化,从1.1开始架构有所变化,生成的lib名称也有所不同了,以及对Qt的影响
The complete explanation is that 1.0.x and 1.1.x do not have the same naming conventions for the gen ...
- getch(),getche(),getchar()的区别
先说基本区别. (1) getch()和getche()函数 这两个函数都是从键盘上读入一个字符.其调用格式为: getch(); getche(); 两者的区别是 ...
- CentOS7下group和group-、passwd与passwd-之间的区别
今天查看/etc/group时,意外发现另外一个/etc/group-,查看了一下2个文件,发现大部分内容是一致的.这就有点搞不懂了,后面这个group是有啥用呢呢?diff对比了一下,相比group ...
- 最短JS判断IE6/IE7/IE8系列的写法
常用的 var isIE=!!window.ActiveXObject; var isIE6=isIE&&!window.XMLHttpRequest; var isIE8=isIE& ...
- 在 .pro里加入 QMAKE_CXXFLAGS += /MP 将并行编译(VC),加快编译速度(姚冬的办法),或者-j4参数(MinGW)
但是只对VC编译器有效果. 另外还可以自己设置stdafx.h文件 http://www.zhihu.com/question/23045749 C:\Qt\Qt5.6.2_static\bin\qm ...
- 基于Node.js的web聊天系统 - 真正意义上的web实时聊天系统
简单介绍一下这个实时web聊天系统的功能,首先进入系统的人填入名字和邮件地址后会获取到一个由系统创建的URL地址,你可以把这个地址发给另外一个人,另外一个人进入系统后就可以和你进行实时的聊天对话咯.主 ...
- Java基础(五) final关键字浅析
前面在讲解String时提到了final关键字,本文将对final关键字进行解析. static和final是两个我们必须掌握的关键字.不同于其他关键字,他们都有多种用法,而且在一定环境下使用,可以提 ...
- DHCP服务部署流程
为某一局域网部署DHCP [root@dhcp ~]# yum install -y dhcp[root@dhcp ~]# rpm -ql dhcp/usr/sbin/dhcpd:dhcp服务进程 / ...
- 【maven 】jar包冲突-记一次冲突解决
方法一:根据mvn提示一个一个排除 1.请到pom.xml文件所在的目录(包含父子目录)下分别执行下面的命令排查是什么原因导致fastjson版本不正确: mvn dependency:tree -D ...