
1、Spark 2.1 源码编译支持CDH
一、准备工作
1、安装Java, 配置环境变量, 版本为JDK1.7或者以上
export JAVA_HOME=/usr/java/default

export JRE_HOME=/usr/java/default/jre

export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib:$CLASSPATH

export PATH=$JAVA_HOME/bin:$PATH
2、安装Maven, 版本为3.3.9或者以上
export MAVEN_HOME=/usr/local/apache-maven-3.3.9

export PATH=$MAVEN_HOME/bin:$PATH
二、编译Spark的源码包
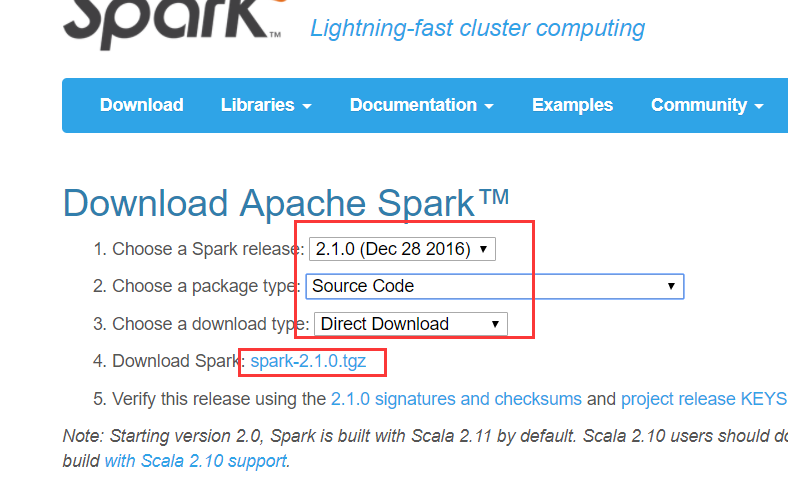
1、下载spark 2.1.0的源码包
2、增加cdh的repository
    <repository>

        <id>cloudera</id>

        <url>https://repository.cloudera.com/artifactory/cloudera-repos/</url>

    </repository>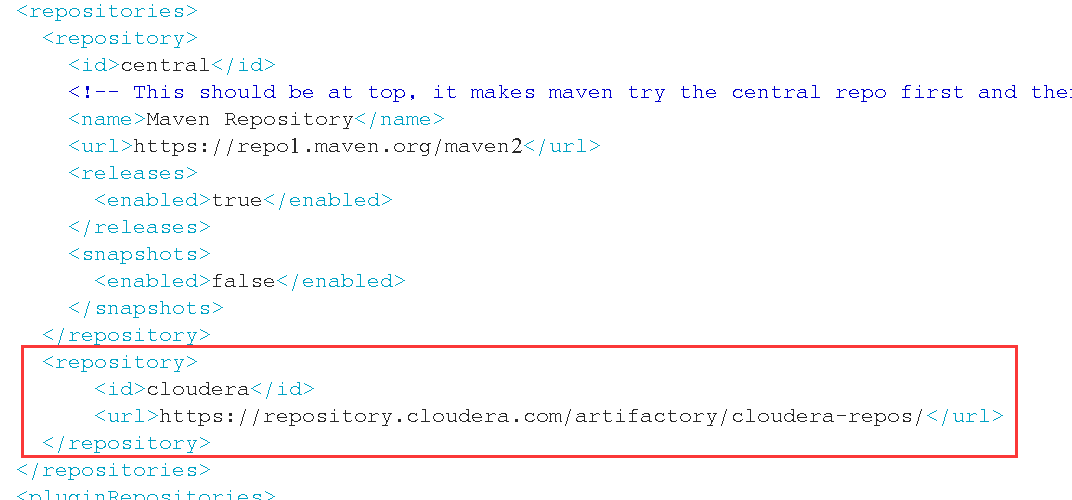
3、开始编译
./dev/make-distribution.sh --name 2.6.0-cdh5.7.0 --tgz -Pyarn -Phadoop-2.6 -Phive -Phive-thriftserver -Dhadoop.version=2.6.0-cdh5.7.0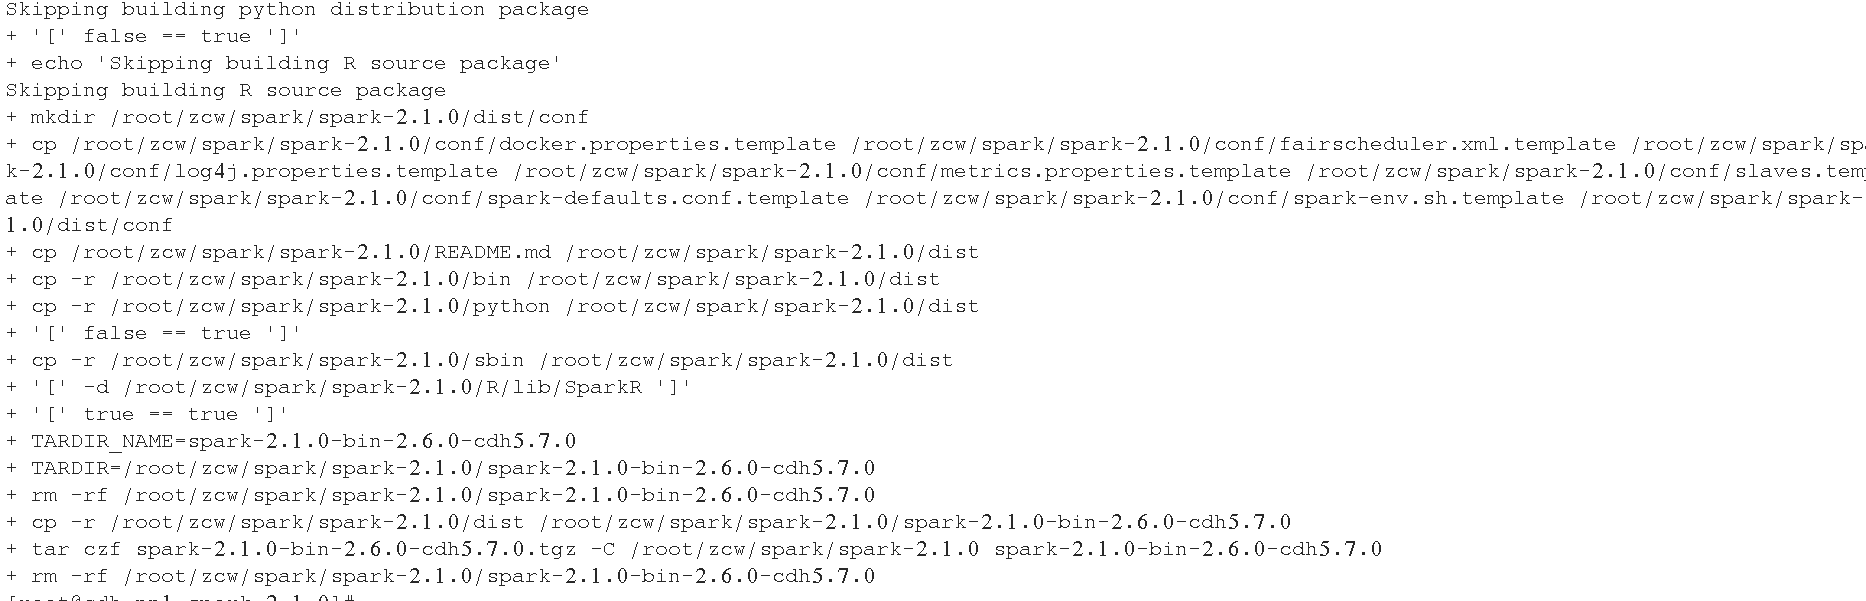
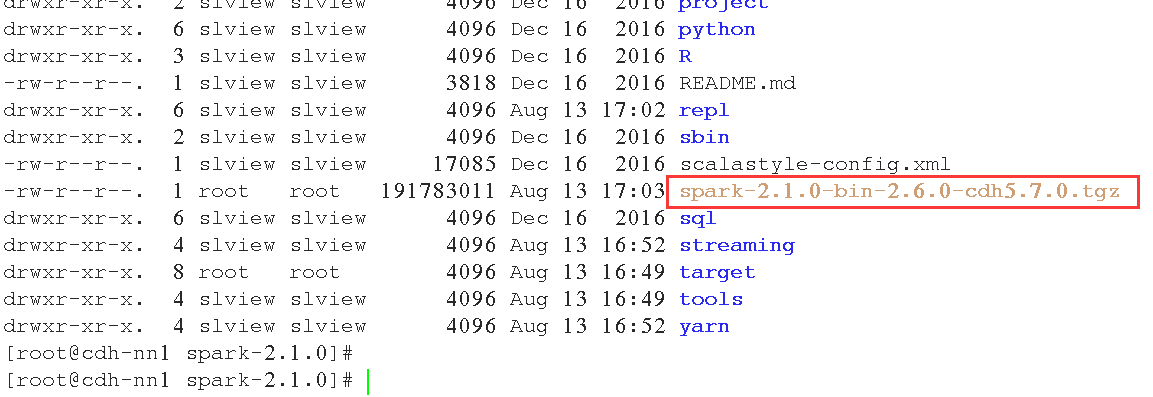
三、测试
1、提交到yarn上面
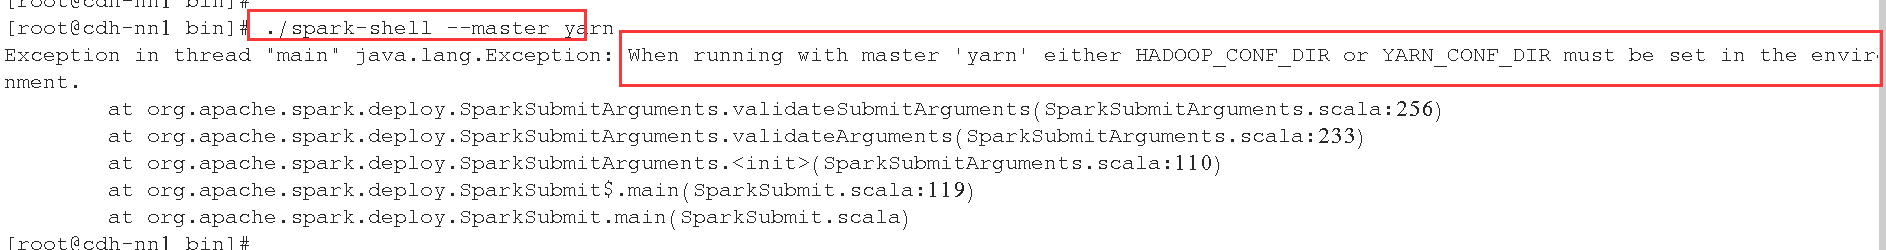
# export HADOOP_CONF_DIR=/etc/hadoop/conf
val file=spark.sparkContext.textFile("/tmp/appveyor.yml")

val wc = file.flatMap(line => line.split(",")).map(word=>(word,1)).reduceByKey(_ + _)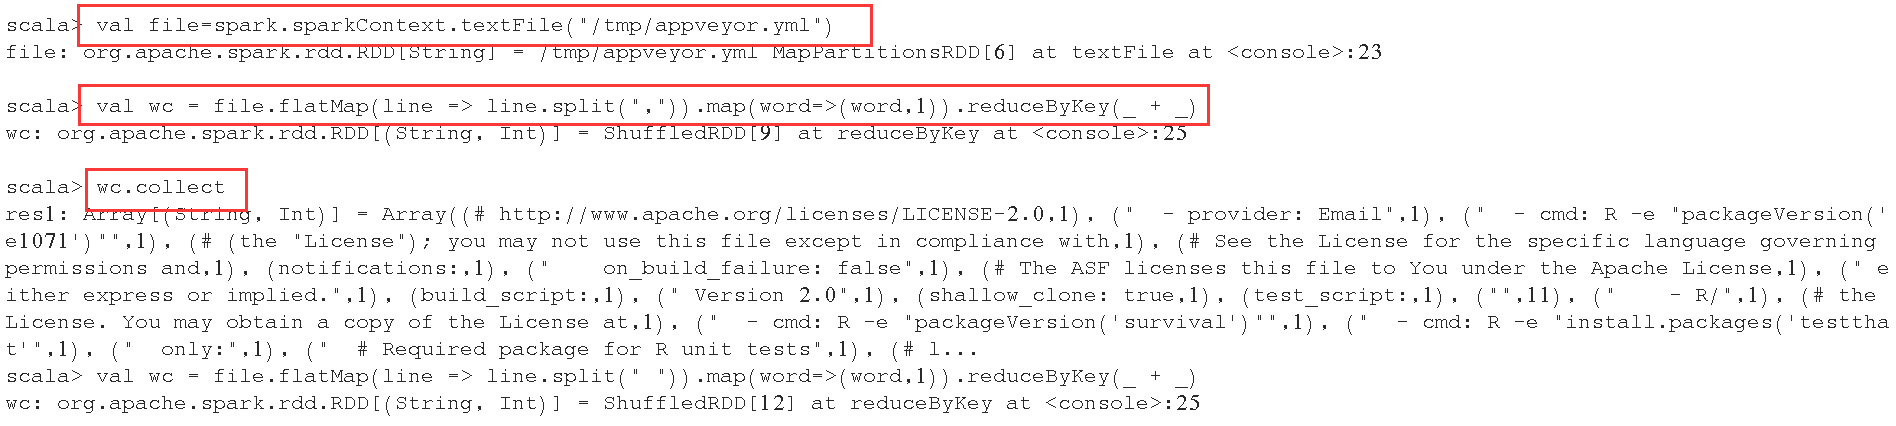
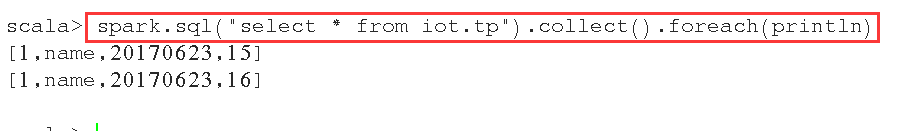
2、访问hive的表
1、Spark 2.1 源码编译支持CDH的更多相关文章
- dhcp源码编译支持4G上网卡
1. tar xvzf dhcp-4.2.5-P1.tar.gz 2. ./configure --host=arm-linux ac_cv_file__dev_random=yes 3. vi bi ...
- Spark环境搭建(六)-----------sprk源码编译
想要搭建自己的Hadoop和spark集群,尤其是在生产环境中,下载官网提供的安装包远远不够的,必须要自己源码编译spark才行. 环境准备: 1,Maven环境搭建,版本Apache Maven 3 ...
- 基于cdh5.10.x hadoop版本的apache源码编译安装spark
参考文档:http://spark.apache.org/docs/1.6.0/building-spark.html spark安装需要选择源码编译方式进行安装部署,cdh5.10.0提供默认的二进 ...
- Spark记录-源码编译spark2.2.0(结合Hive on Spark/Hive on MR2/Spark on Yarn)
#spark2.2.0源码编译 #组件:mvn-3.3.9 jdk-1.8 #wget http://mirror.bit.edu.cn/apache/spark/spark-2.2.0/spark- ...
- Spark 2.1.1 源码编译
Spark 2.1.1 源码编译 标签(空格分隔): Spark Spark 源码编译 环境准备与起因 由于线上Spark On Yarn Spark Streaming程序在消费kafka 写入HD ...
- Apache Spark源码走读之9 -- Spark源码编译
欢迎转载,转载请注明出处,徽沪一郎. 概要 本来源码编译没有什么可说的,对于java项目来说,只要会点maven或ant的简单命令,依葫芦画瓢,一下子就ok了.但到了Spark上面,事情似乎不这么简单 ...
- Spark源码编译
原创文章,转载请注明: 转载自http://www.cnblogs.com/tovin/p/3822995.html spark源码编译步骤如下: cd /home/hdpusr/workspace ...
- spark源码编译记录
spark在项目中已经用了一段时间了,趁现在空闲,下个源码编译在IDEA里面阅读下,特此记录过程. 前提已经安装maven和git 1.上官网下载源码的包: 2.然后解压到一个文件夹 3.编译,编译的 ...
- centos7.6环境zabbix3.2源码编译安装版升级到zabbix4.0长期支持版
zabbix3.2源码编译安装版升级到zabbix4.0长期支持版 项目需求: .2版本不再支持,想升级成4.0的长期支持版 环境介绍: zabbix服务端是编译安装的,数据库和web在一台机器上 整 ...
随机推荐
- springBoot配置elasticsearch搜索
1.本地安装elasticsearch服务,具体过程见上一篇文章(安装和配置elasticsearch服务集群) 2.修改项目中pom文件,引入搜索相关jar包 <!-- elasticsear ...
- 【转】python爬虫之腾讯视频vip下载
本文转自如下:作者:jia666666 原文:https://blog.csdn.net/jia666666/article/details/82466553 版权声明:本文为博主原创文章,转载请附上 ...
- Spring学习之旅(十五)--SpringBoot
在使用 Spring 的过程中,有时候会出现一些 ClassNotFoundException 异常,这是因为 JAR 依赖之间的版本不匹配所导致的.而 Spring Boot 就能避免绝大多数依赖版 ...
- nanopi NEO2 学习笔记 2:安装 pip 和 pip 安装第三方模块
我现在越来越喜欢用python做开发了,特别是知道了python还能用rpi.gpio库操作 NEO2 的 io 口之后,更是激动 在进行一下的操作之前,要先更换国内的 apt arm64 源,并更新 ...
- 我常用的一些linux命令
之前做过两年的运维,用过很多命令,深切体会到某些linux命令熟练掌握后对效率提升有多大.举个简单的例子,在做了研发后经常会有跑一些数据,对于结果数据的处理,我们的产品同学一般都习惯于用excel做统 ...
- Synchronized机制下偏向锁、轻量级锁、重量级锁的适用场景
上次总结了Synchronized机制下的锁的种类和原理,这次总结一下几种锁的适用场景. 偏向锁 一个线程获取某个对象的偏向锁的成本是很低的,只需把对象头的偏向线程id改为自己就好,如果偏向线程id已 ...
- .NET Core 学习资料精选:进阶
.NET 3.0 这个月就要正式发布了,对于前一篇博文<.NET Core 学习资料精选:入门>大家学的可还开心?这是本系列的第二篇文章:进阶篇,喜欢的园友速度学起来啊. 对于还在使用传统 ...
- Java NIO 上
概述: NIO主要有三大核心部分:Channel(通道),Buffer(缓冲区), Selector. 传统IO基于字节流和字符流进行操作,而NIO基于Channel和Buffer(缓冲区)进行操作, ...
- 检查python标识符是否有效
- Rikka with Prefix Sum(组合数学)
Rikka with Prefix Sum 题目描述 Prefix Sum is a useful trick in data structure problems. For example, giv ...