
【转】python爬虫之腾讯视频vip下载
本文转自如下:
作者:jia666666
原文:https://blog.csdn.net/jia666666/article/details/82466553
版权声明:本文为博主原创文章,转载请附上博文链接!
---------------------
运行环境
IDE:pycharm
python:3.6.5
实现目的
实现对腾讯视频目标url的解析与下载,由于第三方vip解析,只提供在线观看,隐藏想实现对目标视频的下载
实现思路
首先拿到想要看的腾讯电影url,通过第三方vip视频解析网站进行解析,通过抓包,模拟浏览器发送正常请求,通过拿到缓存ts文件,下载视频ts文件,最后通过转换为mp4文件,即可实现正常播放
源码
import re
import os,shutil
import requests,threading
from urllib.request import urlretrieve
from pyquery import PyQuery as pq
from multiprocessing import Pool
class video_down():
def __init__(self,url):
# 拼接全民解析url
self.api='https://jx.618g.com'
self.get_url = 'https://jx.618g.com/?url=' + url
#设置UA模拟浏览器访问
self.head = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36'}
#设置多线程数量
self.thread_num=32
#当前已经下载的文件数目
self.i = 0
# 调用网页获取
html = self.get_page(self.get_url)
if html:
# 解析网页
self.parse_page(html)
def get_page(self,get_url):
try:
print('正在请求目标网页....',get_url)
response=requests.get(get_url,headers=self.head)
if response.status_code==200:
#print(response.text)
print('请求目标网页完成....\n 准备解析....')
self.head['referer'] = get_url
return response.text
except Exception:
print('请求目标网页失败,请检查错误重试')
return None
def parse_page(self,html):
print('目标信息正在解析........')
doc=pq(html)
self.title=doc('head title').text()
print(self.title)
url = doc('#player').attr('src')[14:]
html=self.get_m3u8_1(url).strip()
#self.url = url + '800k/hls/index.m3u8'
self.url = url[:-10] +html
print(self.url)
print('解析完成,获取缓存ts文件.........')
self.get_m3u8_2(self.url)
def get_m3u8_1(self,url):
try:
response=requests.get(url,headers=self.head)
html=response.text
print('获取ts文件成功,准备提取信息')
return html[-20:]
except Exception:
print('缓存文件请求错误1,请检查错误')
def get_m3u8_2(self,url):
try:
response=requests.get(url,headers=self.head)
html=response.text
print('获取ts文件成功,准备提取信息')
self.parse_ts_2(html)
except Exception:
print('缓存文件请求错误2,请检查错误')
def parse_ts_2(self,html):
pattern=re.compile('.*?(.*?).ts')
self.ts_lists=re.findall(pattern,html)
print('信息提取完成......\n准备下载...')
self.pool()
def pool(self):
print('经计算需要下载%d个文件' % len(self.ts_lists))
self.ts_url = self.url[:-10]
if self.title not in os.listdir():
os.makedirs(self.title)
print('正在下载...所需时间较长,请耐心等待..')
#开启多进程下载
pool=Pool(16)
pool.map(self.save_ts,[ts_list for ts_list in self.ts_lists])
pool.close()
pool.join()
print('下载完成')
self.ts_to_mp4()
def ts_to_mp4(self):
print('ts文件正在进行转录mp4......')
str='copy /b '+self.title+'\*.ts '+self.title+'.mp4'
os.system(str)
filename=self.title+'.mp4'
if os.path.isfile(filename):
print('转换完成,祝你观影愉快')
shutil.rmtree(self.title)
def save_ts(self,ts_list):
try:
ts_urls = self.ts_url + '{}.ts'.format(ts_list)
self.i += 1
print('当前进度%d/%d'%(self.i,len(self.ts_lists)))
urlretrieve(url=ts_urls, filename=self.title + '/{}.ts'.format(ts_list))
except Exception:
print('保存文件出现错误')
if __name__ == '__main__':
#电影目标url:狄仁杰之四大天王
url='https://v.qq.com/x/cover/r6ri9qkcu66dna8.html'
#电影碟中谍5:神秘国度
url1='https://v.qq.com/x/cover/5c58griiqftvq00.html'
#电视剧斗破苍穹
url2='https://v.qq.com/x/cover/lcpwn26degwm7t3/z0027injhcq.html'
url3='https://v.qq.com/x/cover/33bfp8mmgakf0gi.html'
video_down(url2)
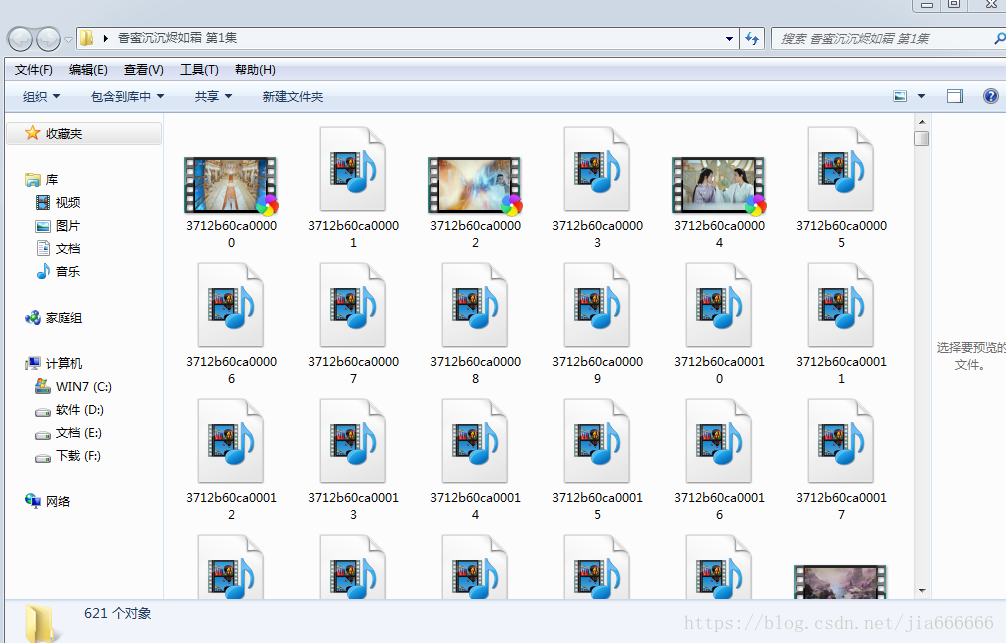
视频缓存ts文件
这里都是一些缓存视频文件,每个只有几秒钟播放,最后需要合并成一个mp4格式的视频,就可以正常播放,默认高清下载
注意这里的进度因为使用多进程下载,进度仅供参考,没有确切显示进度,可以进文件夹查看正常进度,可以理解为显示一次进度,下载一个ts文件
转换MP4
【转】python爬虫之腾讯视频vip下载的更多相关文章
- python 爬取腾讯视频的全部评论
一.网址分析 查阅了网上的大部分资料,大概都是通过抓包获取.但是抓包有点麻烦,尝试了F12,也可以获取到评论.以电视剧<在一起>为例子.评论最底端有个查看更多评论猜测过去应该是 Ajax ...
- Python 爬虫——抖音App视频抓包
APP抓包 前面我们了解了一些关于 Python 爬虫的知识,不过都是基于 PC 端浏览器网页中的内容进行爬取.现在手机 App 用的越来越多,而且很多也没有网页端,比如抖音就没有网页版,那么上面的视 ...
- Python爬虫-抖音小视频-mitmproxy与Appium
目的: 爬取抖音小视频 工具: mitmproxy.Appium 思路: 1. 通过 mitmproxy 截取请求, 找出 response 为 video 的请求. 2. 通过 mitmdu ...
- python爬虫(爬取视频)
爬虫爬视频 爬取步骤 第一步:获取视频所在的网页 第二步:F12中找到视频真正所在的链接 第三步:获取链接并转换成机械语言 第四部:保存 保存步骤代码 import re import request ...
- 1.记我的第一次python爬虫爬取网页视频
It is my first time to public some notes on this platform, and I just want to improve myself by reco ...
- Python爬虫爬取qq视频等动态网页全代码
环境:py3.4.4 32位 需要插件:selenium BeautifulSoup xlwt # coding = utf-8 from selenium import webdriverfrom ...
- Python简单网页爬虫——极客学院视频自动下载
http://blog.csdn.net/supercooly/article/details/51003921
- python 爬取腾讯视频评论
import urllib.request import re import urllib.error headers=('user-agent','Mozilla/5.0 (Windows NT 1 ...
- python爬虫--爬取某网站电影下载地址
前言:因为自己还是python世界的一名小学生,还有很多路要走,所以本文以目的为向导,达到目的即可,对于那些我自己都没弄懂的原理,不做去做过多解释,以免误人子弟,大家可以网上搜索. 友情提示:本代码用 ...
随机推荐
- [02] HEVD 内核漏洞之栈溢出
作者:huity出处:http://www.cnblogs.com/huity35/版权:本文版权归作者所有.文章在看雪.博客园.个人博客同时发布.转载:欢迎转载,但未经作者同意,必须保留此段声明:必 ...
- C#中Thread.IsBackground 属性
Thread thread.IsBackground =true; //Gets or sets a value indicating whether or not a thread is a ba ...
- Linux C 网络编程——多线程的聊天室实现(服务器端)
服务器端的主要功能: 实现多用户群体聊天功能(此程序最多设定为10人,可进行更改),每个人所发送的消息其他用户均可以收到.用户可以随意的加入或退出(推出以字符串"bye"实现),服 ...
- 使用redis分布式锁解决并发线程资源共享问题
众所周知, 在多线程中,因为共享全局变量,会导致资源修改结果不一致,所以需要加锁来解决这个问题,保证同一时间只有一个线程对资源进行操作 但是在分布式架构中,我们的服务可能会有n个实例,但线程锁只对同一 ...
- 终极版Servlet——我只能提示您路过别错过
终极版Servlet 前言:这两天看了SSM框架,本来是想往后继续学的,脑门一转又回来了,不能就这么不声不响的走了,看了这么多天的Servlet,再写最后一篇做个告别吧,这篇起名为终极版,是我现在所能 ...
- sass的核心知识及使用
sass的官方链接地址:htpp://sass-lang.com 参考链接地址:http://www.haorooms.com/post/sass_css 1. 基础语法 1.1 变量 SASS允许使 ...
- 彻底搞懂Python切片操作
在利用Python解决各种实际问题的过程中,经常会遇到从某个对象中抽取部分值的情况,切片操作正是专门用于完成这一操作的有力武器.理论上而言,只要条件表达式得当,可以通过单次或多次切片操作实现任 ...
- [解决方案]IIS配置后报错404,500,502等系列问题
很多时候刚部署完服务器的IIS以后,第一次部署站点都会出现形形色色,各种各样的报错问题,但这些问题大同小异,我这里就给大家提供的解决的方案,以达到以不变应万变的效果 目的:让大家学会处理类似问题的方法 ...
- GridLayout and GridData
GridLayout的风格 GridLayout类提供了GridLayout 布局中划分网格的信息,主要通过以下几个参数进行设置. 属性: NumColumns:通过“gridLayout.numCo ...
- 理解分布式一致性与Raft算法
理解分布式一致性与Raft算法 永远绕不开的CAP定理 出于可用性及负载方面考虑,一个分布式系统中数据必然不会只存在于一台机器,一致性简单地说就是分布式系统中的各个部分保持数据一致 但让数据保持一致往 ...