
Spark-1.0.1 的make-distribution.sh编译、SBT编译、Maven编译 三种编译方法
fesh个人实践,欢迎经验交流!本文Blog地址:http://www.cnblogs.com/fesh/p/3775343.html
本文编译方法所支持的hadoop环境是Hadoop-2.2.0,YARN是2.2.0,JAVA版本为1.8.0_11,操作系统Ubuntu14.04
cd spark-1.0.1

./make-distribution.sh --hadoop 2.2.0 --with-yarn --tgz
--tgz: Additionally creates spark-$VERSION-bin.tar.gz
--hadoop VERSION: Builds against specified version of Hadoop.
--with-yarn: Enables support for Hadoop YARN.
--with-hive: Enable support for reading Hive tables.
--name: A moniker for the release target. Defaults to the Hadoop verison.
如果一切顺利,会在$SPARK_HOME/assembly/target/scala-2.10目录下生成目标文件
(好像Java版本1.8在这里有版本问题?默认在1.6环境下,但我居然编译成功了,呵呵)
(注:之前加了--with-tachyon 我总是编译成功,但生成tgz部署包失败,不知道为什么。今天我在JDK1.7.0_51环境(应该与JDK版本无关)下,去掉了--with-tachyon ,编译成功,并且生成了spark-1.0.1-
bin-2.2.0.tgz部署包)
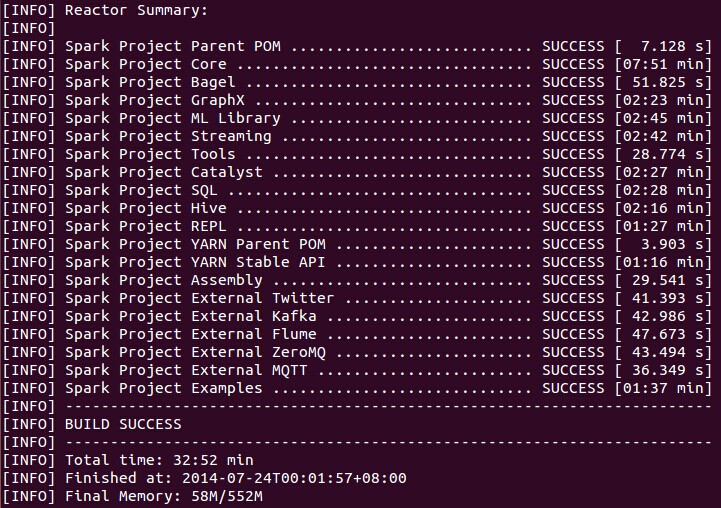
编译结果:
tar -zxvf spark-1.0.0.tar.gz
cd spark-1.0.1

SPARK_HADOOP_VERSION=2.2.0 SPARK_YARN=true ./sbt/sbt assembly
export MAVEN_OPTS="-Xmx2g -XX:MaxPermSize=512M -XX:ReservedCodeCacheSize=512m"
[INFO] Compiling  Scala sources and  Java sources to /Users/me/Development/spark/core/target/scala-2.10/classes...

[ERROR] PermGen space -> [Help ]

[INFO] Compiling  Scala sources and  Java sources to /Users/me/Development/spark/core/target/scala-2.10/classes...

[ERROR] Java heap space -> [Help ]
2)指定Hadoop版本并编译
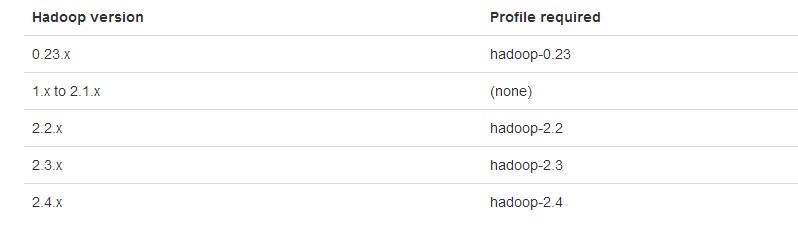
# Apache Hadoop 2.2.X
mvn -Pyarn -Phadoop-2.2 -Dhadoop.version=2.2.0 -DskipTests clean package
如果是其他版本的YARN和HDFS,则按下面编译:
# Different versions of HDFS and YARN.
mvn -Pyarn-alpha -Phadoop-2.3 -Dhadoop.version=2.3. -Dyarn.version=0.23. -DskipTests clean package
)
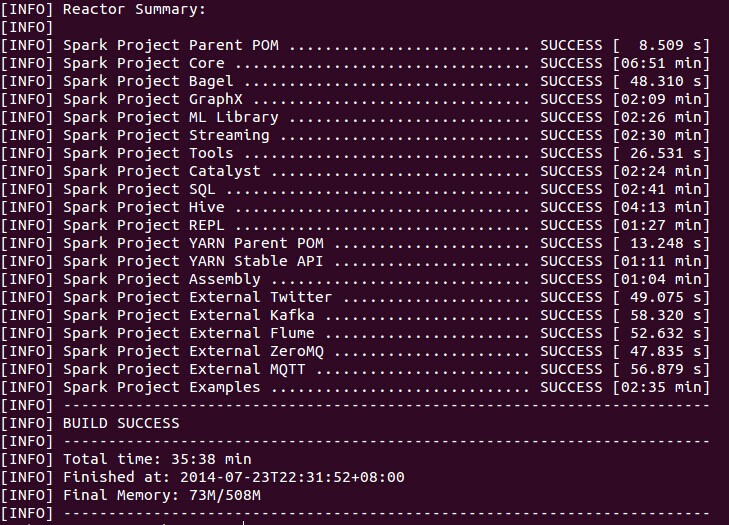
编译结果为:
另外,这篇文章的编译讲得也很详细,也可以参考:http://mmicky.blog.163.com/blog/static/1502901542014312101657612/
以及文章 http://www.cnblogs.com/hseagle/p/3732492.html
Spark源码和编译后的源码、部署包我分享在: http://pan.baidu.com/s/1c0y7JKs 提取密码: ccvy
Spark-1.0.1 的make-distribution.sh编译、SBT编译、Maven编译 三种编译方法的更多相关文章
- spark提交任务的三种的方法
在学习Spark过程中,资料中介绍的提交Spark Job的方式主要有三种: 第一种: 通过命令行的方式提交Job,使用spark 自带的spark-submit工具提交,官网和大多数参考资料都是已这 ...
- Spark 1.0.0 横空出世 Spark on Yarn 部署(Hadoop 2.4)
就在昨天,北京时间5月30日20点多.Spark 1.0.0最终公布了:Spark 1.0.0 released 依据官网描写叙述,Spark 1.0.0支持SQL编写:Spark SQL Progr ...
- spark 2.0.0集群安装与hive on spark配置
1. 环境准备: JDK1.8 hive 2.3.4 hadoop 2.7.3 hbase 1.3.3 scala 2.11.12 mysql5.7 2. 下载spark2.0.0 cd /home/ ...
- [b0006] Spark 2.0.1 伪分布式搭建练手
环境: 已经安装好: hadoop 2.6.4 yarn 参考: [b0001] 伪分布式 hadoop 2.6.4 准备: spark-2.0.1-bin-hadoop2.6.tgz 下载地址: ...
- hive on spark (spark2.0.0 hive2.3.3)
hive on spark真的很折腾人啊!!!!!!! 一.软件准备阶段 maven3.3.9 spark2.0.0 hive2.3.3 hadoop2.7.6 二.下载源码spark2.0.0,编译 ...
- Spark 2.0
Apache Spark 2.0: Faster, Easier, and Smarter http://blog.madhukaraphatak.com/categories/spark-two/ ...
- Spark 1.0 开发环境构建:maven/sbt/idea
因为我原来对maven和sbt都不熟悉,因此使用两种方法都编译了一下.下面记录一下编译时候遇到的问题.然后介绍一下如果使用IntelliJ IDEA 13.1构建开发环境. 首先准备java环境和sc ...
- APACHE SPARK 2.0 API IMPROVEMENTS: RDD, DATAFRAME, DATASET AND SQL
What’s New, What’s Changed and How to get Started. Are you ready for Apache Spark 2.0? If you are ju ...
- Apache Spark 3.0 将内置支持 GPU 调度
如今大数据和机器学习已经有了很大的结合,在机器学习里面,因为计算迭代的时间可能会很长,开发人员一般会选择使用 GPU.FPGA 或 TPU 来加速计算.在 Apache Hadoop 3.1 版本里面 ...
随机推荐
- Smarty 分页
1 <div id="pagelist" class="clearfix">2 <a href="/canadian-sai ...
- svn使用(三)
使用VisualSVN服务端,把已有的文件导入到服务端中 可以按以下步骤:
- C语言中的 extern 关键字
今天在 BLE 中看到很多 extern 关键字,现在总结一下: extern 关键字主要用于在一个c文件中要用到另一个c文件中的变量或者函数. example: #extern_base.c ; # ...
- kafka2.9.2的伪分布式集群安装和demo(java api)测试
目录: 一.什么是kafka? 二.kafka的官方网站在哪里? 三.在哪里下载?需要哪些组件的支持? 四.如何安装? 五.FAQ 六.扩展阅读 一.什么是kafka? kafka是LinkedI ...
- MapReduce简介
MapReduce简介 参考自[http://www.cnblogs.com/swanspouse/p/5130136.html] MapReduce定义: MapReduce是一种可用于数据处理的编 ...
- Stencil Buffer
刚在草稿箱里发现了这篇充满特色的好日志.发表之. ------------------吃货的分割线---------------------------------------- Stencil Bu ...
- oracle 如何查询过去某个时间点的记录(应用于某个时间点的误操作,回滚到之前的操作)
这个功能是在自己误操作,将某些数据更改错了,你想恢复更改错之前的数据,这个时候你可以使用这种方式 不过建议要小心更改数据,如果实在有必要去更新,请先备份数据表,不到万不得以才可以这么做. SE ...
- lumen 登陆 注册 demo
本文将用Lumen来实现一个完整的用户注册.登录及获取用户信息的API. Lumen环境搭建和初始化详细步骤请参考上篇文章<Lumen安装配置使用入门>一文. 一.准备工作 1.Lumen ...
- 一、Spring——IoC
IOC概述 Spring中IOC的概念,控制反转概念其实包含两个层面的意思,"控制"是接口实现类的选择控制权:而"反转"是指这种选择控制权从调用者转移到外部第三 ...
- ios webview中关于宽高的总结
测试一 测试的物料: <html> <head> <meta charset="UTF-8"> <meta name="view ...