
Ubuntu定时执行任务(定时爬取数据)
cron是一个Linux下的后台进程,用来定期的执行一些任务。因为我用的是Ubuntu,所以这篇文章中的所有命令也只能保证在Ubuntu下有效。
1:编辑crontab文件,用来存放你要执行的命令
sudo crontab -e
2:第一次用这个命令,会让你选择文本编辑器,我选的是vim
(输入数字选择就是了!)
3:添加执行命令
0 7 * * * /usr/bin/python /root/world.py
这句话的意思就是每天早上七点都会自动执行这个脚本!
4:重启cron来应用这个计划任务
sudo service cron restart
0|1corntab详细说明
1:crontab文件的基本格式如下所示
* * * * * command

分 时 天 月 周 命令
crontab中的每一行代表一个定期执行的任务,分为6个部分。前5个部分表示何时执行命令,最后一个部分表示执行的命令。每个部分以空格分隔,除了最后一个部分(命令)可以在内部使用空格之外,其他部分都不能使用空格。前5个部分分别代表:分钟,小时,天,月,星期,每个部分的取值范围如下:
分钟 0 - 59
小时 0 - 23
天 1 - 31
月 1 - 12
星期 0 - 6 0表示星期天
* (星号) 表示任意值,比如在小时部分填写 * 代表任意小时(每小时)
,(逗号) 可以允许在一个部分中填写多个值,比如在分钟部分填写 1,3 表示一分钟或三分钟
/(斜线) 一般配合 * 使用,代表每隔多长时间,比如在小时部分填写 /2 代表每隔两分钟。所以 /1 和 * 没有区别
2:crontab例子
(1)30 20 * * * date >> /home/date.log //每天的20:30将日期信息追加home目录下的date.log中
(2)5 20 13,14 * * date >> /home/date.log //每月的13日,14日20:5分将日期信息最追加home目录下的date.log中
(3)0,10 10,12 * * * date >> /home/date.log //每天10点至12点之间,隔10分钟将日期信息最追加home目录下的date.log中
(4)/5 * * * date >> /home/date.log //每5分钟将日期信息最追加home目录下的date.log中
3:crontab是UNIX系统下定期执行任务的触发器。用户把要定期执行的任务记录在这个文件下面,然后crond定期的去检查这个定期执行列表,有要执行的工作时便自动执行。
通过man crontab可以查看到下面的信息
(1)/etc/crond.allow 表示的是允许使用crontab的用户列表
(2)/etc/crond.deny 表示的是不允许使用crontab的用户列表
4: crontab常用的几个命令格式
crontab -l //显示用户的crontab文件的内容
crontab -e //编辑用户的crontab文件的内容
crontab -r //删除用户的crontab文件
实例分析:
更换成unix的换行符
vim world.py
查看格式
:set ff
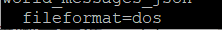
发现是dos,我们要将其更换成unix
:set ff=unix
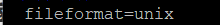
1 创建脚本文件world.py,在文件开头需要加上下面一行
#!/usr/bin/python
上面这行的作用是说明使用那个解释器来执行该文件,如果不知道python解释器在哪,可以使用命令which python来查看
设置编码格式
2 给该文件添加可执行的权限
chmod +x test.py
注意:在脚本文件中如果涉及文件操作,请使用绝对路径,我就是在这上面掉坑里了。
3 添加计划任务
crontab -e
在文件中追加一行,* 7 * * * * /usr/bin/python /root/world.py
保存退出,:wq
4 重启cron服务
service cron restart
结束
Ubuntu定时执行任务(定时爬取数据)的更多相关文章
- node.js爬取数据并定时发送HTML邮件
node.js是前端程序员不可不学的一个框架,我们可以通过它来爬取数据.发送邮件.存取数据等等.下面我们通过koa2框架简单的只有一个小爬虫并使用定时任务来发送小邮件! 首先我们先来看一下效果图 差不 ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 如何提升scrapy爬取数据的效率
在配置文件中修改相关参数: 增加并发 默认的scrapy开启的并发线程为32个,可以适当的进行增加,再配置文件中修改CONCURRENT_REQUESTS = 100值为100,并发设置成了为100. ...
- 借助Chrome和插件爬取数据
工具 Chrome浏览器 TamperMonkey ReRes Chrome浏览器 chrome浏览器是目前最受欢迎的浏览器,没有之一,它兼容大部分的w3c标准和ecma标准,对于前端工程师在开发过程 ...
- web scraper——简单的爬取数据【二】
web scraper——安装[一] 在上文中我们已经安装好了web scraper现在我们来进行简单的爬取,就来爬取百度的实时热点吧. http://top.baidu.com/buzz?b=1&a ...
- 关于js渲染网页时爬取数据的思路和全过程(附源码)
于js渲染网页时爬取数据的思路 首先可以先去用requests库访问url来测试一下能不能拿到数据,如果能拿到那么就是一个普通的网页,如果出现403类的错误代码可以在requests.get()方法里 ...
- 【Spider】使用CrawlSpider进行爬虫时,无法爬取数据,运行后很快结束,但没有报错
在学习<python爬虫开发与项目实践>的时候有一个关于CrawlSpider的例子,当我在运行时发现,没有爬取到任何数据,以下是我敲的源代码:import scrapyfrom UseS ...
- 【个人】爬虫实践,利用xpath方式爬取数据之爬取虾米音乐排行榜
实验网站:虾米音乐排行榜 网站地址:http://www.xiami.com/chart 难度系数:★☆☆☆☆ 依赖库:request.lxml的etree (安装lxml:pip install ...
- python模拟浏览器爬取数据
爬虫新手大坑:爬取数据的时候一定要设置header伪装成浏览器!!!! 在爬取某财经网站数据时由于没有设置Header信息,直接被封掉了ip 后来设置了Accept.Connection.User-A ...
- scrapy爬取数据的基本流程及url地址拼接
说明:初学者,整理后方便能及时完善,冗余之处请多提建议,感谢! 了解内容: Scrapy :抓取数据的爬虫框架 异步与非阻塞的区别 异步:指的是整个过程,中间如果是非阻塞的,那就是异步 ...
随机推荐
- java IO流 (六) 其它的流的使用
1. 标准的输入输出流:System.in:标准的输入流,默认从键盘输入System.out:标准的输出流,默认从控制台输出 修改默认的输入和输出行为:System类的setIn(InputStrea ...
- 机器学习实战基础(十七):sklearn中的数据预处理和特征工程(十)特征选择 之 Embedded嵌入法
Embedded嵌入法 嵌入法是一种让算法自己决定使用哪些特征的方法,即特征选择和算法训练同时进行.在使用嵌入法时,我们先使用某些机器学习的算法和模型进行训练,得到各个特征的权值系数,根据权值系数从大 ...
- Android 性能优化 ---- 启动优化
Android 性能优化 ---- 启动优化 1.为什么要进行启动优化 一款应用的第一印象很重要,第一印象往往决定了用户的去留.打开一款应用,如果速度很快,很顺畅,那么很容易让人觉得这款应用背后的技术 ...
- [C#]正则表达式的基本用法
C#正则表达式的基本用法 正则表达式(regular expression)描述了一种字符串匹配的模式(pattern),可以用来检查一个串是否含有某种子串.将匹配的子串替换或者从某个串中取出符合某个 ...
- educoder SML程序设计题线下编译环境搭建
背景 最近<串并行数据结构与算法设计>的老师在educoder上布置了一些SML程序设计题,虽然网站上有在线编译功能,但还是在线下编译调试方便,特记录编译环境过程如下(我用的GVIM,但N ...
- P1136 迎接仪式 题解
题目描述 LHX教主要来X市指导OI学习工作了.为了迎接教主,在一条道路旁,一群Orz教主er穿着文化衫站在道路两旁迎接教主,每件文化衫上都印着大字.一旁的Orzer依次摆出"欢迎欢迎欢迎欢 ...
- Python Hacking Tools - Web Scraper
Preparation: Python Libray in the following programming: 1. Requests Document: https://2.python-requ ...
- Vuex与axios的封装和调用
Vuex状态管理 状态就是数据. 在react里有个Flux的数据流管理(单向数据流) 作用1:实现组件之间的数据共享. 作用2:用于缓存.(避免当用户频繁点击,页面不断调接口) 先安装 ...
- ThinkPHP6 核心分析之Http 类跟Request类的实例化
以下源码分析,我们可以从 App,Http 类的实例化过程,了解类是如何实现自动实例化的,依赖注入是怎么实现的. 从入口文件出发 当访问一个 ThinkPHP 搭建的站点,框架最先是从入口文件开始的, ...
- Thymeleaf从入门到精通
什么是Thymeleaf 大家好,我是bigsai,今天我们来学习Thymeleaf,如果你对Thymeleaf比较陌生也不要紧,它很容易学习与理解,并有着自己鲜明的特色. 开始之前,我们依旧问一个问 ...