
web scraper——简单的爬取数据【二】
在上文中我们已经安装好了web scraper现在我们来进行简单的爬取,就来爬取百度的实时热点吧。
http://top.baidu.com/buzz?b=1&fr=20811
文本太长,大部分是图片,所以上下操作视频吧,视频爬取的是昵称不是百度热点数据
链接:https://pan.baidu.com/s/1W-8kGDznZZjoQIk1e6ikfQ
提取码:3dj7
爬取步骤
创建站点
打开百度热点,ctrl+shit+i进入检测工具,打开web scraper创建站点
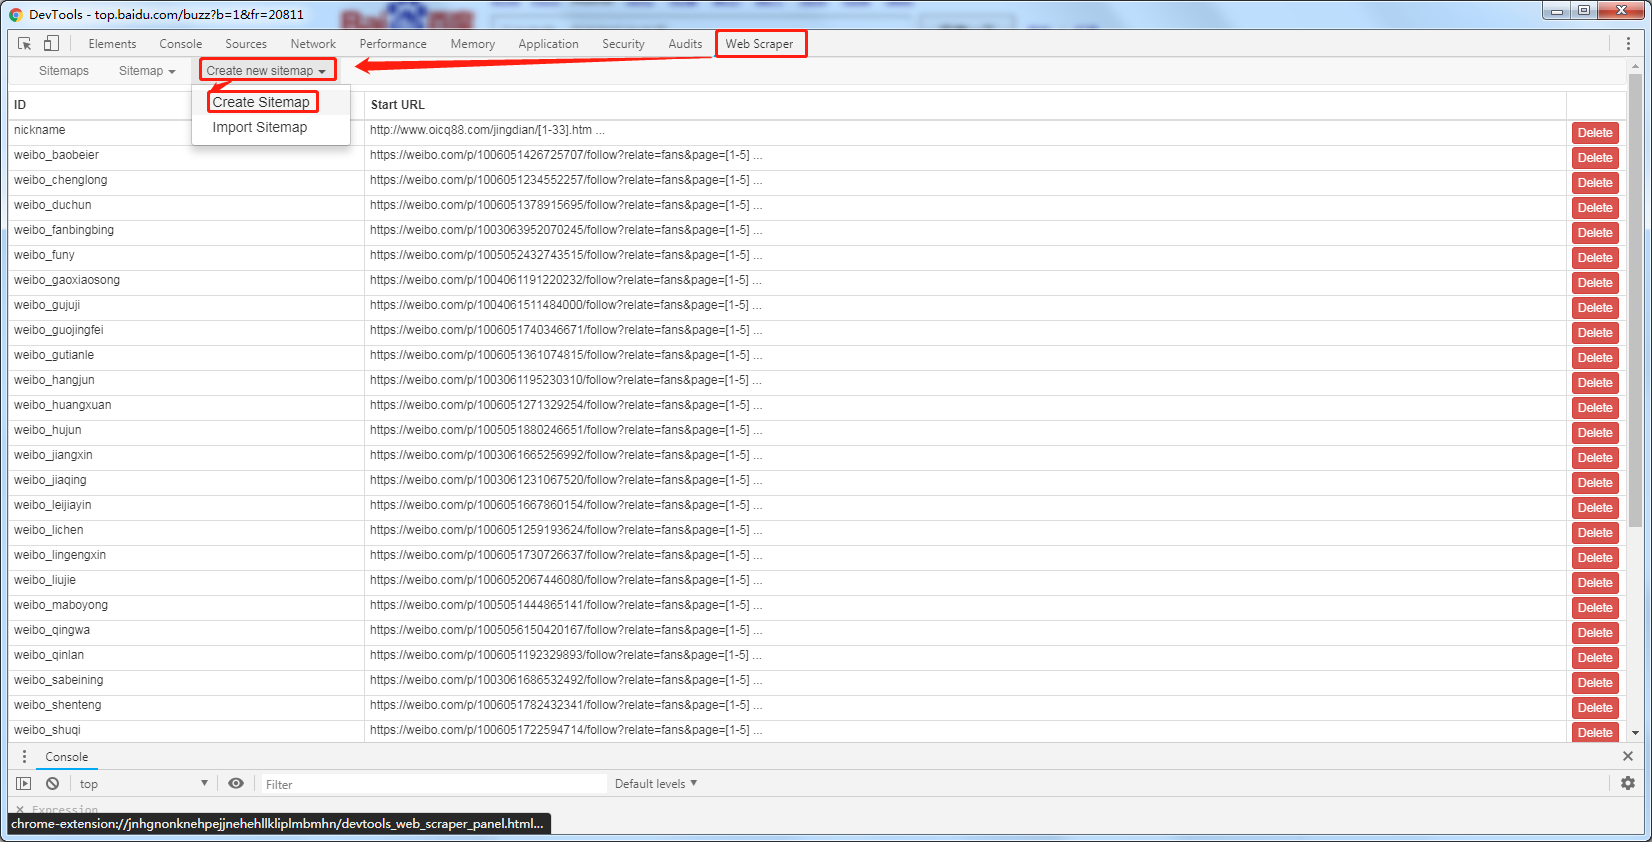
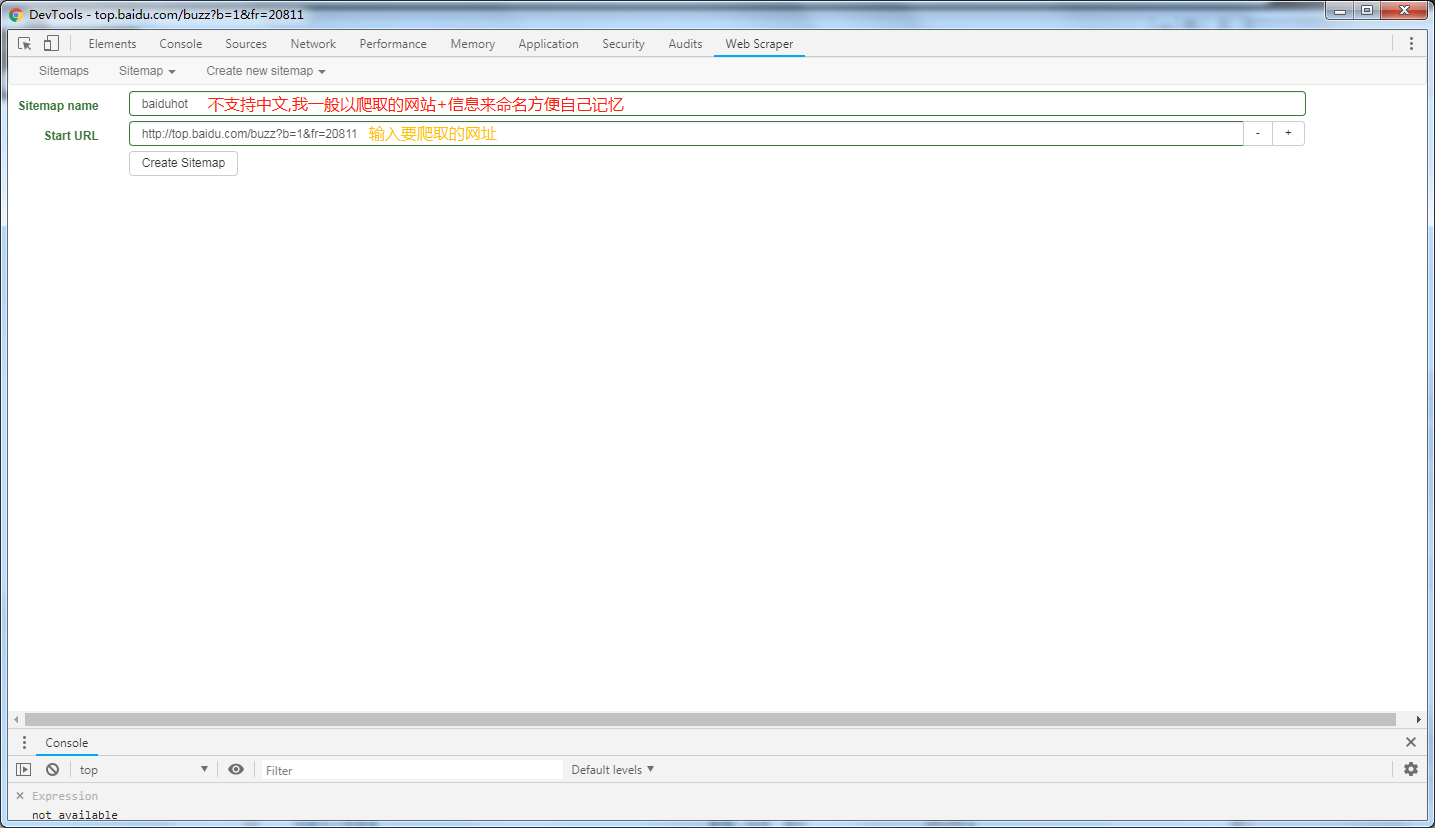
进入 创建站点页面 站点名称和爬取地址点击创建站点即可
如果要爬取分页数据那就将参数写成范围的如:
想要爬取微博某博主关注列表的1-5页的粉丝信息,通过url的跳转发现微博关注列表和<number>数字有关
https://weibo.com/p/1003061752021340/follow?relate=fans&page=<number>
所以只要把<number>写成一个范围的即可
https://weibo.com/p/1006051234552257/follow?relate=fans&page=[1-5]
爬取数据
首先创建一个element的select
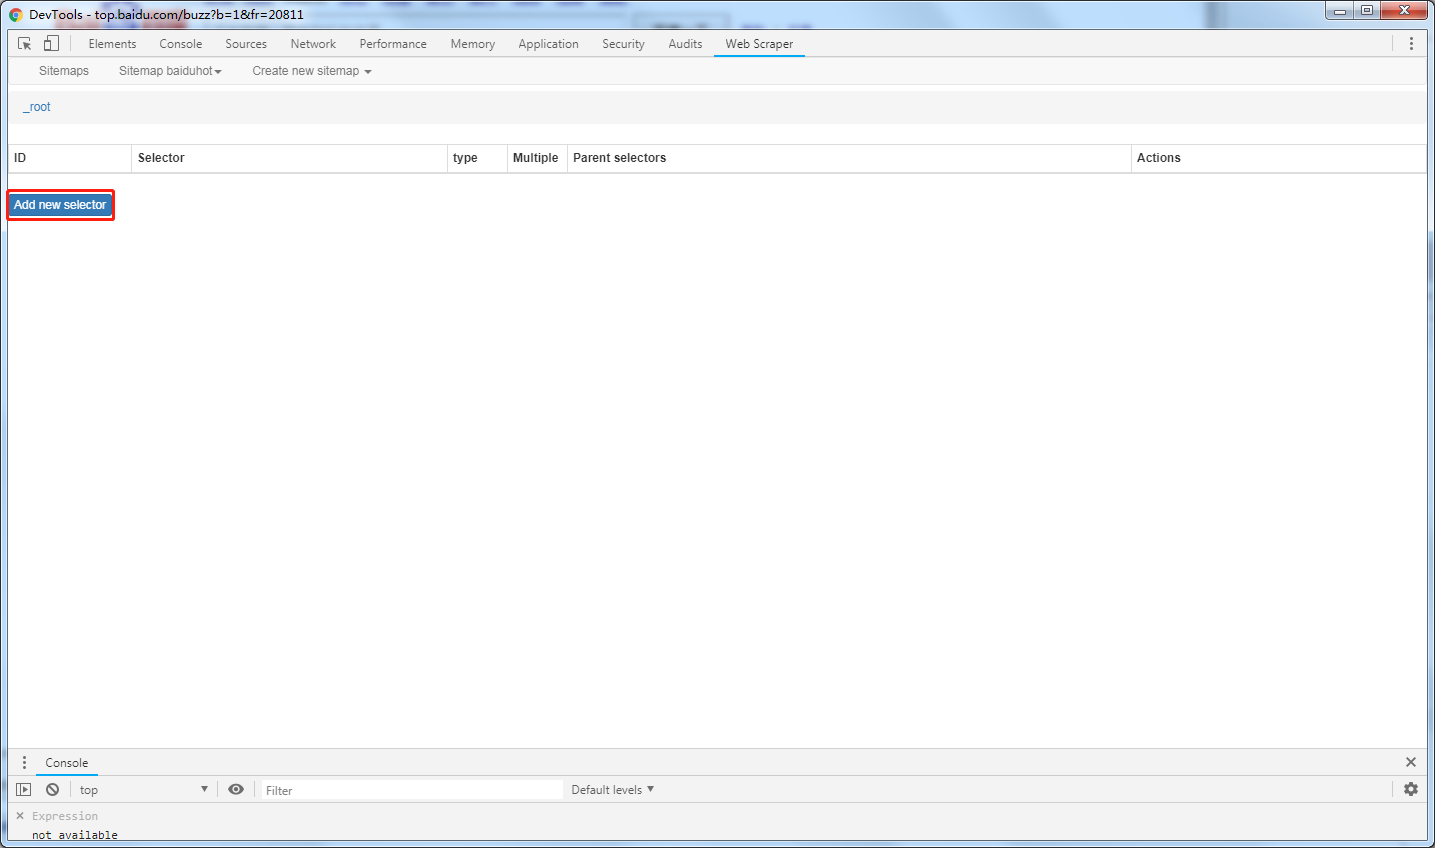
创建element信息
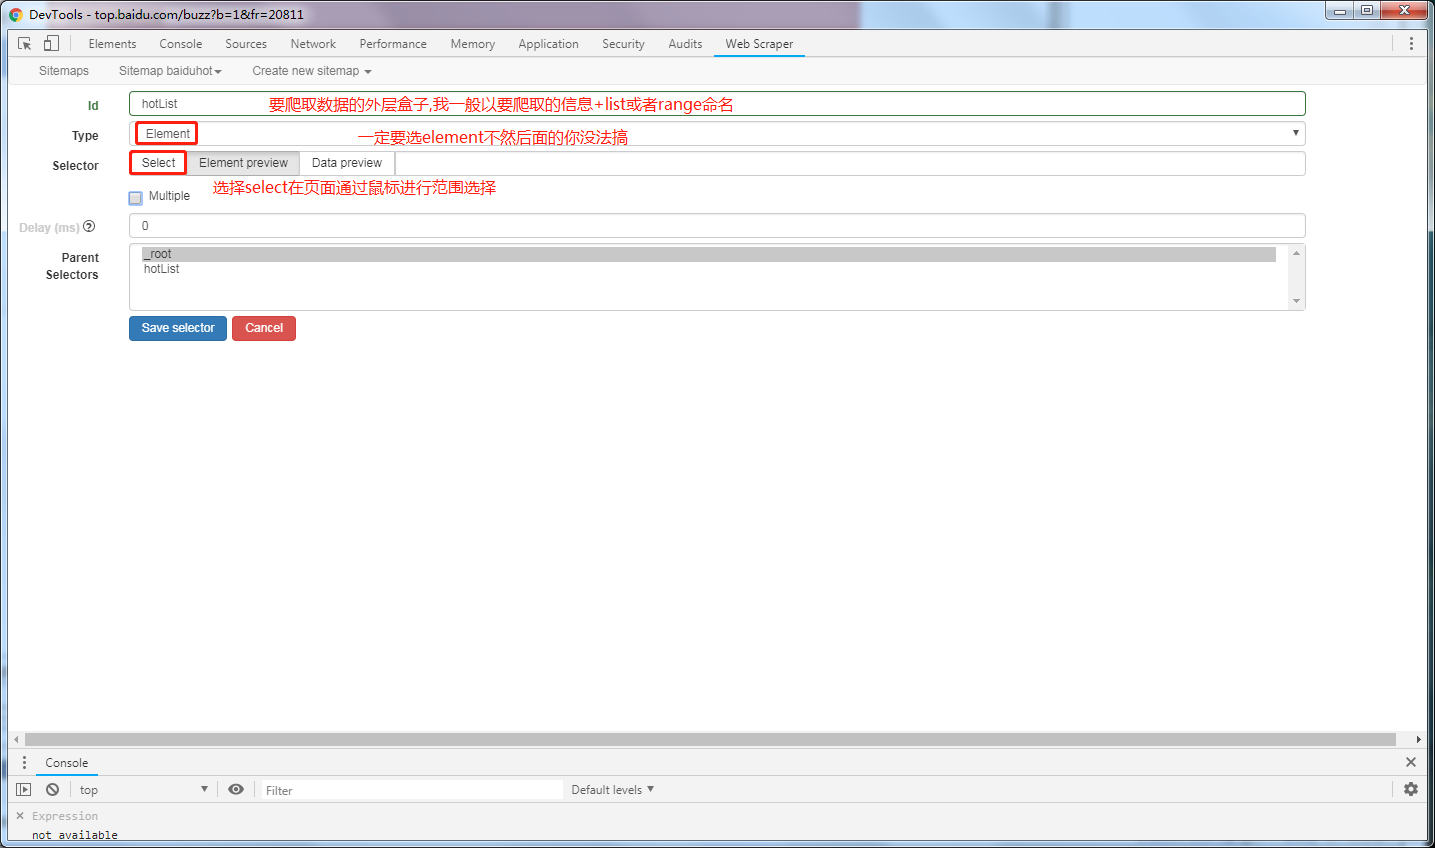
select选择最外层的盒子,确认无误后点击Done selecting!
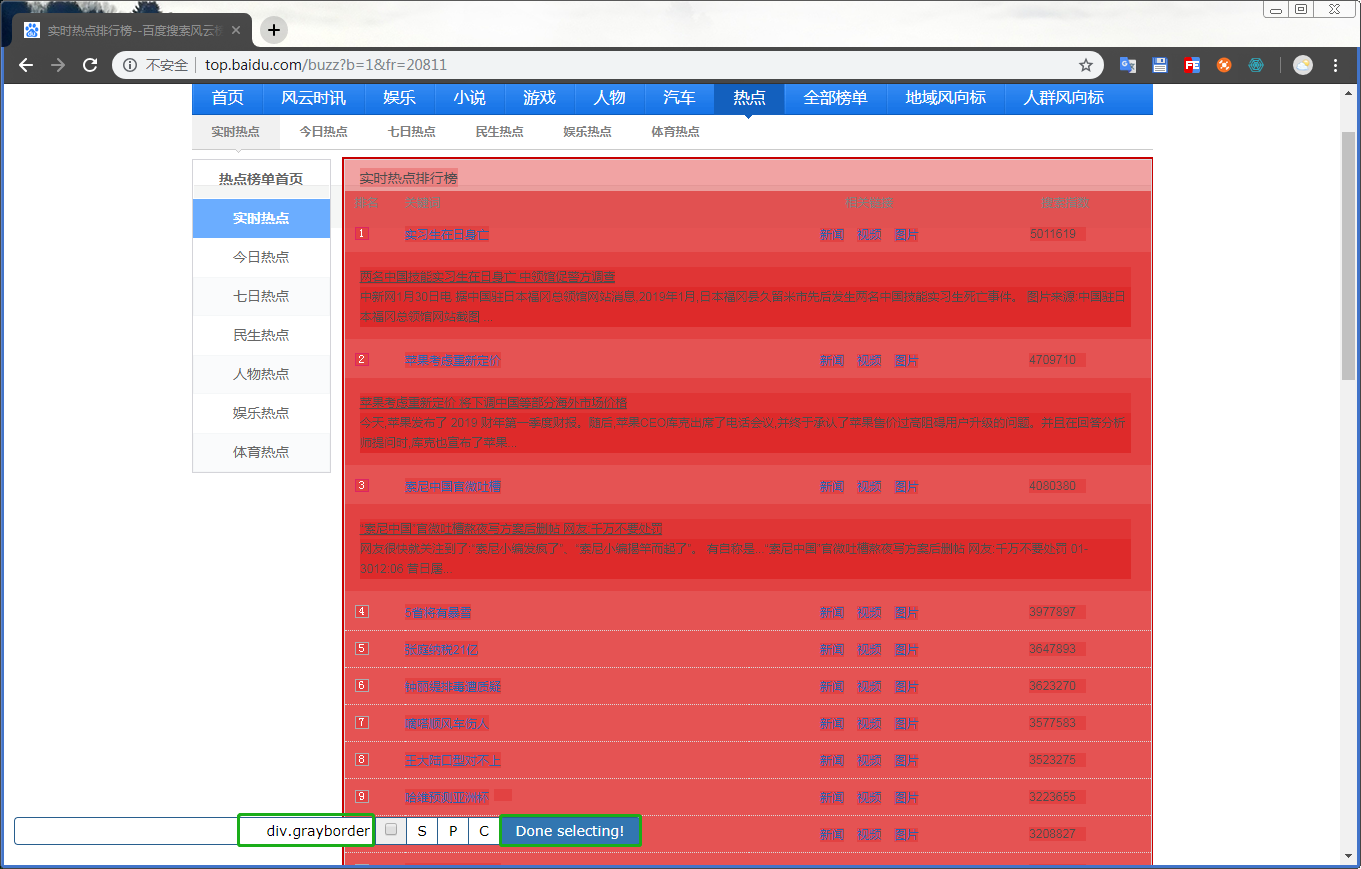
然后回到web scraper控制台,查看信息无误后勾选multiple确认无误后,创建element的select

爬取自己想要的信息,点击进入hotList里面,然后继续创建select选择
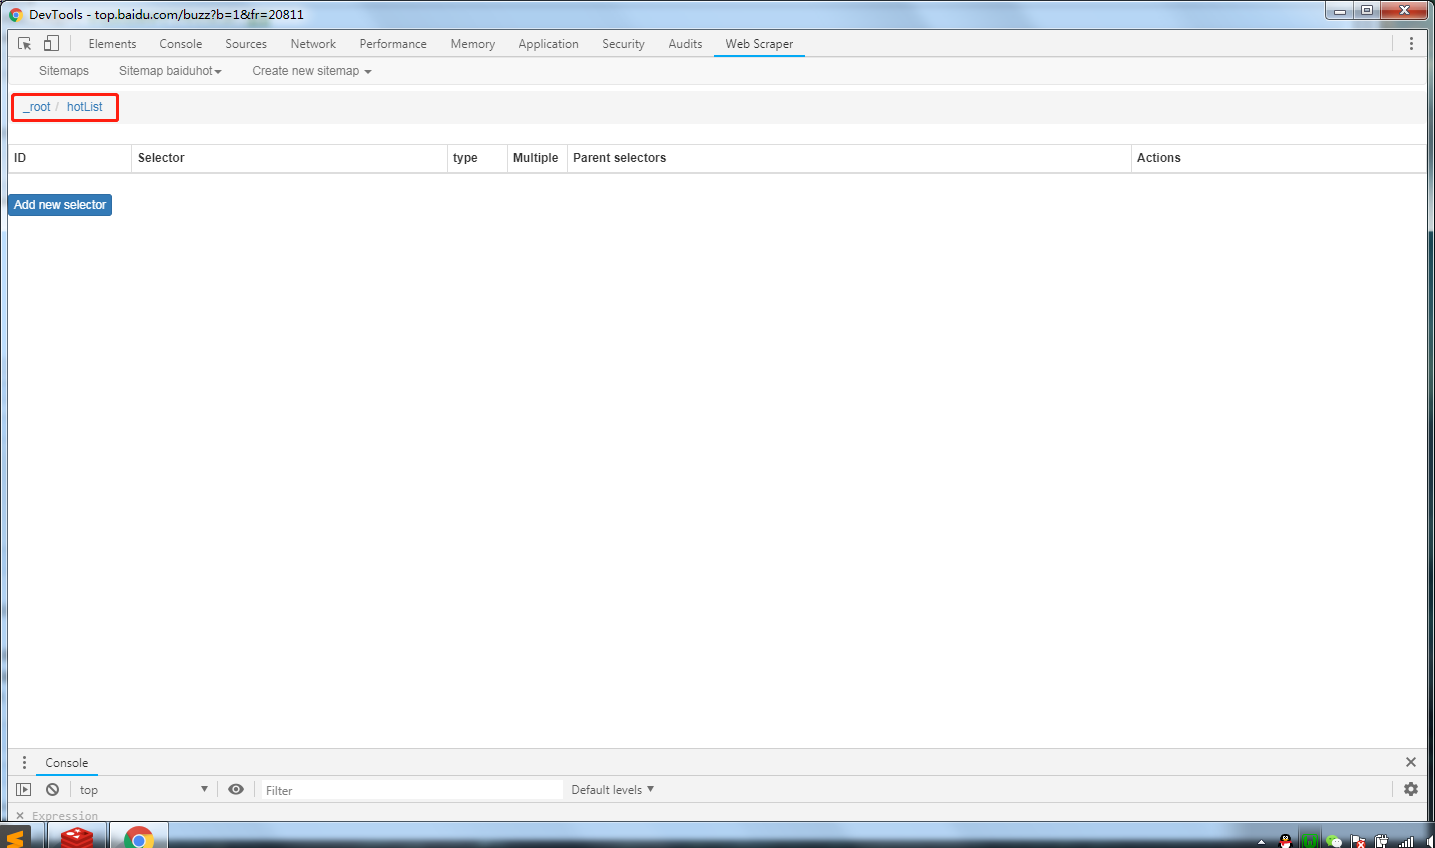
填写具体的select信息,并继续通过select来进行选择需要的数据
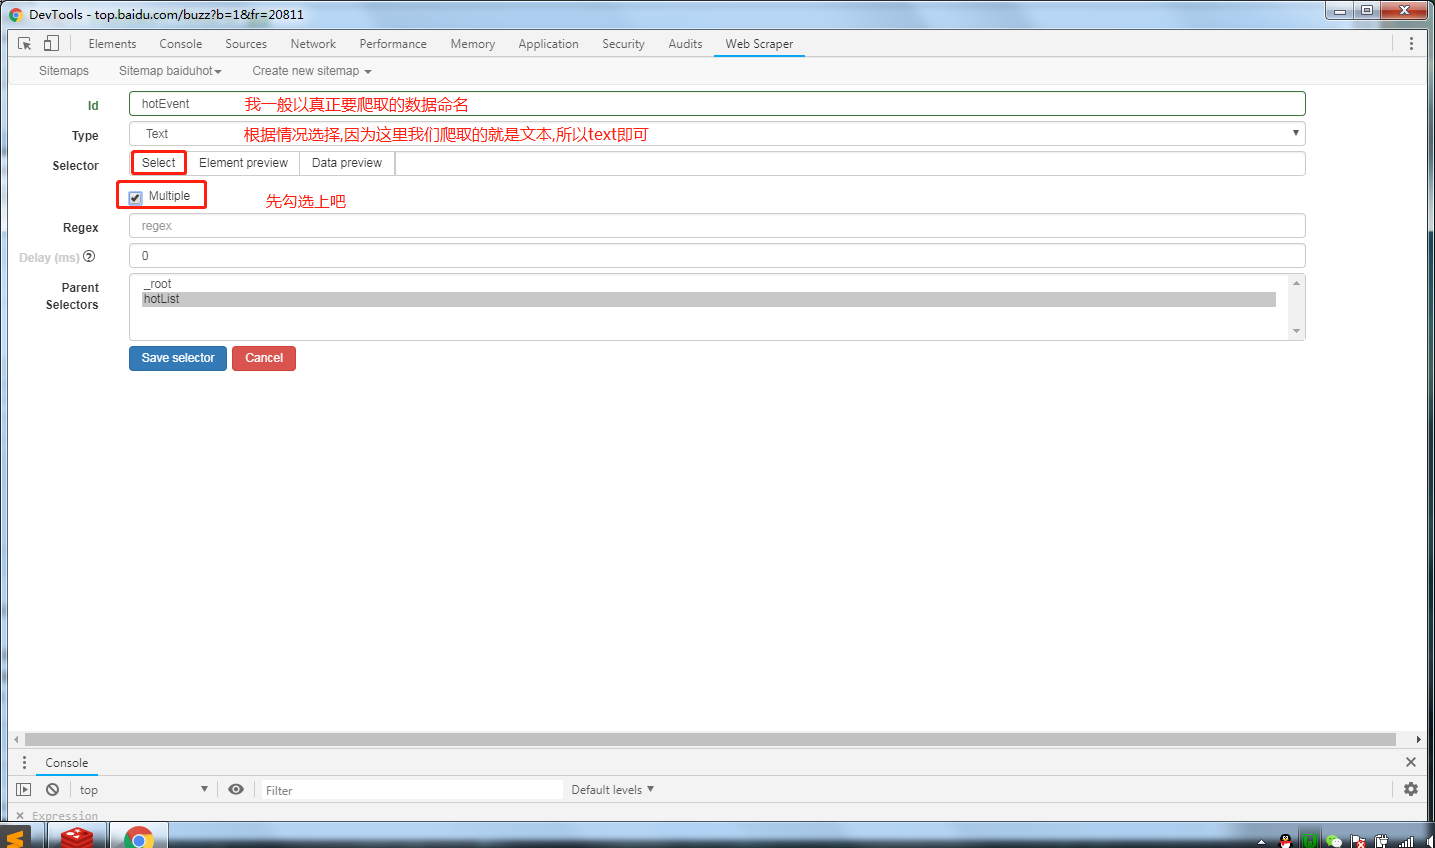
这时候页面的范围会变为黄色,鼠标移动到自己需要的信息处会有绿框将信息圈出来
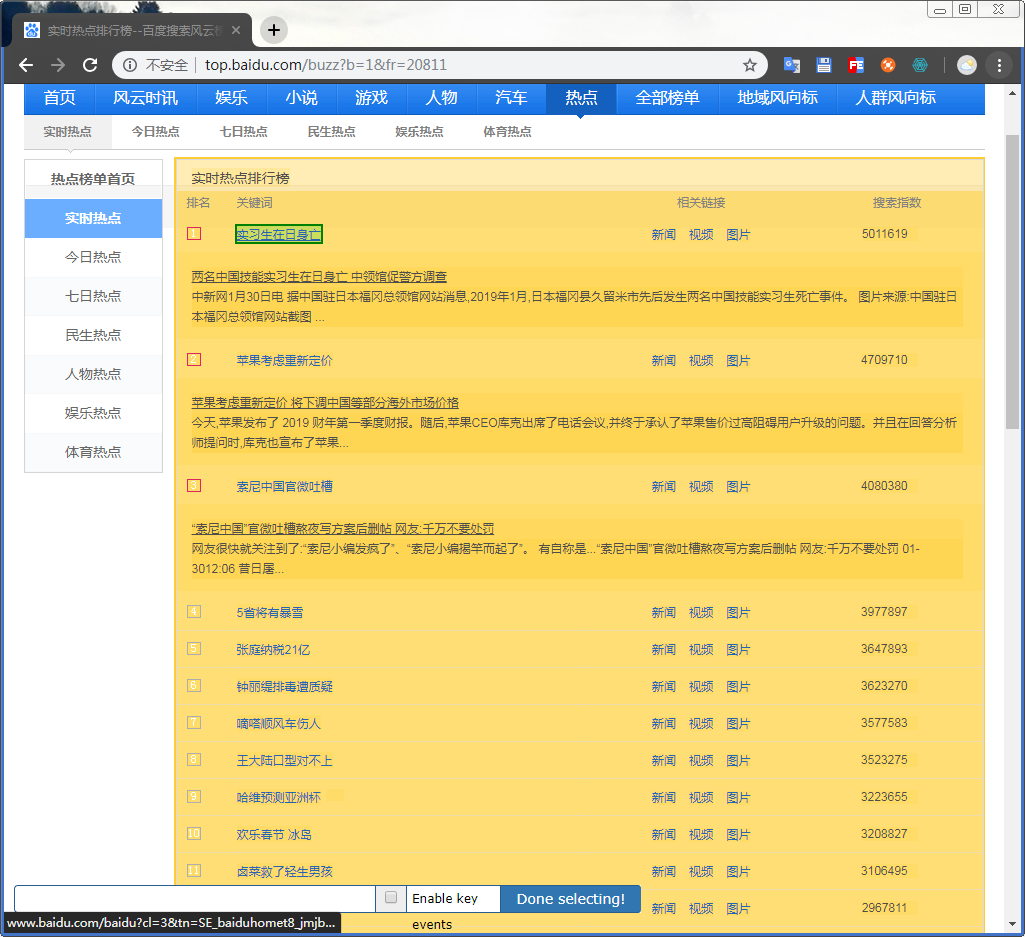
点击确认后会变为红色的,再次选择相同的会自动识别将同样标签下的包围起来,确认是自己需要的信息后直接Done selecting!
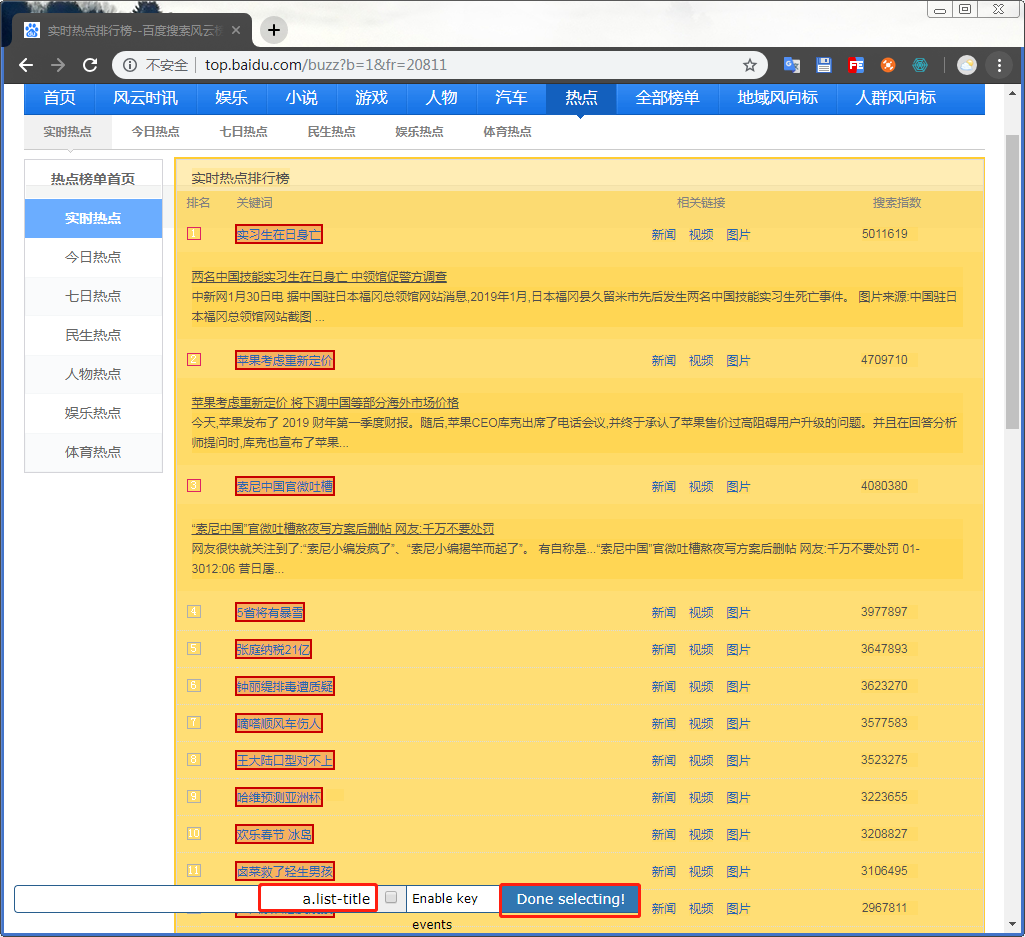
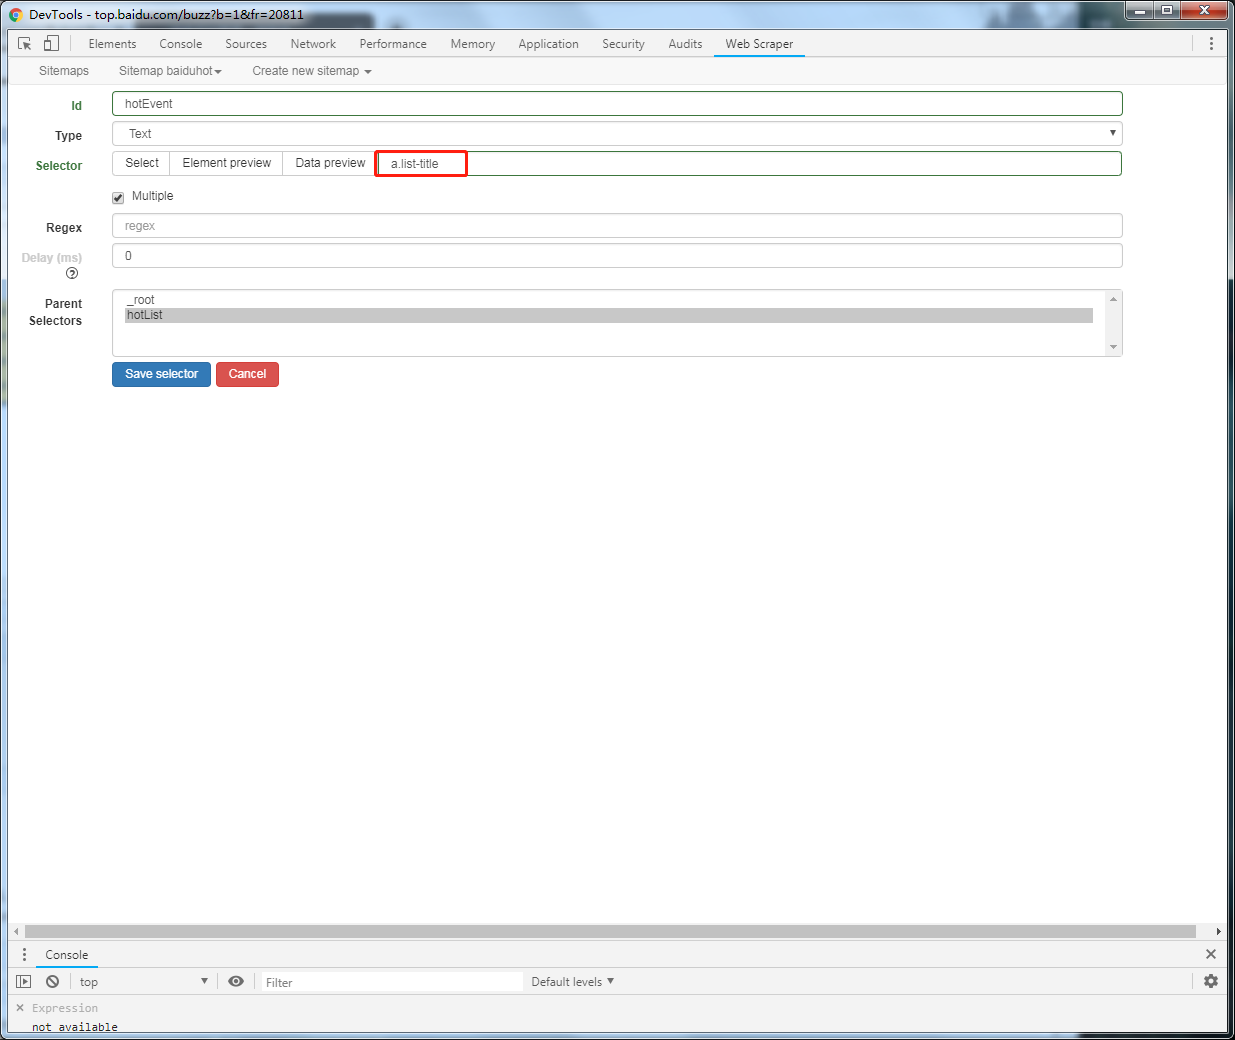
再次转到web scraper的控制台后,确认无误即可保存
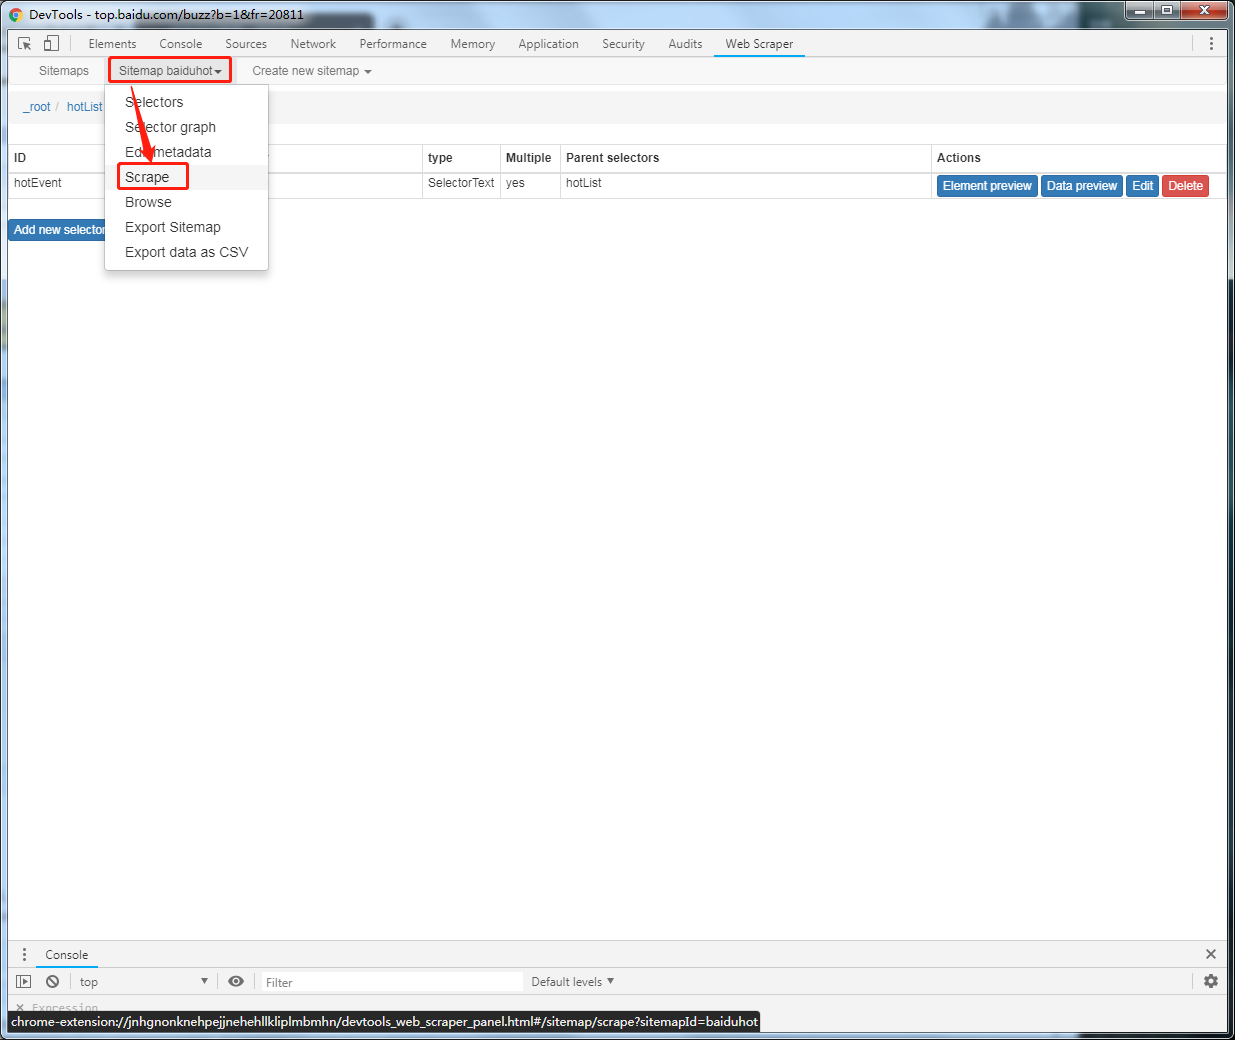
运行脚本,进行采集
默认配置即可,想修改也可以的,我一般直接默认的

点击开始脚本后,会将采集的页面弹出,采集完成右下角会出现提示,采集过程中点击refresh可以查看采集的数据
采集的数据
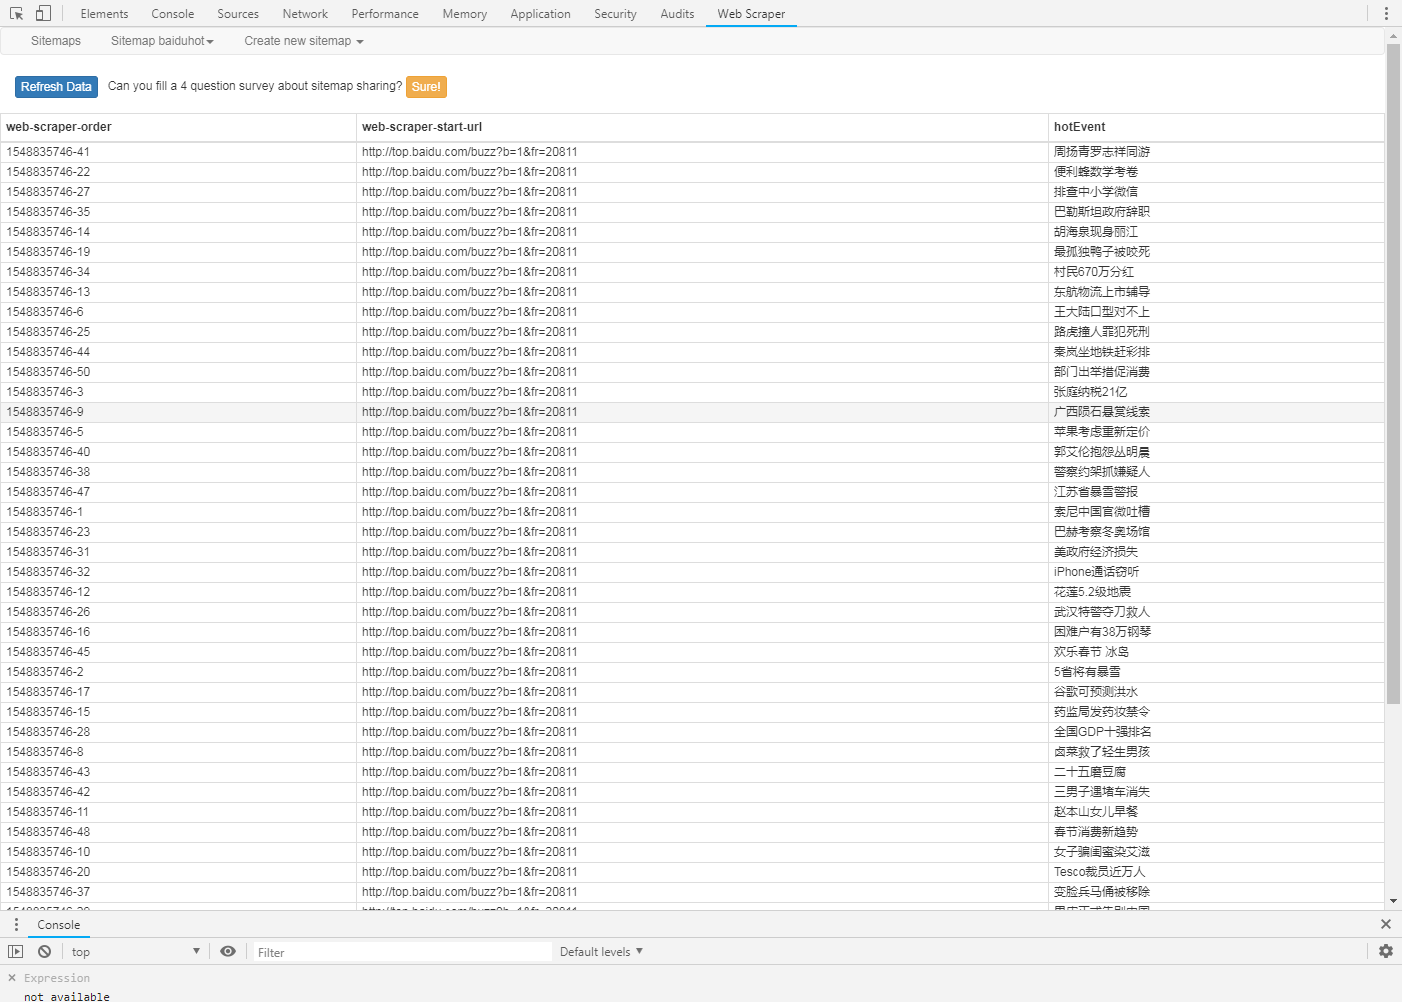
导出数据
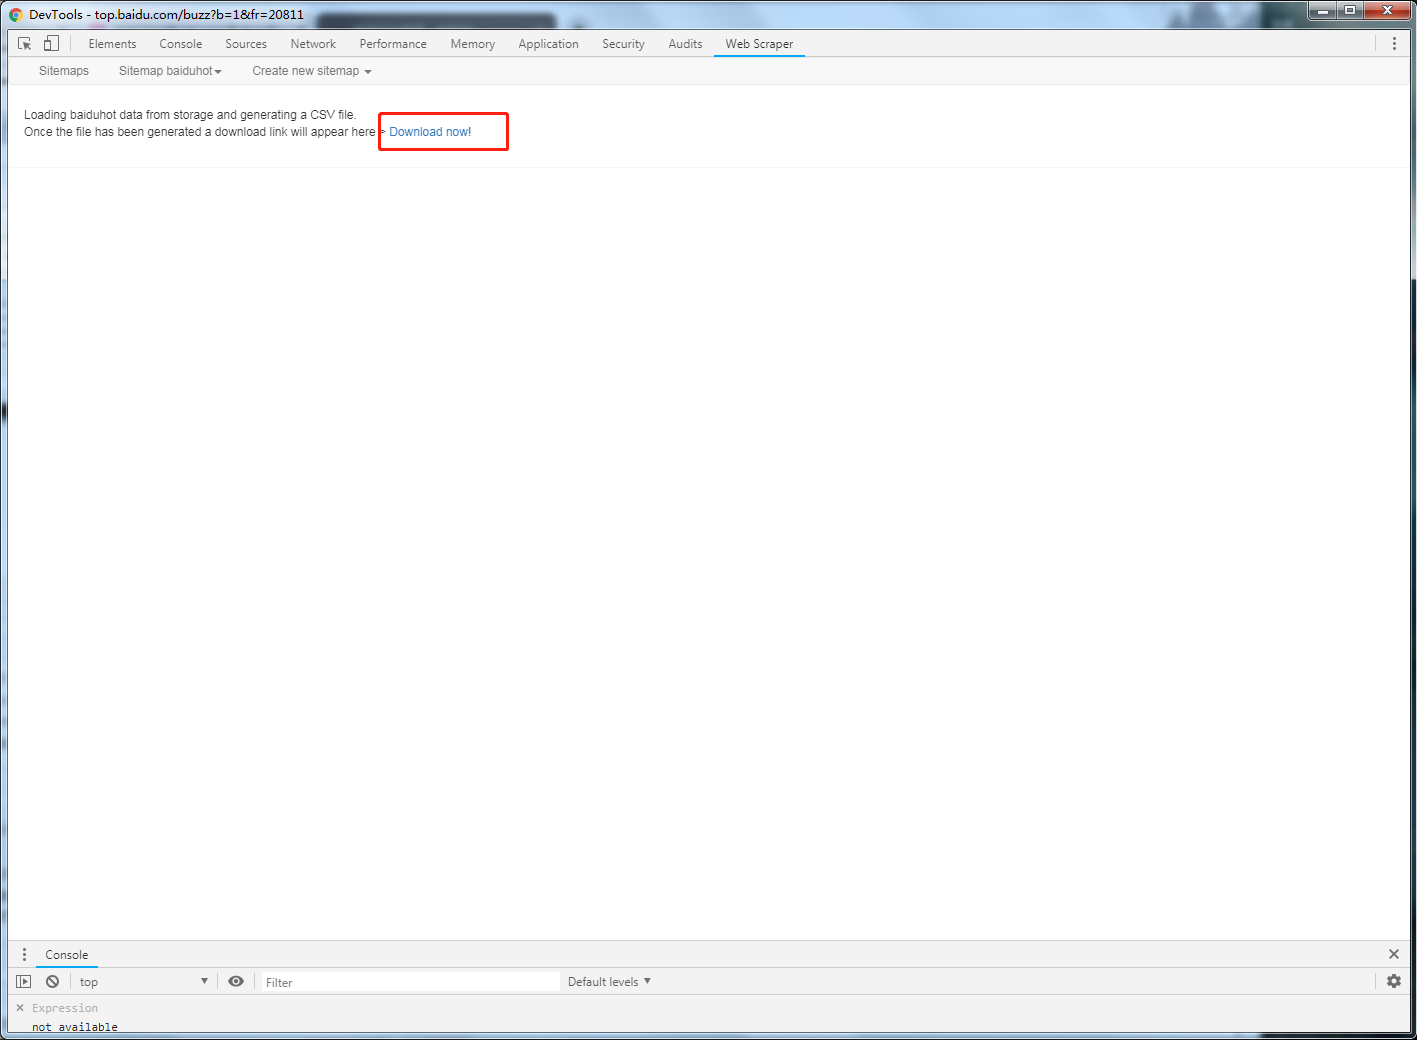
确认数据没有错误,是自己需要的即可,进行下载,以csv格式导出

点击Downolad now!即可下载
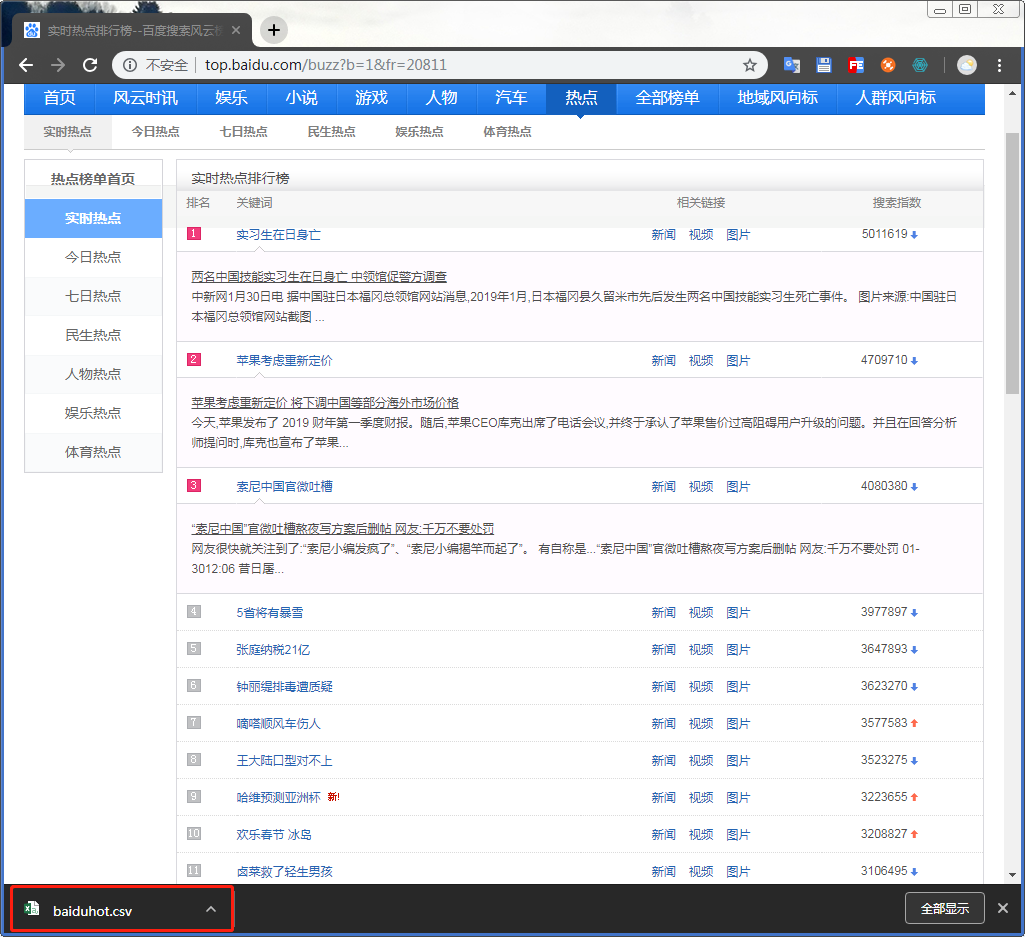
数据内容

到这里使用web scraper进行数据采集就结束了
web scraper——简单的爬取数据【二】的更多相关文章
- 简易数据分析 10 | Web Scraper 翻页——抓取「滚动加载」类型网页
这是简易数据分析系列的第 10 篇文章. 友情提示:这一篇文章的内容较多,信息量比较大,希望大家学习的时候多看几遍. 我们在刷朋友圈刷微博的时候,总会强调一个『刷』字,因为看动态的时候,当把内容拉到屏 ...
- 简易数据分析 12 | Web Scraper 翻页——抓取分页器翻页的网页
这是简易数据分析系列的第 12 篇文章. 前面几篇文章我们介绍了 Web Scraper 应对各种翻页的解决方法,比如说修改网页链接加载数据.点击"更多按钮"加载数据和下拉自动加载 ...
- Python爬虫入门教程 26-100 知乎文章图片爬取器之二
1. 知乎文章图片爬取器之二博客背景 昨天写了知乎文章图片爬取器的一部分代码,针对知乎问题的答案json进行了数据抓取,博客中出现了部分写死的内容,今天把那部分信息调整完毕,并且将图片下载完善到代码中 ...
- node.js爬取数据并定时发送HTML邮件
node.js是前端程序员不可不学的一个框架,我们可以通过它来爬取数据.发送邮件.存取数据等等.下面我们通过koa2框架简单的只有一个小爬虫并使用定时任务来发送小邮件! 首先我们先来看一下效果图 差不 ...
- 【个人】爬虫实践,利用xpath方式爬取数据之爬取虾米音乐排行榜
实验网站:虾米音乐排行榜 网站地址:http://www.xiami.com/chart 难度系数:★☆☆☆☆ 依赖库:request.lxml的etree (安装lxml:pip install ...
- scrapy爬取数据的基本流程及url地址拼接
说明:初学者,整理后方便能及时完善,冗余之处请多提建议,感谢! 了解内容: Scrapy :抓取数据的爬虫框架 异步与非阻塞的区别 异步:指的是整个过程,中间如果是非阻塞的,那就是异步 ...
- Python分页爬取数据的分析
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 向右奔跑 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- 借助Chrome和插件爬取数据
工具 Chrome浏览器 TamperMonkey ReRes Chrome浏览器 chrome浏览器是目前最受欢迎的浏览器,没有之一,它兼容大部分的w3c标准和ecma标准,对于前端工程师在开发过程 ...
- 使用webmagic爬虫对百度百科进行简单的爬取
分析要爬取的网页源码: 1.打开要分析的网页,查看源代码,找到要爬取的内容: (选择网页里的一部分右击审查元素也行) 2.导入jar包,这个就直接去网上下吧: 3.写爬虫: package com.g ...
随机推荐
- Java模拟登录带验证码的教务系统(原理详解)
一:原理 客户端访问服务器,服务器通过Session对象记录会话,服务器可以指定一个唯一的session ID作为cookie来代表每个客户端,用来识别这个客户端接下来的请求. 我们通过Chrome浏 ...
- JVM加载类冲突,导致Mybatis查数据库返回NULL的一个小问题
今天碰到个bug,虽然小,但是有点意思 背景是SpringMVC + Mybatis的一个项目,mapper文件里写了一条sql 大概相当于 select a from tableA where b ...
- tensorflow-gpu安装的一些注意
按正确的顺序安装,严格安装特定的版本 1,下载和安装严格版本的cuda和cuDnn,其他版本的不干活.比如要求9.0你就不能装9.1.https://www.tensorflow.org/instal ...
- mariadb(第一章)
数据库介绍 1.什么是数据库? 简单的说,数据库就是一个存放数据的仓库,这个仓库是按照一定的数据结构(数据结构是指数据的组织形式或数据之间的联系)来组织,存储的,我们可以通过数据库提供的多种方法来 ...
- Javascript模板引擎handlebars使用
源地址:http://rfyiamcool.blog.51cto.com/1030776/1278620 代码示例: <!DOCTYPE html> <html> <he ...
- 软工+C(8): 提问与回复
// 上一篇:野生程序员 // 下一篇:助教指南 在线上博客教学里引入了第三方助教,助教在每次作业期间尽力完成"消灭零点评"的目标.然而紧接而来的问题是:学生对博客作业点评的回复率 ...
- 【kindle笔记】之 《恶意》-2018-4-20
[kindle笔记]读书记录-总 在答辩和考试和各种大作业的重压以及两天后全校停电的巨大挤压中,一口气读完了恶意这本书. 这本书是我读的东野圭吾的第二本书.第一本是心心念念的<解忧杂货店> ...
- 数组建 BST
#include <bits/stdc++.h> using namespace std; const int maxn = 1e5 + 10; int N, root = 1; int ...
- 前端开发之jQuery库
使用jquery开发的时候,如果我们不想使用自己的jquery文件,那么可以引用现成的地址.方便日常开发使用 jquery-2.0以上版本 (注!不再支持IE 6/7/8) jquery-2.0.0百 ...
- AngularJS基于模块化的MVC实现
AngularJS基于模块化的MVC实现 <!DOCTYPE html> <html> <head> <meta charset="UTF-8&qu ...