
python网络爬虫笔记(五)
一、python的类对象的继承
1、所有的父类都是object类,由于类可以起到模块的作用,因此,可以在创建实例的时候,巴西一些认为必须要绑定的属性填写上去,通过定义一个特殊的方法 __init__,绑定属性值、,注意 __init__ 方法的第一个参数永远是self,表示创建的是实例本身,在__init__方法内部,就可以将各种属性绑定到self,因为self就是指向创建实例本身。有了__init__方法就不能在创建实例的时候传入空的参数。而且必须传入与__intit__方法匹配的参数。但是self不需要再次传入,python解释器自己会把实例变量传进。
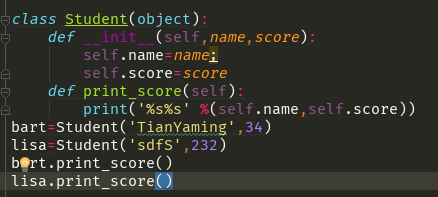

2、数据封装,面向对象编程最重要的是数据封装,在Student类中,每个实例都有各自的name 和score这些数据,可以通过函数来访问这些数据。封装的另一个好处就是可以随时给类添加新的方法,如果让内部的属性不被外部访问,可以把属性的名称前加上两个下划线__,,,实例的变量名如果以__开头,就表示这是一个私有变量(private)只可以在内部访问。
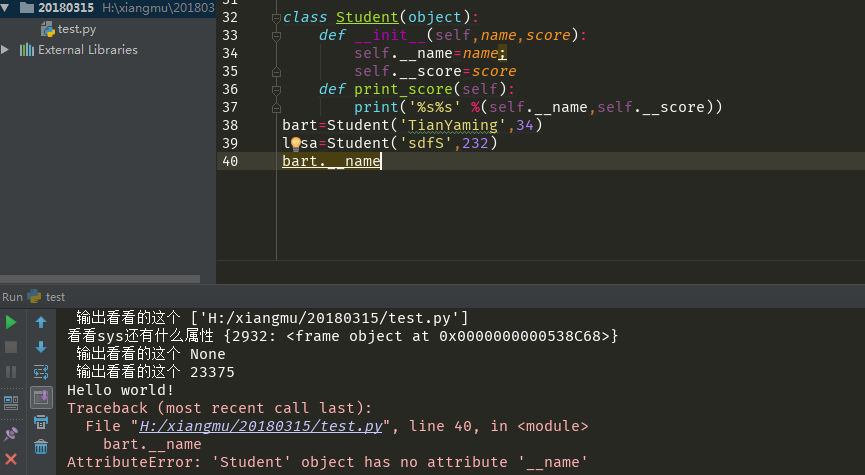
但是注意的一点就是 变量名__xx__这样双划线开头的并且是结尾的,是特殊变量。特殊变量只可以直接访问的。
3、判断一个对象是否属于这个类的语句
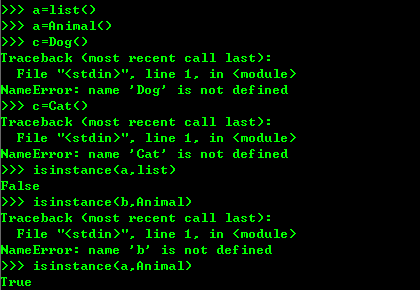
4、多态的好处就是当我们需要传入Dog Cat Tortoise 时,实际上任何依赖Animal作为参数的函数或者方法都可以不加修饰正常运行,原因就是出于多态,多态的好处,当我们传入Dog Cat 等 我们只需要修改Animal类就可以,因为Dog Cat 等就是Animal的类型,然后按照Animal类型进行操作,由于Animal类型有run()方法,因此传入的类型是Animal 类或者子类,就会自动调用实际类型的run() 方法,就是多态的。对于静态语言如果传入Animal类型,则传入的对象必须是Animal类型或者子类,否则无法调用run() 方法,对于python动态语言来说,只需要传入的对象有run()方法就可以啦。
继承可以父类的所有功能直接拿过来名字类只需要新增自己的特有方法,也可以吧父类不适合的方法覆盖重写,

5、类型判断type(),从这里可以看出type函数其实返回的就是 class
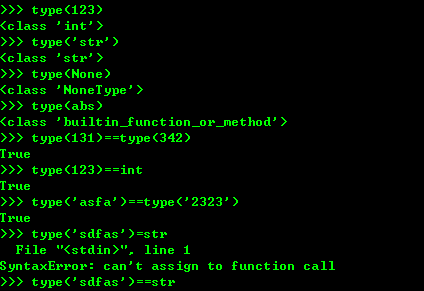
6、判断基本数据类型可以直接写int ,str等,但是如果判断一个对象是否是函数就要使用 types模块中定义的常量,
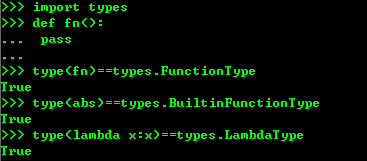
但是对于class继承关系来说,使用type()就很不方便,我们要判断class类型可以使用isinstance()函数,isinstance()判断一个对象是否是该类型的本身或者位于该类型的父类继承链接上。

能用type()判断的基本类型也可以会用isinstance()判断,获得一个对象的所有属性和方法使用dir()函数

顺便插一句 pycharm的server注册链接地址测试可行的http://idea.liyang.io
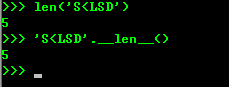
对对象进行属性的测试
python网络爬虫笔记(五)的更多相关文章
- Python网络爬虫笔记(五):下载、分析京东P20销售数据
(一) 分析网页 下载下面这个链接的销售数据 https://item.jd.com/6733026.html#comment 1. 翻页的时候,谷歌F12的Network页签可以看到下面 ...
- [Python]网络爬虫(五):urllib2的使用细节与抓站技巧
转自:http://blog.csdn.net/pleasecallmewhy/article/details/8925978 前面说到了urllib2的简单入门,下面整理了一部分urllib2的使用 ...
- [Python]网络爬虫(五):urllib2的使用细节与抓站技巧(转)
1.Proxy 的设置 urllib2 默认会使用环境变量 http_proxy 来设置 HTTP Proxy. 如果想在程序中明确控制 Proxy 而不受环境变量的影响,可以使用代理. 新建test ...
- Python网络爬虫笔记(二):链接爬虫和下载限速
(一)代码1(link_crawler()和get_links()实现链接爬虫) import urllib.request as ure import re import urllib.parse ...
- python网络爬虫笔记(九)
4.1.1 urllib2 和urllib是两个不一样的模块 urllib2最简单的就是使用urllie2.urlopen函数使用如下 urllib2.urlopen(url[,data[,timeo ...
- python网络爬虫笔记(八)
一.pthon 序列化json格式 1.将python内置对象转换成json 模块,dumps()方法返回的是一个str,内容是标准的JSON,dump()方法可以直接吧JSON写入一个file-li ...
- python网络爬虫笔记(六)
1.获取属性如果不存在就返回404,通过内置一系列函数,我们可以对任意python对象进行剖析,拿到其内部数据,但是要注意的是,只是在不知道对象信息的时候,我们可以获得对象的信息. 2.实例属性和类属 ...
- python网络爬虫笔记(四)
一.python中的高阶函数算法 1.sorted()函数的排序 sorted()函数是一个高阶函数,还可以接受一个key函数来实现自定义的函数排序,key指定的函数作用于每个序列元素上,并根据k ...
- python网络爬虫笔记(三)
一.切片和迭代 1.列表生成式 2.生成器的generate,但是generate保存的是算法,所以可以迭代计算,没有必要,每次调用generate 二.iteration 循环 1.凡是作用于for ...
随机推荐
- Leetcode#53.Maximum Subarray(最大子序和)
题目描述 给定一个序列(至少含有 1 个数),从该序列中寻找一个连续的子序列,使得子序列的和最大. 例如,给定序列 [-2,1,-3,4,-1,2,1,-5,4], 连续子序列 [4,-1,2,1] ...
- python 数据分析3
本节概要 pandas简介 安装 pip install pandas pandas的2个主要数据结构:DataFrame 和 Series Series series是一种类似于一维数组的对象,它由 ...
- 2017-2018-2 165X 『Java程序设计』课程 团队项目备选题目
2017-2018-2 165X 『Java程序设计』课程 团队项目备选题目 结合本课程时间安排,以及同学们的专业和课程内容,制定了以下六个题目供各小组选择.如有其他项目方案设想,可自行与老师沟通.老 ...
- Centos7 nginx报错403 forbidden
参考链接:http://www.cnblogs.com/chinway/archive/2017/08/14/7356239.html 因为安全性的考虑这个也是默认会出现的错误,因为SELinux的存 ...
- AtomicLong和LongAdder的区别
AtomicLong的原理是依靠底层的cas来保障原子性的更新数据,在要添加或者减少的时候,会使用死循环不断地cas到特定的值,从而达到更新数据的目的. LongAdder在AtomicLong的基础 ...
- 为共享服务器配置Oracle数据库
参考资料 https://docs.oracle.com/cd/E11882_01/server.112/e25494/manproc.htm#ADMIN00502
- SpringSocial业务系统与社交网站的绑定与解绑
SpringSocial提供了了以下三个服务,我们要做的仅仅是调用它们的服务,但是SpringSocial仅仅只提供了数据,没有提供视图 ⒈拿到所有社交网站与业务系统的绑定信息 SpringSocia ...
- Keepalived+LVS-DR+Nginx高可用故障切换模式
LVS架构中,不管是NAT模式还是DR模式,当后端的RS宕掉后,调度器依然会把请求转发到宕掉的RS上,这样的结果并不是我们想要的.其实,keepalived就可以解决问题,它不仅仅有高可用的功能,还有 ...
- MySQL:Your password has expired. To log in you must change it using a client that supports expired passwords
MySQL:V5.6.37 安装后发现没远程权限,为了方便,就直接把hostname@root修改为%@root,密码修改为和localhost@root一样 然后尴尬的事情发生了,本地登陆正常,远程 ...
- Python 编程核心知识体系(REF)
Python 编程核心知识体系: https://woaielf.github.io/2017/06/13/python3-all/ https://woaielf.github.io/page2/