
python网络爬虫笔记(六)
1、获取属性如果不存在就返回404,通过内置一系列函数,我们可以对任意python对象进行剖析,拿到其内部数据,但是要注意的是,只是在不知道对象信息的时候,我们可以获得对象的信息。

2、实例属性和类属性的绑定,由于python是 动态语言,根据类创建的实例可以任意绑定属性,给实例绑定属性的方法通过实例变量或者self变量。实例属性属于各个实例所有,互不干扰,类的属性属于类所有,所有实例共享一个属性,不要对实例属性和类属性使用相同的名字,否则将产生难以发现的错误。
3、使用__slots__变量限制class实例添加的属性。就是限制给class绑定属性。
class Student(object): @property
def score(self):
return self._score @score.setter
def score(self, value):
if not isinstance(value, int):
raise ValueError('score must be an integer!')
if value < 0 or value > 100:
raise ValueError('score must between 0 ~ 100!')
self._score = value@property的实现比较复杂,我们先考察如何使用。把一个getter方法变成属性,只需要加上@property就可以了,此时,@property本身又创建了另一个装饰器@score.setter,负责把一个setter方法变成属性赋值,于是,我们就拥有一个可控的属性操作:
4、多重继承,通过多重继承,一个子类可以获得多个父类的所用功能
5、 文档测试
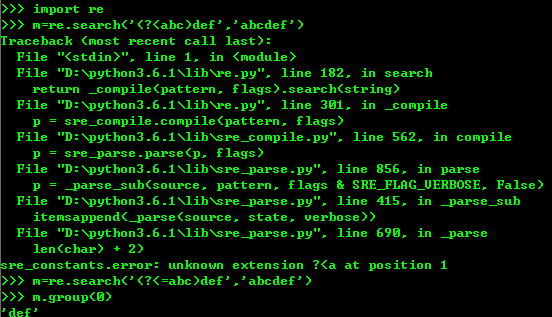
6、IO测试,注意:>>> f = open('/Users/michael/test.jpg', 'rb') >>> f.read() b'\xff\xd8\xff\xe1\x00\x18Exif\x00\x00...' # 十六进制表示的字节

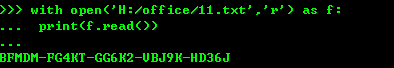
要读取非UTF-8编码的文本文件,需要给open()函数传入encoding参数,例如,读取GBK编码的文件:
>>> f = open('/Users/michael/gbk.txt', 'r', encoding='gbk')

>>> f.read()

'测试'遇到有些编码不规范的文件,你可能会遇到UnicodeDecodeError,因为在文本文件中可能夹杂了一些非法编码的字符。遇到这种情况,open()函数还接收一个errors参数,表示如果遇到编码错误后如何处理。最简单的方式是直接忽略:
>>> f = open('/Users/michael/gbk.txt', 'r', encoding='gbk', errors='ignore'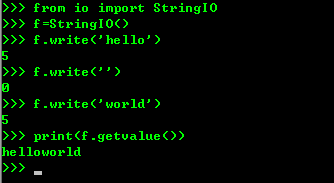
python网络爬虫笔记(六)的更多相关文章
- Python网络爬虫笔记(五):下载、分析京东P20销售数据
(一) 分析网页 下载下面这个链接的销售数据 https://item.jd.com/6733026.html#comment 1. 翻页的时候,谷歌F12的Network页签可以看到下面 ...
- [Python]网络爬虫(六):一个简单的百度贴吧的小爬虫
转自:http://blog.csdn.net/pleasecallmewhy/article/details/8927832 # -*- coding: utf-8 -*- #----------- ...
- Python网络爬虫笔记(二):链接爬虫和下载限速
(一)代码1(link_crawler()和get_links()实现链接爬虫) import urllib.request as ure import re import urllib.parse ...
- python网络爬虫笔记(九)
4.1.1 urllib2 和urllib是两个不一样的模块 urllib2最简单的就是使用urllie2.urlopen函数使用如下 urllib2.urlopen(url[,data[,timeo ...
- python网络爬虫笔记(八)
一.pthon 序列化json格式 1.将python内置对象转换成json 模块,dumps()方法返回的是一个str,内容是标准的JSON,dump()方法可以直接吧JSON写入一个file-li ...
- python网络爬虫笔记(五)
一.python的类对象的继承 1.所有的父类都是object类,由于类可以起到模块的作用,因此,可以在创建实例的时候,巴西一些认为必须要绑定的属性填写上去,通过定义一个特殊的方法 __init__, ...
- python网络爬虫笔记(四)
一.python中的高阶函数算法 1.sorted()函数的排序 sorted()函数是一个高阶函数,还可以接受一个key函数来实现自定义的函数排序,key指定的函数作用于每个序列元素上,并根据k ...
- python网络爬虫笔记(三)
一.切片和迭代 1.列表生成式 2.生成器的generate,但是generate保存的是算法,所以可以迭代计算,没有必要,每次调用generate 二.iteration 循环 1.凡是作用于for ...
- python网络爬虫笔记(一)
一.查询数据字典型数据 1.先说说dictionary查找和插入的速度极快,不会随着key的增加减慢速度,但是占用的内存大 2.list查找和插入的时间随着元素的增加而增加,但还是占用的空间小,内存浪 ...
随机推荐
- Leetcode#118. Pascal's Triangle(杨辉三角)
题目描述 给定一个非负整数 numRows,生成杨辉三角的前 numRows 行. 在杨辉三角中,每个数是它左上方和右上方的数的和. 示例: 输入: 5 输出: [ [1], [1,1], [1,2, ...
- mysql 原理 ~ 索引通说
简介: 来说说索引吧目的:为了加快数据库的数据查找速度,索引应用而生基础知识基本定义 1 遍历 所谓遍历二叉树,就是按一定的规则和顺序走遍二叉树的所有结点,使每一个结点都被访问一次,而且只被访问一次 ...
- python读取两个文件并且判断是否一致
''' 判断两个文件是否相同,如果不同请指出第几行不相同 ''' def f1vsf2(name1,name2): f1 = open(name1) f2 = open(name2) count = ...
- 【Linux】CentOS7.0下安装JDK环境
写在前面:此次试验是在CentOS7上面安装的,亲测成功. 所需工具:JDK1.8安装包,xftp 具体步骤: 1,首先使用xftp连接到自己的虚拟机,然后查看是否有"/usr/java/j ...
- 2018 Multi-University Training Contest 9 杭电多校第九场 (有坑待补)
咕咕咕了太久 多校博客直接从第三场跳到了第九场orz 见谅见谅(会补的!) 明明最后看下来是dp场 但是硬生生被我们做成了组合数专场…… 听说jls把我们用组合数做的题都用dp来了遍 这里只放了用组 ...
- 在Apache Struts中利用OGNL注入
前言 本文简要介绍了Apache Struts的OGNL注入缺陷,文章中介绍使用简单的应用程序复现OGNL注入.深入研究针对公共漏洞,并理解这类漏洞. 内容 安装Apache Tomcat服务器(入门 ...
- python3 - 默认参数为列表
默认参数的坑 定义一个函数,传入一个list,添加一个end再返回 1 2 3 def add_end(L=[]): L.append('END') return L 正常调用时,结 ...
- Java异常处理之try-with-resources
Oracle官方文档: http://docs.oracle.com/javase/7/docs/technotes/guides/language/try-with-resources.html 概 ...
- Boost.Asio的使用技巧
基本概念 Asio proactor I/O服务 work类 run() vs poll() stop() post() vs dispatch() buffer类 缓冲区管理 I/O对象 socke ...
- git与eclipse集成之导入组件到Eclipse工程
从工作目录中选择要导入的组件,右键选择:Import Projects,弹出窗口如下图所示,选择Import as general project 点击next,修改或使用默认的组件名称 点击fini ...