
HIVE-分桶表的详解和创建实例
我们学习一下分桶表,其实分区和分桶这两个概念对于初学者来说是比较难理解的。但对于理解了的人来说,发现又是如此简单。
我们先建立一个分桶表,并尝试直接上传一个数据
create table student4(sno int,sname string,sex string,sage int, sdept string) clustered by(sno) into 3 buckets row format delimited fields terminated by ',';

set hive.enforce.bucketing = true;强制分桶。

load data local inpath '/home/hadoop/hivedata/students.txt' overwrite into table student4;

我们看到虽然设置了强制分桶,但实际student表下面只有一个students一个文件。分桶也就是分区,分区数量等于文件数,所以上面方法并没有分桶。
现在,我们用插入的方法给另外一个分桶表传入同样数据
create table student4(sno int,sname string,sex string,sage int, sdept string) clustered by(sno) into 3 buckets row format delimited fields terminated by ',';

set hive.enforce.bucketing = true;强制分桶。

load data local inpath '/home/hadoop/hivedata/students.txt' overwrite into table student4;

我们看到虽然设置了强制分桶,但实际STUDENT表下面只有一个STUDENTS一个文件。

分桶也就是分区,分区数量等于文件数,所以上面方法并没有分桶。

#创建第2个分桶表

create table stu_buck(sno int,sname string,sex string,sage int,sdept string)

clustered by(sno)

sorted by(sno DESC)

into 4 buckets

row format delimited

fields terminated by ',';

#设置变量,设置分桶为true, 设置reduce数量是分桶的数量个数

set hive.enforce.bucketing = true;

set mapreduce.job.reduces=4;

#开会往创建的分通表插入数据(插入数据需要是已分桶, 且排序的)

#可以使用distribute by(sno) sort by(sno asc)   或是排序和分桶的字段相同的时候使用Cluster by(字段)

#注意使用cluster by  就等同于分桶+排序(sort)

insert into table stu_buck

select sno,sname,sex,sage,sdept from student distribute by(sno) sort by(sno asc);

Query ID = root_20171109145012_7088af00-9356-46e6-a988-f1fc5f6d2e13
Total jobs = 1
Launching Job 1 out of 1
Number of reduce tasks determined at compile time: 4
In order to change the average load for a reducer (in bytes):
  set hive.exec.reducers.bytes.per.reducer=<number>
In order to limit the maximum number of reducers:
  set hive.exec.reducers.max=<number>
In order to set a constant number of reducers:
  set mapreduce.job.reduces=<number>
Starting Job = job_1510197346181_0014, Tracking URL = http://server71:8088/proxy/application_1510197346181_0014/
Kill Command = /usr/local/hadoop/bin/hadoop job  -kill job_1510197346181_0014
Hadoop job information for Stage-1: number of mappers: 1; number of reducers: 4
2017-11-09 14:50:59,642 Stage-1 map = 0%,  reduce = 0%
2017-11-09 14:51:38,682 Stage-1 map = 100%,  reduce = 0%, Cumulative CPU 5.04 sec
2017-11-09 14:52:31,935 Stage-1 map = 100%,  reduce = 50%, Cumulative CPU 7.91 sec
2017-11-09 14:52:33,467 Stage-1 map = 100%,  reduce = 67%, Cumulative CPU 15.51 sec
2017-11-09 14:52:39,420 Stage-1 map = 100%,  reduce = 83%, Cumulative CPU 22.5 sec
2017-11-09 14:52:40,953 Stage-1 map = 100%,  reduce = 92%, Cumulative CPU 25.86 sec
2017-11-09 14:52:42,243 Stage-1 map = 100%,  reduce = 100%, Cumulative CPU 28.01 sec
MapReduce Total cumulative CPU time: 28 seconds 10 msec
Ended Job = job_1510197346181_0014
Loading data to table default.stu_buck
Table default.stu_buck stats: [numFiles=4, numRows=22, totalSize=527, rawDataSize=505]
MapReduce Jobs Launched:
Stage-Stage-1: Map: 1  Reduce: 4   Cumulative CPU: 28.01 sec   HDFS Read: 18642 HDFS Write: 819 SUCCESS
Total MapReduce CPU Time Spent: 28 seconds 10 msec
OK
Time taken: 153.794 seconds
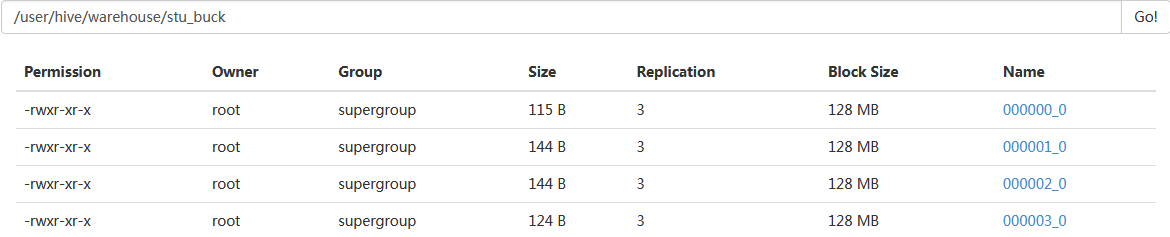
我们设置reduce的数量为4,学过mapreduce的人应该知道reduce数等于分区数,也等于处理的文件数量。
把表或分区划分成bucket有两个理由1,更快,桶为表加上额外结构,链接相同列划分了桶的表,可以使用map-side join更加高效。2,取样sampling更高效。没有分区的话需要扫描整个数据集。hive> create table bucketed_user (id int,name string)> clustered by (id) sorted by (id asc) into 4 buckets;重点1:CLUSTERED BY来指定划分桶所用列和划分桶的个数。HIVE对key的hash值除bucket个数取余数,保证数据均匀随机分布在所有bucket里。重点2:SORTED BY对桶中的一个或多个列另外排序总结:我们发现其实桶的概念就是MapReduce的分区的概念,两者完全相同。物理上每个桶就是目录里的一个文件,一个作业产生的桶(输出文件)数量和reduce任务个数相同。而分区表的概念,则是新的概念。分区代表了数据的仓库,也就是文件夹目录。每个文件夹下面可以放不同的数据文件。通过文件夹可以查询里面存放的文件。但文件夹本身和数据的内容毫无关系。桶则是按照数据内容的某个值进行分桶,把一个大文件散列称为一个个小文件。这些小文件可以单独排序。如果另外一个表也按照同样的规则分成了一个个小文件。两个表join的时候,就不必要扫描整个表,只需要匹配相同分桶的数据即可。效率当然大大提升。同样,对数据抽样的时候,也不需要扫描整个文件。只需要对每个分区按照相同规则抽取一部分数据即可。
HIVE-分桶表的详解和创建实例的更多相关文章
- hive分桶表bucketed table分桶字段选择与个数确定
为什么分桶 (1)获得更高的查询处理效率.桶为表加上了额外的结构,Hive 在处理有些查询时能利用这个结构.具体而言,连接两个在(包含连接列的)相同列上划分了桶的表,可以使用 Map 端连接 (Map ...
- 一起学Hive——创建内部表、外部表、分区表和分桶表及导入数据
Hive本身并不存储数据,而是将数据存储在Hadoop的HDFS中,表名对应HDFS中的目录/文件.根据数据的不同存储方式,将Hive表分为外部表.内部表.分区表和分桶表四种数据模型.每种数据模型各有 ...
- hive中的分桶表
桶表也是一种用于优化查询而设计的表类型.创建通表时,指定桶的个数.分桶的依据字段,hive就可以自动将数据分桶存储.查询时只需要遍历一个桶里的数据,或者遍历部分桶,这样就提高了查询效率 ------创 ...
- hive 分区表和分桶表
1.创建分区表 hive> create table weather_list(year int,data int) partitioned by (createtime string,area ...
- 第2节 hive基本操作:11、hive当中的分桶表以及修改表删除表数据加载数据导出等
分桶表 将数据按照指定的字段进行分成多个桶中去,说白了就是将数据按照字段进行划分,可以将数据按照字段划分到多个文件当中去 开启hive的桶表功能 set hive.enforce.bucketing= ...
- Hive 学习之路(五)—— Hive 分区表和分桶表
一.分区表 1.1 概念 Hive中的表对应为HDFS上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为HDFS上表目录的子目录,数据按照分区存储在子目录中.如 ...
- Hive 系列(五)—— Hive 分区表和分桶表
一.分区表 1.1 概念 Hive 中的表对应为 HDFS 上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为 HDFS 上表目录的子目录,数据按照分区存储在子 ...
- Hive ACID和事务表支持详解
一.ACID介绍 ACID就是常见数据库事务的四大特性:Atomicity(原子性).Consistency(一致性).Isolation(隔离性).Durability(持久性). 在Hive 0. ...
- Hive 教程(四)-分区表与分桶表
在 hive 中分区表是很常用的,分桶表可能没那么常用,本文主讲分区表. 概念 分区表 在 hive 中,表是可以分区的,hive 表的每个区其实是对应 hdfs 上的一个文件夹: 可以通过多层文件夹 ...
随机推荐
- [EffectiveC++]item22:Declare data members private
将成员变量隐藏在函数接口的背后,可以为“所有可能的实现”提供弹性, 假设我们有一个public成员变量,而我们最终取消了它,多少代码可能会被破坏呢?那是一个不可知的大量. protected成员变量就 ...
- vue怎么不通过dom操作获取dom节点
今天写一个公众号的项目,写了一个vue的搜索组件,点击搜索框时,背景出现一个遮罩,代码结构如下: template:`<div class="searchBar-div"&g ...
- node.js和MongoDB学习网址
回想我写的node.js和MongoDB的博客,都是菜鸟教程那里的知识,所以我打算不写了,那些都是基础,在项目开发中,我发现单单有那些基础不行,这些基础可以尽快学好,然后学习项目开发过程 下面是两个教 ...
- angularJs的工具方法1
一.angular.bind(); 改this指向 <!DOCTYPE HTML> <html ng-app> <head> <meta http-equ ...
- FZU-1608 Huge Mission 线段树(更新懒惰标记)
题目链接: https://cn.vjudge.net/problem/FZU-1608 题目大意: 长度n,m次操作:每次操作都有三个数:a,b,c:意味着(a,b]区间单位长度的价值为c,若某段长 ...
- 渲染、render与绘制
渲染是抽象到具体的过程: 抽象:图片信息的描述(比如一条线:两个端点的位置.线粗.颜色等特征): 具体:依据抽象信息得到的可视图片(绘制过程). 渲染是中文翻译的问题,有种添油加醋的感觉.直意就是交与 ...
- [LuoguP1363]幻想迷宫
[LuoguP1363]幻想迷宫(Link) 现在有一个迷宫,从迷宫边界的任意一点可以走到对面,即:若都是路面,则可以从\((1, i)\)走到\((N, i)\).其余情况依旧.问是否可以从指定的起 ...
- C++11之std::future和std::promise
为什么C++11引入std::future和std::promise?C++11创建了线程以后,我们不能直接从thread.join()得到结果,必须定义一个变量,在线程执行时,对这个变量赋值,然后执 ...
- unordered_map 遇到 vector subscript out of range 的错误提示
错误类型 当调用unordered_map的函数的时候,会出现如下问题: 使用linux运行则会提示 float exeption(core dump) 原因 遇到vector subscript o ...
- IQueryable和IEnumerable
使用EF你必须知道这两个的区别,可以帮助我们的提升性能. 表达树:Linq 表达 ①IQueryable和IEnumerable IQueryable 延时执行:扩展方法接受的是Expression( ...