
Apriori算法思想和其python实现
第十一章 使用Apriori算法进行关联分析
一.导语
“啤酒和尿布”问题属于经典的关联分析。在零售业,医药业等我们经常需要是要关联分析。我们之所以要使用关联分析,其目的是为了从大量的数据中找到一些有趣的关系。这些有趣的关系将对我们的工作和生活提供指导作用。
二.关联分析的基本概念
所谓的关联分析就是从海量的数据中找到一些有趣的关系。关联分析它有两个目标,一个是发现频繁项集,另一个是发现关联规则。
关联分析常用到的四个概念是:频繁项集,关联规则,置信度,支持度。频繁项集指的是频繁同时出现的数据子集,这里的频繁是一般是根据支持度来确定的(当然你也可以根据其他的度量标准)。支持度指的是该项集最所有数据中出现的概率。关联规则指的是两个个体之间的关联性, 它一般用置信度来进行衡量。置信度指的是该项集出现的条件概率,这里的条件概率的条件也就是我们关联规则中的条件。比如 尿布->啤酒,那么此时的条件就是尿布。
三.Apriori原理
Apriori,顾名思义它是利用先验的知识,对未知的知识进行判断。
我们知道如果一个项集是频繁项集,那么它的子集必定也是频繁项集。比如{啤酒,尿布}是频繁项集,那么{尿布}和{啤酒}必定也是频繁项集。如果反向的思考的话,也就是说一个项集它不是频繁项集,那么它的超集就不会是频繁项集。Apriori算法正是利用了这个特点,对关联分析求解频繁项集的复杂度进行了很大程度的降低。
四.Apriori算法
如果直接的求解所有可能的频繁项集,那么它的复杂度太高,是无法忍受的,因此为了降低问题的复杂度,我们基于Apriori原理,提出了Apriori算法。换句话说Apriori算法是一种简便的求解频繁项集的方法。
Apriori算法的特点:
它的优点是:算法简单,容易实现
它的缺点是:不适用于大数据集
它的适用类型是:标称型数据
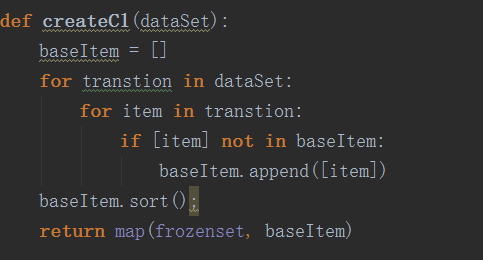
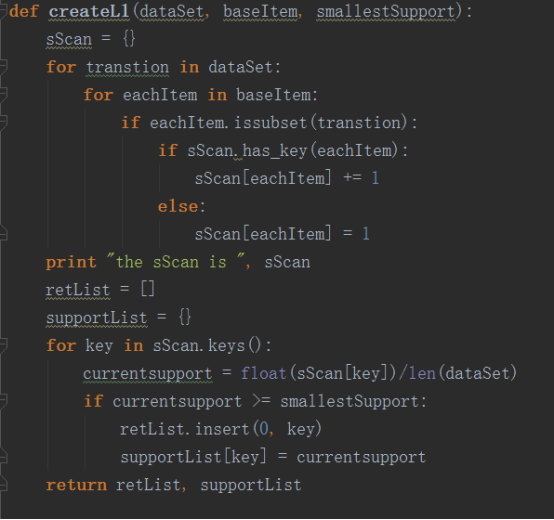
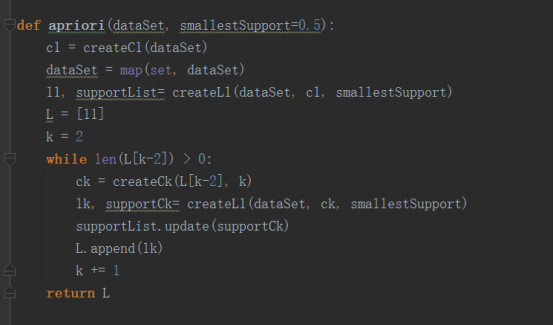
Apriori算法的过程是:首先生成单个商品的项集,然后根据最小支持度来去除不符合条件的项集,然后将剩下的商品进行两两组合,再根据最小支持度对不符合条件的项集进行删除,以此类推,直到所有不符合最小支持度的项集都被去掉。
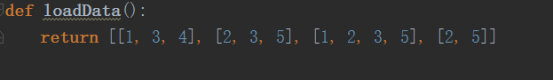
以下是实现Apriori算法的python代码:
1.获取数据:
2.生成单个商品的项集:
3.根据最支持度去除不符合条件的项集:
4.写一个函数用来获取包含k个item的项集

5.Apriori算法
五.从频繁项集中挖掘关联规则
频繁项集的度量指标是支持度,关联规则的度量指标是置信度。当一个规则的置信度满足一定的值时,我们就说这个规则是关联规则。关联规则具有和频繁项集类似的性质。当一规则不满足最小置信度的时候那么这个规则的子集也不满足最小置信度,换言之,如果可以从后件大小为1的规则出发,不断的产生新的规则。(这里所谓的后件,相当于结论,比如 尿布->啤酒, 这里的尿布是前件, 啤酒是后件)。
从求解关联规则的算法上看,他和apriori算法异曲同工,不过它有一个新的名字称之为分级算法。它就是先产生后件大小为1的规则,然后删除不满足置信度的规则,然后再利用剩下的规则,生出后件大小为2的规则,然后删除不满足置信度的规则,以此类推。
以下是python代码:
1.首先我们创建主函数
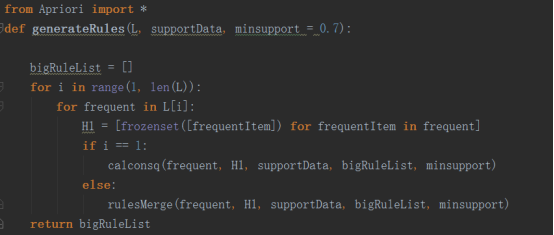
2.其次我们根据最小置信度来获取规则
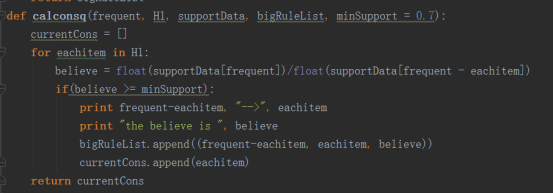
3.我们创建规则
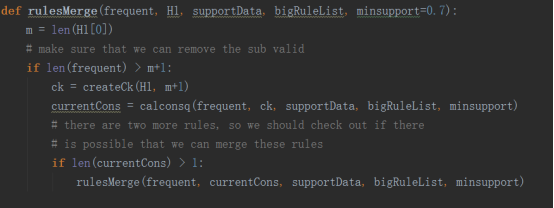
六.总结
关联分析的目的是为了寻找数据中有趣的关系,这里的有趣的关系有两层含义,一种是经常同时出现的项,也就是我们常说的寻找频繁项集;另一种是满足如果那么这种导出关系的项,也就是我们常说的寻找关联规则。频繁项集是由支持度来进行度量的,关联规则是由置信度进行度量的。
我们在进行关联分析的时候需要对结果进行组合,但是我们知道组合是很耗时的,为了简化计算,降低解空间,我们采用了Apriori算法。该算法的基本思想就是一个非频繁项集的超集也是非频繁项集。这个概念也可以拓展到关联规则,此时变为,一个规则不是关联规则那么它的超集也不是关联规则,该算法称之为分级算法。
虽然Apriori算法能够在一定的程度上减少计算量,但是因为它在每次频繁项集改变的时候都需要重新遍历一次数据库,不适用于大型数据,为了解决这个问题人们又提出了FP-growth算法。FP-growth算法和Apriori算法相比只需要遍历两次数据库,速度有了很大的提升。
Apriori算法思想和其python实现的更多相关文章
- Apriori算法的原理与python 实现。
前言:这是一个老故事, 但每次看总是能从中想到点什么.在一家超市里,有一个有趣的现象:尿布和啤酒赫然摆在一起出售.但是这个奇怪的举措却使尿布和啤酒的销量双双增加了.这不是一个笑话,而是发生在美国沃尔玛 ...
- FP-growth算法思想和其python实现
第十二章 使用FP-growth算法高效的发现频繁项集 一.导语 FP-growth算法是用于发现频繁项集的算法,它不能够用于发现关联规则.FP-growth算法的特殊之处在于它是通过构建一棵Fp树, ...
- Apriori算法原理总结
Apriori算法是常用的用于挖掘出数据关联规则的算法,它用来找出数据值中频繁出现的数据集合,找出这些集合的模式有助于我们做一些决策.比如在常见的超市购物数据集,或者电商的网购数据集中,如果我们找到了 ...
- Apriori算法介绍(Python实现)
导读: 随着大数据概念的火热,啤酒与尿布的故事广为人知.我们如何发现买啤酒的人往往也会买尿布这一规律?数据挖掘中的用于挖掘频繁项集和关联规则的Apriori算法可以告诉我们.本文首先对Apriori算 ...
- 数据挖掘入门系列教程(五)之Apriori算法Python实现
数据挖掘入门系列教程(五)之Apriori算法Python实现 加载数据集 获得训练集 频繁项的生成 生成规则 获得support 获得confidence 获得Lift 进行验证 总结 参考 数据挖 ...
- Python两步实现关联规则Apriori算法,参考机器学习实战,包括频繁项集的构建以及关联规则的挖掘
.caret, .dropup > .btn > .caret { border-top-color: #000 !important; } .label { border: 1px so ...
- Apriori 算法python实现
1. Apriori算法简介 Apriori算法是挖掘布尔关联规则频繁项集的算法.Apriori算法利用频繁项集性质的先验知识,通过逐层搜索的迭代方法,即将K-项集用于探察(k+1)项集,来穷尽数据集 ...
- 【机器学习】Apriori算法——原理及代码实现(Python版)
Apriopri算法 Apriori算法在数据挖掘中应用较为广泛,常用来挖掘属性与结果之间的相关程度.对于这种寻找数据内部关联关系的做法,我们称之为:关联分析或者关联规则学习.而Apriori算法就是 ...
- Python <算法思想集结>之初窥基础算法
1. 前言 数据结构和算法是程序的 2 大基础结构,如果说数据是程序的汽油,算法则就是程序的发动机. 什么是数据结构? 指数据在计算机中的存储方式,数据的存储方式会影响到获取数据的便利性. 现实生活中 ...
随机推荐
- Android用AlarmManager实现后台任务-android学习之旅(63)
因为Timer不能唤醒cpu,所以会在省电的原因下失效,所以需要唤醒cpu在后台稳定化的执行任务,AlarmManager能够唤醒cpu 这个例子讲解了如何通过Service来在后他每一个小时执行.特 ...
- WebLogic重启
1,用户名密码登录. 2,切换到weblogic的bin目录下 cd bea/user_projects/domains/base_domain/bin/ 3,先停止服务器 ./stopWe ...
- Java中四大代码块的执行顺序(附code)
验证证的方法是写code,如下: public class test { static class A { public static String name = "hello"; ...
- ReactJs和React Native的那些事
介绍 1,React Js的目的 是为了使前端的V层更具组件化,能更好的复用,它能够使用简单的html标签创建更多的自定义组件标签,内部绑定事件,同时可以让你从操作dom中解脱出来,只需要操作数据就会 ...
- 【翻译】针对多种设备定制Ext JS 5应用程序
原文:Tailoring Your Ext JS 5 Application for a Multi-Device World 概述 鉴于当今设备和表单因素的扩散,要针对所有这些可能性来优化应用程序已 ...
- mysql进阶(四)mysql中select
mysql中select * for update 注: FOR UPDATE 仅适用于InnoDB,且必须在事务区块(BEGIN/COMMIT)中才能生效. 作用 锁定该语句所选择到的对象.防止在 ...
- Mahout系列之----距离度量
x = (x1,...,xn) 和y = (y1,...,yn) 之间的距离为 (1)欧氏距离 EuclideanDistanceMeasure (2)曼哈顿距离 ManhattanDis ...
- 谈谈PCI的GXL
最近在测试PCI的GXL,对测试的结果大致列举一下. 何为GXL: GXL( Geoimaging Accelerator, GXL )是PCI公司面向海量影像自动化生产提出的新一代解决方案产品,主要 ...
- Hadoop 数据排序(一)
1.概述 1TB排序通常用于衡量分布式数据处理框架的数据处理能力.Terasort是Hadoop中的的一个排序作业.那么Terasort在Hadoop中是怎样实现的呢?本文主要从算法设计角度分析Ter ...
- android 防止反编译的若干方法
第一种方式:混淆策略 混淆策略是每个应用必须增加的一种防护策略,同时他不仅是为了防护,也是为了减小应用安装包的大小,所以他是每个应用发版之前必须要添加的一项功能,现在混淆策略一般有两种: 对代码的混淆 ...