
用python这样做,offer还不是拿到手软?
大家好鸭,我是小熊猫

本篇代码提供者: 自游老师
老师简介:
青灯教育金牌讲师
3年Python爬虫开发经验
七年在线教育经验
擅长Python、c等语言
曾任职多家互联网公司爬虫工程师、Python讲师
[环境使用]:
- Python 3.8
- Pycharm
如需软件安装包,Pycharm专业版激活码可以私我领取呐~
[模块使用]:
- requests >>> pip install requests
- re
- json
- csv
如果安装python第三方模块:
- win + R 输入 cmd 点击确定, 输入安装命令 pip install 模块名 (pip install requests)
回车 - 在pycharm中点击Terminal(终端) 输入安装命令
如何配置pycharm里面的python解释器?
- 选择file(文件) >>> setting(设置) >>> Project(项目) >>> python
interpreter(python解释器) - 点击齿轮, 选择add
- 添加python安装路径
pycharm如何安装插件?
- 选择file(文件) >>> setting(设置) >>> Plugins(插件)
- 点击 Marketplace 输入想要安装的插件名字 比如:翻译插件 输入 translation / 汉化插件 输入 Chinese
- 选择相应的插件点击 install(安装) 即可
- 安装成功之后 是会弹出 重启pycharm的选项 点击确定, 重启即可生效
基本流程思路: <可以通用>
一. 数据来源分析
网页开发者工具进行抓包分析…
- F12打开开发者工具, 刷新网页
- 通过关键字进行搜索, 找到相应的数据, 查看response响应数据
- 确定数据之后, 查看headers确定请求url地址 请求方式 以及 请求参数
二. 代码实现过程:
- 发送请求, 用python代码模拟浏览器对于url地址发送请求
- 获取数据, 获取服务器返回response响应数据
- 解析数据, 提取我们想要招聘信息数据
- 保存数据, 保存到表格文件里面
代码
如有需要本文章源码、安装包、视频教程、解答都可以私我哦~
如果不想一个个复制源码的小可耐也可以私信我,我发你完整源码鸭~
导入模块
# 导入数据请求模块

import requests

# 导入正则表达式模块

import re

# 导入json模块

import json

# 导入格式化输出模块

import pprint

# 导入csv模块

import csv

# 导入时间模块

import time

# 导入随机模块

import random

# 有没有用utf-8保存表格数据,乱码的?

源码、解答、教程可加Q裙:660193417免费领取
f = open('data多页_1.csv', mode='a', encoding='utf-8', newline='')  # 打开一个文件 data.csv

csv_writer = csv.DictWriter(f, fieldnames=[

    '职位',

    '城市',

    '经验',

    '学历',

    '薪资',

    '公司',

    '福利待遇',

    '公司领域',

    '公司规模',

    '公司类型',

    '发布日期',

    '职位详情页',

    '公司详情页',

])

csv_writer.writeheader()
1. 发送请求,
用python代码模拟浏览器对于url地址发送请求
不要企图一节课, 掌握所有内容, 要学习听懂思路, 每一步我们为什么这么做…
知道headers 1
不知道headers 2
headers 请求头, 作用伪装python代码, 伪装成浏览器
字典形式, 构建完整键值对
如果当你headers伪装不够的时候, 你可能会被服务器识别出来, 你是爬虫程序, 从而不给你相应的数据内容
2. 获取数据
得到数据, 不是你想要数据内容, 你可能是被反爬了, 要多加一些伪装 <小伏笔>
# print(response.text) 字符串数据类型
3. 解析数据, 提取我们想要数据内容
re.findall() 就是从什么地方去找什么样数据内容
[0] 表示提取列表里面第一个元素 —> list index out of range 所以你的列表是空列表
用正则表达式/css/xpath提取数据返回是空列表 —> 1. 你语法写错 2. response.text 没有你想要数据
—> 是不是被反爬(验证码 需要登陆) 是不是headers参数给少了 是不是被封IP
    html_data = re.findall('window.__SEARCH_RESULT__ = (.*?)</script>', response.text)[0]

    # print(html_data)

    json_data = json.loads(html_data)

    # pprint.pprint(json_data)

    # 通过字典取值方法 把职位信息列表提取出来, 通过for循环遍历一个一个提取职位信息

    for index in json_data['engine_jds']:

        # 根据冒号左边的内容, 提取冒号右边的内容

        # pprint.pprint(index)

        try:

            dit = {

                '职位': index['job_title'],

                '城市': index['attribute_text'][0],

                '经验': index['attribute_text'][1],

                '学历': index['attribute_text'][2],

                '薪资': index['providesalary_text'],

                '公司': index['company_name'],

                '福利待遇': index['jobwelf'],

                '公司领域': index['companyind_text'],

                '公司规模': index['companysize_text'],

                '公司类型': index['companytype_text'],

                '发布日期': index['issuedate'],

                '职位详情页': index['job_href'],

                '公司详情页': index['company_href'],

            }

            csv_writer.writerow(dit)

            print(dit)

        except:

            pass
详情页数据
爬虫基本思路是什么?
数据来源分析
请求响应 请求那个网站呢? 网址是什么 请求方式是什么 请求参数要什么?
发送请求 —> 获取数据 —> 解析数据 —> 保存数据
导入模块
import requests

import parsel
url = 'https://jobs.这里自己打一下吧,不然就有版权投诉了.com/shanghai-jdq/137393082.html?s=sou_sou_soulb&t=0_0'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/101.0.0.0 Safari/537.36',

}

response = requests.get(url=url, headers=headers)

response.encoding = response.apparent_encoding  # 自动识别编码

print(response.text)

selector = parsel.Selector(response.text)

content_1 = selector.css('.cn').get()

content_2 = selector.css('.tCompany_main').get()

content = content_1 + content_2

# 文件名 公司名字 + 职位名字

with open('python.html', mode='w', encoding='utf-8') as f:

    f.write(content)
可视化
代码
import pandas as pd

from pyecharts.charts import *

from pyecharts import options as opts

import re

from pyecharts.globals import ThemeType

from pyecharts.commons.utils import JsCode

df = pd.read_csv("招聘数据.csv")

df.head()

df.info()

df['薪资'].unique()

df['bottom']=df['薪资'].str.extract('^(\d+).*')

df['top']=df['薪资'].str.extract('^.*?-(\d+).*')

df['top'].fillna(df['bottom'],inplace=True)

df['commision_pct']=df['薪资'].str.extract('^.*?·(\d{2})薪')

df['commision_pct'].fillna(12,inplace=True)

df['commision_pct']=df['commision_pct'].astype('float64')

df['commision_pct']=df['commision_pct']/12

df.dropna(inplace=True)

源码、解答、教程可加Q裙:660193417免费领取

df['bottom'] = df['bottom'].astype('int64')

df['top'] = df['top'].astype('int64')

df['平均薪资'] = (df['bottom']+df['top'])/2*df['commision_pct']

df['平均薪资'] = df['平均薪资'].astype('int64')

df.head()
df['薪资'] = df['薪资'].apply(lambda x:re.sub('.*千/月', '0.3-0.7万/月', x))

df["薪资"].unique()

df['bottom'] = df['薪资'].str.extract('^(.*?)-.*?')

df['top'] = df['薪资'].str.extract('^.*?-(\d\.\d|\d)')

df.dropna(inplace=True)

df['bottom'] = df['bottom'].astype('float64')

df['top'] = df['top'].astype('float64')

df['平均薪资'] = (df['bottom']+df['top'])/2 * 10

df.head()

mean = df.groupby('学历')['平均薪资'].mean().sort_values()

x = mean.index.tolist()

y = mean.values.tolist()

c = (

    Bar()

    .add_xaxis(x)

    .add_yaxis(

        "学历",

        y

    )

    .set_global_opts(title_opts=opts.TitleOpts(title="不同学历的平均薪资"),datazoom_opts=opts.DataZoomOpts())

    .set_series_opts(label_opts=opts.LabelOpts(is_show=False))

)

c.render_notebook()
color_js = """new echarts.graphic.LinearGradient(0, 1, 0, 0,

    [{offset: 0, color: '#63e6be'}, {offset: 1, color: '#0b7285'}], false)"""

color_js1 = """new echarts.graphic.LinearGradient(0, 0, 0, 1, [{

                            offset: 0,

                            color: '#ed1941'

                        }, {

                            offset: 1,

                            color: '#009ad6'

                        }], false)"""

dq = df.groupby('城市')['职位'].count().to_frame('数量').sort_values(by='数量',ascending=False).reset_index()

x_data = dq['城市'].values.tolist()[:20]

y_data = dq['数量'].values.tolist()[:20]

b1 = (

        Bar(init_opts=opts.InitOpts(theme=ThemeType.DARK,bg_color=JsCode(color_js1),width='1000px',height='600px'))

        .add_xaxis(x_data)

        .add_yaxis('',

                   y_data ,

                   category_gap="50%",

                   label_opts=opts.LabelOpts(

                        font_size=12,

                        color='yellow',

                        font_weight='bold',

                        font_family='monospace',

                        position='insideTop',

                        formatter = '{b}\n{c}'

                    ),

                  )

        .set_series_opts(

            itemstyle_opts={

                "normal": {

                    "color": JsCode(color_js),

                    "barBorderRadius": [15, 15, 0, 0],

                    "shadowColor": "rgb(0, 160, 221)",

                }

            }

        )

        .set_global_opts(

            title_opts=opts.TitleOpts(title='招 聘 数 量 前 20 的 城 市 区 域',

                                       title_textstyle_opts=opts.TextStyleOpts(color="yellow"),

                                       pos_top='7%',pos_left = 'center'

                                     ),

            legend_opts=opts.LegendOpts(is_show=False),

            xaxis_opts=opts.AxisOpts(axislabel_opts=opts.LabelOpts(rotate=-15)),

            yaxis_opts=opts.AxisOpts(name="",

                                     name_location='middle',

                                     name_gap=40,

                                     name_textstyle_opts=opts.TextStyleOpts(font_size=16)),

                         datazoom_opts=[opts.DataZoomOpts(range_start=1,range_end=50)]

                        )

    )

b1.render_notebook()
boss = df['学历'].value_counts()

x = boss.index.tolist()

y = boss.values.tolist()

data_pair = [list(z) for z in zip(x, y)]

c = (

    Pie(init_opts=opts.InitOpts(width="1000px", height="600px", bg_color="#2c343c"))

    .add(

        series_name="学历需求占比",

        data_pair=data_pair,

        label_opts=opts.LabelOpts(is_show=False, position="center", color="rgba(255, 255, 255, 0.3)"),

    )

    .set_series_opts(

        tooltip_opts=opts.TooltipOpts(

            trigger="item", formatter="{a} <br/>{b}: {c} ({d}%)"

        ),

        label_opts=opts.LabelOpts(color="rgba(255, 255, 255, 0.3)"),

    )

    .set_global_opts(

        title_opts=opts.TitleOpts(

            title="学历需求占比",

            pos_left="center",

            pos_top="20",

            title_textstyle_opts=opts.TextStyleOpts(color="#fff"),

        ),

        legend_opts=opts.LegendOpts(is_show=False),

    )

    .set_colors(["#D53A35", "#334B5C", "#61A0A8", "#D48265", "#749F83"])

)

c.render_notebook()
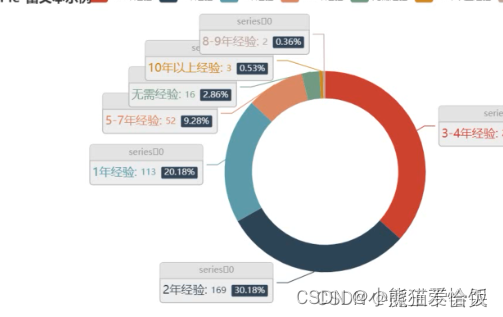
boss = df['经验'].value_counts()

x = boss.index.tolist()

y = boss.values.tolist()

data_pair = [list(z) for z in zip(x, y)]

c = (

    Pie(init_opts=opts.InitOpts(width="1000px", height="600px", bg_color="#2c343c"))

    .add(

        series_name="经验需求占比",

        data_pair=data_pair,

        label_opts=opts.LabelOpts(is_show=False, position="center", color="rgba(255, 255, 255, 0.3)"),

    )

    .set_series_opts(

        tooltip_opts=opts.TooltipOpts(

            trigger="item", formatter="{a} <br/>{b}: {c} ({d}%)"

        ),

        label_opts=opts.LabelOpts(color="rgba(255, 255, 255, 0.3)"),

    )

    .set_global_opts(

        title_opts=opts.TitleOpts(

            title="经验需求占比",

            pos_left="center",

            pos_top="20",

            title_textstyle_opts=opts.TextStyleOpts(color="#fff"),

        ),

        legend_opts=opts.LegendOpts(is_show=False),

    )

    .set_colors(["#D53A35", "#334B5C", "#61A0A8", "#D48265", "#749F83"])

)

c.render_notebook()
boss = df['公司领域'].value_counts()

x = boss.index.tolist()

y = boss.values.tolist()

data_pair = [list(z) for z in zip(x, y)]

c = (

    Pie(init_opts=opts.InitOpts(width="1000px", height="600px", bg_color="#2c343c"))

    .add(

        series_name="公司领域占比",

        data_pair=data_pair,

        label_opts=opts.LabelOpts(is_show=False, position="center", color="rgba(255, 255, 255, 0.3)"),

    )

    .set_series_opts(

        tooltip_opts=opts.TooltipOpts(

            trigger="item", formatter="{a} <br/>{b}: {c} ({d}%)"

        ),

        label_opts=opts.LabelOpts(color="rgba(255, 255, 255, 0.3)"),

    )

    .set_global_opts(

        title_opts=opts.TitleOpts(

            title="公司领域占比",

            pos_left="center",

            pos_top="20",

            title_textstyle_opts=opts.TextStyleOpts(color="#fff"),

        ),

        legend_opts=opts.LegendOpts(is_show=False),

    )

    .set_colors(["#D53A35", "#334B5C", "#61A0A8", "#D48265", "#749F83"])

)

c.render_notebook()
from pyecharts import options as opts

from pyecharts.charts import Pie

from pyecharts.faker import Faker

boss = df['经验'].value_counts()

x = boss.index.tolist()

y = boss.values.tolist()

data_pair = [list(z) for z in zip(x, y)]

源码、解答、教程可加Q裙:660193417免费领取

c = (

    Pie()

    .add("", data_pair)

    .set_colors(["blue", "green", "yellow", "red", "pink", "orange", "purple"])

    .set_global_opts(title_opts=opts.TitleOpts(title="经验要求占比"))

    .set_series_opts(label_opts=opts.LabelOpts(formatter="{b}: {c}"))

)

c.render_notebook()
from pyecharts import options as opts

from pyecharts.charts import Pie

from pyecharts.faker import Faker

boss = df['经验'].value_counts()

x = boss.index.tolist()

y = boss.values.tolist()

data_pair = [list(z) for z in zip(x, y)]

c = (

    Pie()

    .add(

        "",

        data_pair,

        radius=["40%", "55%"],

        label_opts=opts.LabelOpts(

            position="outside",

            formatter="{a|{a}}{abg|}\n{hr|}\n {b|{b}: }{c}  {per|{d}%}  ",

            background_color="#eee",

            border_color="#aaa",

            border_width=1,

            border_radius=4,

            rich={

                "a": {"color": "#999", "lineHeight": 22, "align": "center"},

                "abg": {

                    "backgroundColor": "#e3e3e3",

                    "width": "100%",

                    "align": "right",

                    "height": 22,

                    "borderRadius": [4, 4, 0, 0],

                },

                "hr": {

                    "borderColor": "#aaa",

                    "width": "100%",

                    "borderWidth": 0.5,

                    "height": 0,

                },

                "b": {"fontSize": 16, "lineHeight": 33},

                "per": {

                    "color": "#eee",

                    "backgroundColor": "#334455",

                    "padding": [2, 4],

                    "borderRadius": 2,

                },

            },

        ),

    )

    .set_global_opts(title_opts=opts.TitleOpts(title="Pie-富文本示例"))

)

c.render_notebook()

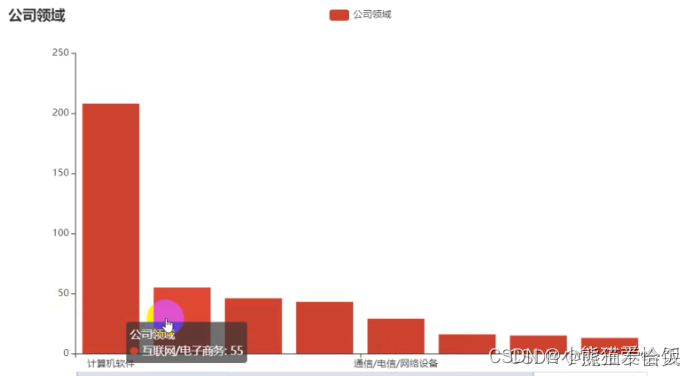
gsly = df['公司领域'].value_counts()[:10]

x1 = gsly.index.tolist()

y1 = gsly.values.tolist()

c = (

    Bar()

    .add_xaxis(x1)

    .add_yaxis(

        "公司领域",

        y1

        源码、解答、教程可加Q裙:660193417免费领取

    )

    .set_global_opts(title_opts=opts.TitleOpts(title="公司领域"),datazoom_opts=opts.DataZoomOpts())

    .set_series_opts(label_opts=opts.LabelOpts(is_show=False))

)

c.render_notebook()

gsgm = df['公司规模'].value_counts()[1:10]

x2 = gsgm.index.tolist()

y2 = gsgm.values.tolist()

c = (

    Bar()

    .add_xaxis(x2)

    .add_yaxis(

        "公司规模",

        y2

    )

    .set_global_opts(title_opts=opts.TitleOpts(title="公司规模"),datazoom_opts=opts.DataZoomOpts())

    .set_series_opts(label_opts=opts.LabelOpts(is_show=False))

)

c.render_notebook()
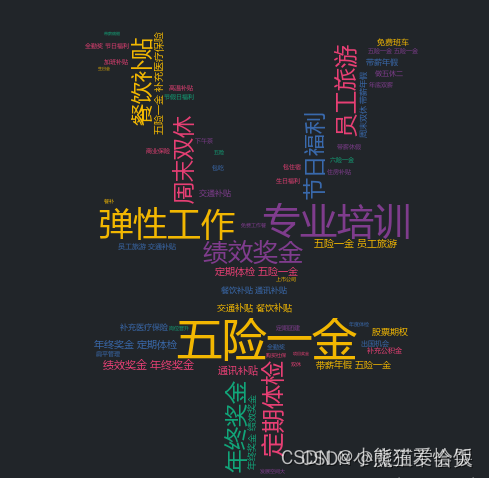
import stylecloud

from PIL import Image

welfares = df['福利'].dropna(how='all').values.tolist()

welfares_list = []

for welfare in welfares:

    welfares_list += welfare.split(',')

pic_name = '福利词云.png'

stylecloud.gen_stylecloud(

    text=' '.join(welfares_list),

    font_path='msyh.ttc',

    palette='cartocolors.qualitative.Bold_5',

    max_font_size=100,

    icon_name='fas fa-yen-sign',

    background_color='#212529',

    output_name=pic_name,

    )

Image.open(pic_name)
部分效果展示

尾语
本文章就写完啦~~~感兴趣的小伙伴可以复制代码去试试
你们的支持是我最大的动力!!记得三连哦~ 欢迎大家阅读往期的文章呀~
我是小熊猫,咱下篇文章见啦(✿◡‿◡)

用python这样做,offer还不是拿到手软?的更多相关文章
- Python来做应用题及思路
Python来做应用题及思路 最近找工作头疼没事就开始琢磨python解应用题应该可以,顺便还可以整理下思路当然下面的解法只是个人理解,也欢迎大佬们给意见或者指点更好的解决办法等于优化代码了嘛,也欢迎 ...
- Python 能做什么?
Python 能做什么? Python具有简单.易学.免费.开源.可移植.可扩展.可嵌入.面向对象等优点,我所关注的是网络爬虫方面,2018即将到来,我准备步入python的世界. Hello,wor ...
- 你都用python来做什么?
首页发现话题 提问 你都用 Python 来做什么? 关注问题写回答 编程语言 Python 编程 Python 入门 Python 开发 你都用 Python 来做什么? 发现很 ...
- 一篇文章告你python能做什么,该不该学?好不好学?适不适合学?
一.python好学吗?简单吗?容易学吗?没有编程的领取能学吗? 最近有很多小伙伴都在问我这些问题.在这里,我想说,python非常简单易学. 1,简单, Python 非常易于读写,开发者可以把更多 ...
- Python能做什么,自学Python效果怎么样?
短时间掌握一门技能是现代社会的需求.生活节奏越来越快,现在不是大鱼吃小鱼,而是快鱼吃慢鱼的时代,人的时间比机器的时间更值钱.Python作为一种轻量级编程语言,语言简洁开发快,没那么多技巧,受到众多追 ...
- python+opencv中最近出现的一些变化( OpenCV 官方的 Python tutorial目前好像还没有改过来?) 记一次全景图像的拼接
最近在学习过程中发现opencv有了很多变动, OpenCV 官方的 Python tutorial目前好像还没有改过来,导致大家在学习上面都出现了一些问题,现在做一个小小的罗列,希望对大家有用 做的 ...
- 可以用 Python 编程语言做哪些神奇好玩的事情?除了生孩子不能,其他全都行!
坦克大战 源自于一个用Python写各种小游戏的github合集,star数1k.除了坦克大战外,还包含滑雪者.皮卡丘GOGO.贪吃蛇.推箱子.拼图等游戏. 图片转铅笔画 帮助你快速生成属于自己的铅笔 ...
- 改改Python代码,运行速度还能提升6万倍
这份最新研究指出,在后摩尔定律时代,人类所获得的的算力提升将更大程度上来源于计算堆栈的「顶层」,即软件.算法和硬件架构,这将成为一个新的历史趋势. 很多人学习python,不知道从何学起.很多人学习p ...
- 可以用 Python 编程语言做哪些神奇好玩的事情?
作者:造数科技链接:https://www.zhihu.com/question/21395276/answer/219747752 使用Python绘图 我们先来看看,能画出哪样的图 更强大的是,每 ...
随机推荐
- 如何调试手机上的网页以及基于Cordova/Phonegap的Hybrid应用
开发手机页面以及Hybird应用时,调试曾经是个老大难问题,不时需要用写log等方式曲线救国. 实际上,Chrome和Android(需要4.4+版本)已经提供了不亚于电脑版本的调试功能,只是看样子还 ...
- docker基础_docker镜像与分层
docker镜像与分层 docker镜像由一些松耦合的制度镜像层组成 docker负责堆叠这些镜像层并将它们表示为单个统一的对象 当 docker image pull ubuntu:latest 时 ...
- Android第五六周作业
1.返回键实现对话框弹出是否退出应用程序 package com.example.zuoye1; import androidx.appcompat.app.AlertDialog; import a ...
- SpringCloudAlibaba微服务docker容器打包和部署示例实战
概述 我们使用前面<SpringCloudAlibaba注册中心与配置中心之利器Nacos实战与源码分析(中)>的两个微服务示例,分别是库存微服务和订单微服务,基于Nacos注册中心和配置 ...
- Java SE 01
强类型语言 要求变量的使用要严格符合规定,所有变量都必须先定义后使用 Java的数据类型分为两大类 基本类型(promitive type) 数值类型 ① 整数类型 byte 占1个字节范围:-128 ...
- python学习-Day16
目录 今日内容详细 内置函数补充 常见内置函数 help() id() int() isinstance() pow() round() sum() 求和 迭代器 可迭代对象 什么是可迭代对象? 哪些 ...
- 服务器BIOS和BMC等知识详解
一个执着于技术的公众号 引言:以BIOS为核心的固件产业,是信创产业链的重要组成部分,可被誉为信创产业的"山海关".在计算机体系中,BIOS 有着比操作系统更为底层和基础性的作用, ...
- 更换国内镜像源进行pip安装
Linux中当我们需要安装某个模块时(比如tensorflow2.0.0),常见有三种方法: pip install tensorflow==2.0.0 pip install https://pyp ...
- 探索 Python/Django 支持分布式多租户数据库,如 Postgres+Citus
在 确定分布策略 中,我们讨论了在多租户用例中使用 Citus 所需的与框架无关的数据库更改. 在这里,我们专门研究如何借助 django-multitenant 库将多租户 Django 应 用程序 ...
- Jmeter接口测试流程详解(中科软测认证中心)
1.jmeter简介 Jmeter是由Apache公司开发的java开源项目,所以想要使用它必须基于java环境才可以: Jmeter采用多线程,允许通过多个线程并发取样或通过独立的线程对不同的功能同 ...