
scrapy框架系列 (2) 一个简单案例
学习目标
- 创建一个Scrapy项目
- 定义提取的结构化数据(Item)
- 编写爬取网站的 Spider 并提取出结构化数据(Item)
- 编写 Item Pipelines 来存储提取到的Item(即结构化数据)
一. 新建项目(scrapy startproject)
- 在开始爬取之前,必须创建一个新的Scrapy项目。进入自定义的项目目录中,运行下列命令:
scrapy startproject mySpider
- 其中, mySpider 为项目名称,可以看到将会创建一个 mySpider 文件夹,目录结构大致如下:
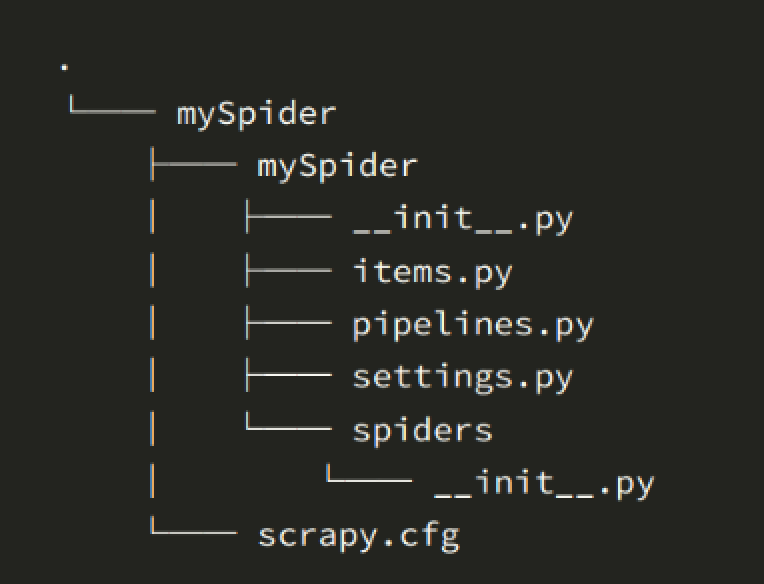
下面来简单介绍一下各个主要文件的作用:
scrapy.cfg :项目的配置文件
mySpider/ :项目的Python模块,将会从这里引用代码
mySpider/items.py :项目的目标文件
mySpider/pipelines.py :项目的管道文件
mySpider/settings.py :项目的设置文件
mySpider/spiders/ :存储爬虫代码目录
二、明确目标(mySpider/items.py)
我们打算抓取:http://www.itcast.cn/channel/teacher.shtml 网站里的所有讲师的姓名、职称和个人信息。
打开mySpider目录下的items.py
Item 定义结构化数据字段,用来保存爬取到的数据,有点像Python中的dict,但是提供了一些额外的保护减少错误。
可以通过创建一个 scrapy.Item 类, 并且定义类型为 scrapy.Field的类属性来定义一个Item(可以理解成类似于ORM的映射关系)。
接下来,创建一个ItcastItem 类,和构建item模型(model)。
import scrapy

class ItcastItem(scrapy.Item):

    name = scrapy.Field()

    level = scrapy.Field()

    info = scrapy.Field()
三、制作爬虫 (spiders/itcastSpider.py)
爬虫功能要分两步:
1. 爬数据
- 在当前目录下输入命令,将在
mySpider/spider目录下创建一个名为itcast的爬虫,并指定爬取域的范围:
scrapy genspider itcast "itcast.cn"
- 打开 mySpider/spider目录里的 itcast.py,默认增加了下列代码:
import scrapy

class ItcastSpider(scrapy.Spider):

    name = "itcast"

    allowed_domains = ["itcast.cn"]

    start_urls = (

        'http://www.itcast.cn/',

    )

    def parse(self, response):

        pass
其实也可以由我们自行创建itcast.py并编写上面的代码,只不过使用命令可以免去编写固定代码的麻烦
要建立一个Spider, 你必须用scrapy.Spider类创建一个子类,并确定了三个强制的属性 和 一个方法。
name = "":这个爬虫的识别名称,必须是唯一的,在不同的爬虫必须定义不同的名字。allow_domains = []是搜索的域名范围,也就是爬虫的约束区域,规定爬虫只爬取这个域名下的网页,不存在的URL会被忽略。start_urls = ():爬取的URL元祖/列表。爬虫从这里开始抓取数据,所以,第一次下载的数据将会从这些urls开始。其他子URL将会从这些起始URL中继承性生成。parse(self, response):解析的方法,每个初始URL完成下载后将被调用,调用的时候传入从每一个URL传回的Response对象来作为唯一参数,主要作用如下:- 负责解析返回的网页数据(response.body),提取结构化数据(生成item)
- 生成需要下一页的URL请求。
将start_urls的值修改为需要爬取的第一个url
start_urls = ("http://www.itcast.cn/channel/teacher.shtml",)
修改parse()方法
def parse(self, response):

    filename = "teacher.html"

    open(filename, 'w').write(response.body)
然后运行一下看看,在mySpider目录下执行:
scrapy crawl itcast
是的,就是 itcast,看上面代码,它是 ItcastSpider 类的 name 属性,也就是使用 scrapy genspider命令的唯一爬虫名。
运行之后,如果打印的日志出现 [scrapy] INFO: Spider closed (finished),代表执行完成。 之后当前文件夹中就出现了一个 teacher.html 文件,里面就是我们刚刚要爬取的网页的全部源代码信息。
# 注意,Python2.x默认编码环境是ASCII,当和取回的数据编码格式不一致时,可能会造成乱码;

# 我们可以指定保存内容的编码格式,一般情况下,我们可以在代码最上方添加:

    import sys

    reload(sys)

    sys.setdefaultencoding("utf-8")

# 这三行代码是Python2.x里解决中文编码的万能钥匙,经过这么多年的吐槽后Python3学乖了,默认编码是Unicode了...(祝大家早日拥抱Python3)
2. 取数据
- 爬取整个网页完毕,接下来的就是的取过程了,首先观察页面源码:
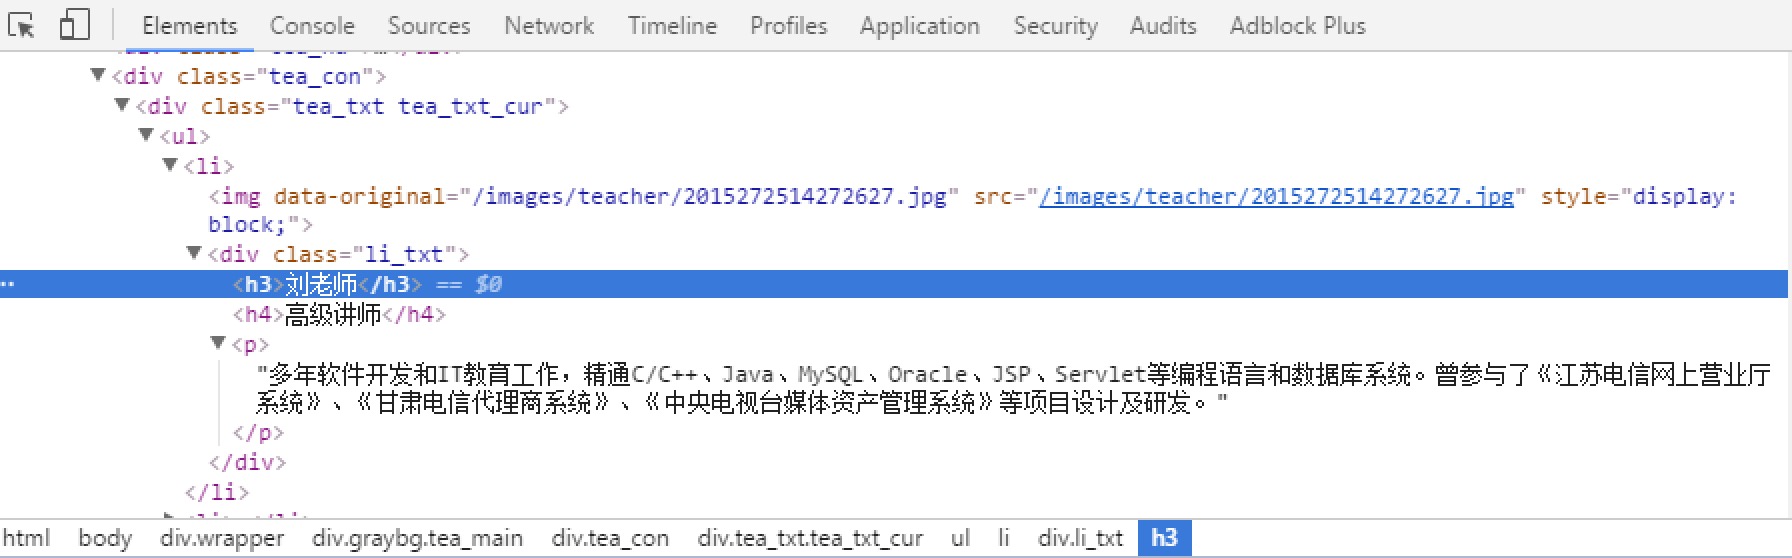
<div class="li_txt">

    <h3>  xxx  </h3>

    <h4> xxxxx </h4>

    <p> xxxxxxxx </p>
是不是一目了然?直接上XPath开始提取数据吧。
- 我们之前在mySpider/items.py 里定义了一个ItcastItem类。 这里引入进来
from mySpider.items import ItcastItem
- 然后将我们得到的数据封装到一个
ItcastItem对象中,可以保存每个老师的属性:
from mySpider.items import ItcastItem

def parse(self, response):

    #open("teacher.html","wb").write(response.body).close()

    # 存放老师信息的集合

    items = []

    for each in response.xpath("//div[@class='li_txt']"):

        # 将我们得到的数据封装到一个 `ItcastItem` 对象

        item = ItcastItem()

        #extract()方法返回的都是unicode字符串

        name = each.xpath("h3/text()").extract()

        title = each.xpath("h4/text()").extract()

        info = each.xpath("p/text()").extract()

        #xpath返回的是包含一个元素的列表

        item['name'] = name[0]

        item['title'] = title[0]

        item['info'] = info[0]

        items.append(item)

    # 直接返回最后数据

    return items
- 我们暂时先不处理管道,后面会详细介绍。
保存数据
scrapy保存信息的最简单的方法主要有四种,-o 输出指定格式的文件,,命令如下:
# json格式,默认为Unicode编码

scrapy crawl itcast -o teachers.json

# json lines格式,默认为Unicode编码

scrapy crawl itcast -o teachers.jsonl

# csv 逗号表达式,可用Excel打开

scrapy crawl itcast -o teachers.csv

# xml格式

scrapy crawl itcast -o teachers.xml
思考
如果将代码改成下面形式,结果完全一样。
请思考 yield 在这里的作用:
from mySpider.items import ItcastItem

def parse(self, response):

    #open("teacher.html","wb").write(response.body).close()

    # 存放老师信息的集合

    #items = []

    for each in response.xpath("//div[@class='li_txt']"):

        # 将我们得到的数据封装到一个 `ItcastItem` 对象

        item = ItcastItem()

        #extract()方法返回的都是unicode字符串

        name = each.xpath("h3/text()").extract()

        title = each.xpath("h4/text()").extract()

        info = each.xpath("p/text()").extract()

        #xpath返回的是包含一个元素的列表

        item['name'] = name[0]

        item['title'] = title[0]

        item['info'] = info[0]

        #items.append(item)

        #将获取的数据交给pipelines

        yield item

    # 返回数据,不经过pipeline

    #return items
scrapy框架系列 (2) 一个简单案例的更多相关文章
- Spring框架系列(2) - Spring简单例子引入Spring要点
上文中我们简单介绍了Spring和Spring Framework的组件,那么这些Spring Framework组件是如何配合工作的呢?本文主要承接上文,向你展示Spring Framework组件 ...
- ROS与Matlab系列:一个简单的运动控制
ROS与Matlab系列:一个简单的运动控制 转自:http://blog.exbot.net/archives/2594 Matlab拥有强大的数据处理.可视化绘图能力以及众多成熟的算法函数,非常适 ...
- MUI框架-05-用MUI做一个简单App
MUI框架-05-用MUI做一个简单App MUI 是一个前端框架,前端框架就像 Bootstrap,EasyUI,Vue ,为了做 app 呢,就有了更加高效的 MUI,我觉得前端框架有很多,也没有 ...
- Python爬虫从入门到放弃(十一)之 Scrapy框架整体的一个了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
- 从一个简单案例上手Spring MVC,同时分析Spring MVC面试问题
很多公司都会用Spring MVC,而且初级程序员在面试时,一定会被问到这方面的问题,所以这里我们来通过一个简单的案例来分析Spring MVC,事实上,我们在培训中就用这个举例,很多零基础的程序员能 ...
- Eclipse搭建Struts框架,及一个简单的Struts例子
一.下载struts2.0.1 http://struts.apache.org/downloads.html,下载struts-2.0.1-all.zip,这个压缩包中包含了开发struts2所需的 ...
- 自己动手系列——实现一个简单的ArrayList
ArrayList是Java集合框架中一个经典的实现类.他比起常用的数组而言,明显的优点在于,可以随意的添加和删除元素而不需考虑数组的大小.处于练手的目的,实现一个简单的ArrayList,并且把实现 ...
- scrapy框架系列 (1) 初识scrapy
Scrapy 框架 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页 ...
- 企业级任务调度框架Quartz(3) 一个简单的Quartz 例子
1. 一个简单的Quartz 工程 本示例应用比起众所周知的 System.out.println("Hello world from Quartz") 来还是要有趣些.当 ...
随机推荐
- 命名和目录接口 JNDI-The Java Naming and Directory Interface
命名和目录接口 JNDI-The Java Naming and Directory Interface JNDI (The Java Naming and Directory Interface)为 ...
- 多线程学习笔记七之信号量Semaphore
目录 简介 数据结构 示例 实现分析 构造方法 信号量的获取(公平方式) 信号量的释放(公平方式) nonfairTryAcquireShared(int acquires) 总结 简介 Sema ...
- UG中STP203和STP214的区别
UG转档STP203,STP214的区别:STP214转出的图档将保留原图属性,例如所在图层,曲面颜色,装配组件名称等.STP203没有上述功能.
- Luogu1445 [Violet]樱花 ---- 数论优化
Luogu1445 [Violet]樱花 一句话题意:(本来就是一句话的) 求方程 $\frac{1}{X} + \frac{1}{Y} = \frac{1}{N!}$ 的正整数解的组数,其中$N \ ...
- Ⅳ.Catalan数
Catalan数首先是由Euler在精确计算对凸n边形的不同的对角三角形剖分的个数问题时得到的,它经常出现在组合计数问题中. 问题的提出:在一个凸n边形中,通过不相交于n边形内部的对角线,把n ...
- zoj 3662 第37届ACM/ICPC长春赛区H题(DP)
题目:给出K个数,使得这K个数的和为N,LCM为M,问有多少种 f[i][j][k]表示选i个数,总和为j,最小公倍数为k memery卡的比较紧,注意不要开太大,按照题目数据开 这种类型的dp也是第 ...
- ORA-01591 锁定已被有问题的分配事务处理--解决方法(转)
转载自love wife & love life —Roger 的Oracle技术博客 本文链接地址: ORA-01591: lock held by in-doubt distributed ...
- [原创]Linux下网络性能测试Netperf工具介绍及安装
[原创]Linux下网络性能测试Netperf工具介绍及安装 1 官方网站 http://www.netperf.org/netperf/ 2 Netperf介绍 Netperf是一种网络性能的测试工 ...
- kaleidoscope-llvm
http://kaleidoscope-llvm-tutorial-zh-cn.readthedocs.io/zh_CN/latest/chapter-1.html
- java容器类---概述
1.容器类关系图 虚线框表示接口. 实线框表示实体类. 粗线框表示最经常使用的实体类. 点线的箭头表示实现了这个接口. 实线箭头表示类能够制造箭头所指的那个类的对象. Java集合工具包位于Java. ...