
入门大数据---Map/Reduce,Yarn是什么?
简单概括:Map/Reduce是分布式离线处理的一个框架。 Yarn是Map/Reduce中的一个资源管理器。
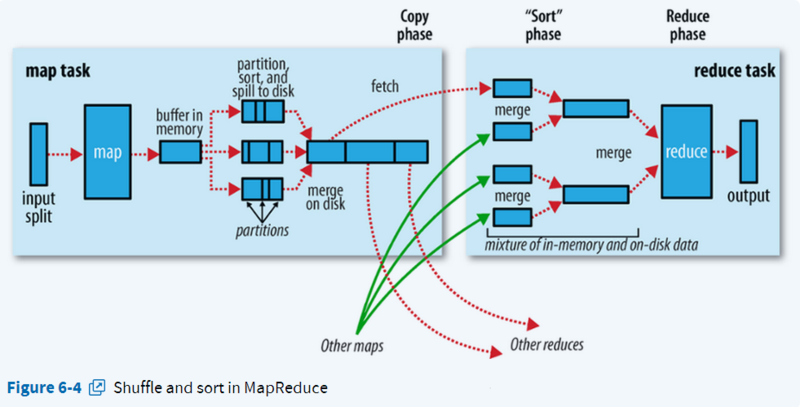
一.图形说明下Map/Reduce结构:
官方示意图:
另外还可以参考这个:
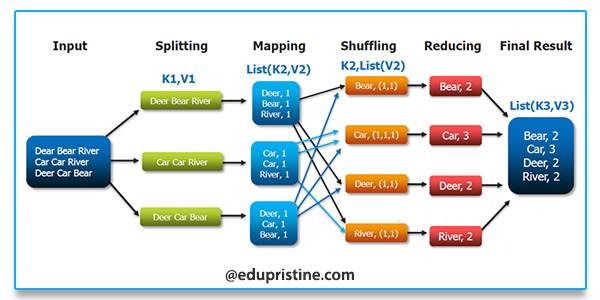
流程介绍:
HDFS首先会把块进行逻辑上切片处理,然后进行Map映射。一个切片对应一个Map映射。
因为文件内容有可能一个单词被切到两个文件里面,这样计算就会有问题,所以Map映射时除了第一个切片完全映射,其余的映射都会从第二行开始映射,而第一行传递给上一个Map处理。
Map程序初始化会设定一个阈值,比如80%,当超过这个值的时候就会就会进行内存溢出。溢出前会进行一个【快速排序】,排完后写入硬盘分区。(不设置阈值,当内存满后,就会阻塞数据继续写入。设定的阈值根据实际情况设定,太小了会增加读写压力,太大了会产生阻塞。)
程序可以设置合并操作,当分区数超过设定值后就进行合并(combiner)。(比如分区>3后)(合并后,相同key的数据就压缩了,拉取的时候就会减少IO)
Reduce会检查是否Map完,有一个Map完后就能拉取一次。
Reduce拉取的时候会有一个真迭代器和一个假迭代器进行嵌套,比如一组数据 A 1 A 1 A 1 B 1,假迭代器会进行循环然后取下一条数据进行比较看是否相同,相同的话进行累加值,再取下一条,这样下一条下一条的取,直到key不相同时候,结束本组循环,进行下一组循环。 这样A就统计出3,B就统计出1来了。
二.图形说明下Yarn的结构:
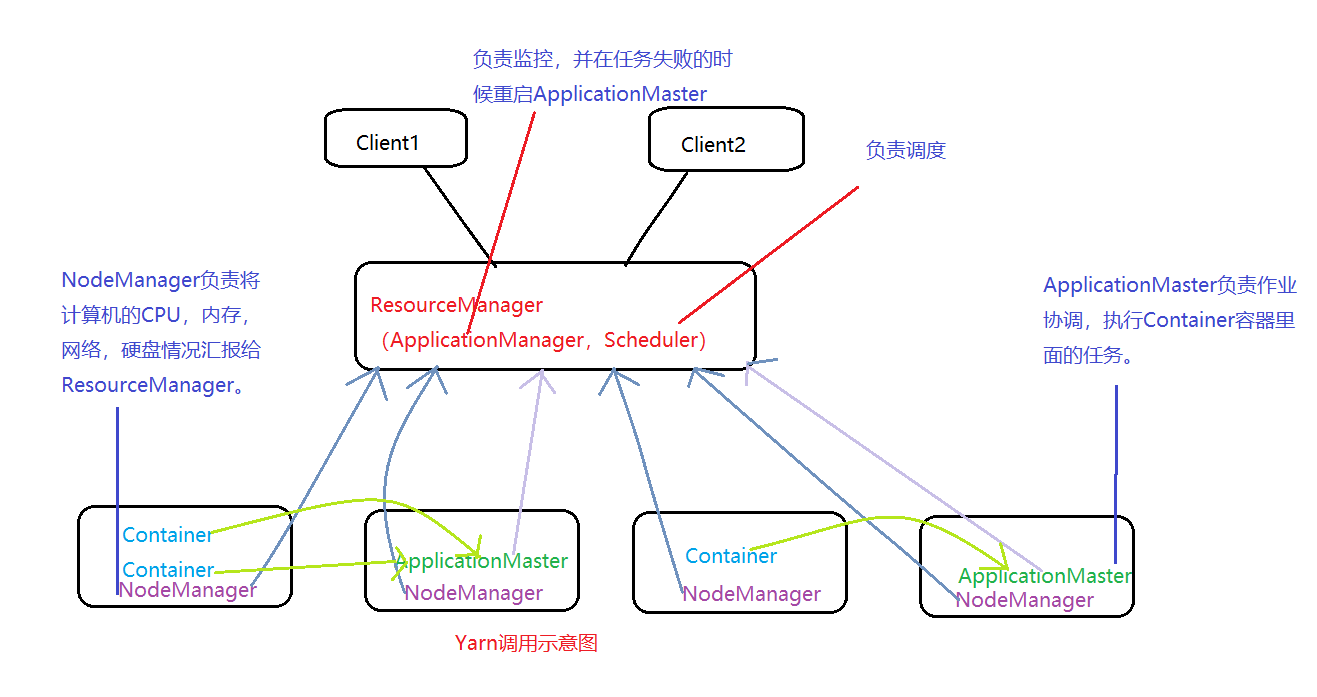
流程介绍:首先Client请求ResourceManager,然后ResourceManager分配一个Container启动ApplicationMaster,ApplicatoinMaster向ResourceManager请求分配更多Container。Container一部分执行Map任务,一部分执行Reduce任务。
三.图形说明下Map/Reduce和Yarn在整个Hadoop系统中的位置以及为什么产生Yarn:
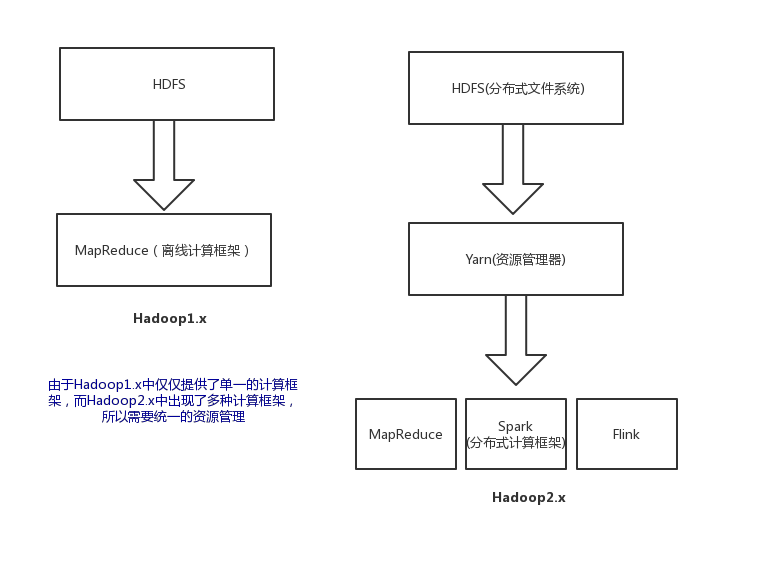
由于产生了多种计算框架,所以需要一个资源管理器来对资源进行分配使用。
系列传送门 学习官网: http://hadoop.apache.org/
入门大数据---Map/Reduce,Yarn是什么?的更多相关文章
- 大数据篇:YARN
YARN YARN是什么? YARN是一种新的 Hadoop 资源管理器,它是一个通用资源管理系统,可为上层应用提供统一的资源管理和调度,它的引入为集群在利用率.资源统一管理和数据共享等方面带来了巨大 ...
- 入门大数据---Flink学习总括
第一节 初识 Flink 在数据激增的时代,催生出了一批计算框架.最早期比较流行的有MapReduce,然后有Spark,直到现在越来越多的公司采用Flink处理.Flink相对前两个框架真正做到了高 ...
- 入门大数据---MapReduce-API操作
一.环境 Hadoop部署环境: Centos3.10.0-327.el7.x86_64 Hadoop2.6.5 Java1.8.0_221 代码运行环境: Windows 10 Hadoop 2.6 ...
- 入门大数据---Hive数据查询详解
一.数据准备 为了演示查询操作,这里需要预先创建三张表,并加载测试数据. 数据文件 emp.txt 和 dept.txt 可以从本仓库的resources 目录下载. 1.1 员工表 -- 建表语句 ...
- 入门大数据---Spark_Streaming整合Flume
一.简介 Apache Flume 是一个分布式,高可用的数据收集系统,可以从不同的数据源收集数据,经过聚合后发送到分布式计算框架或者存储系统中.Spark Straming 提供了以下两种方式用于 ...
- 入门大数据---通过Flume、Sqoop分析日志
一.Flume安装 参考:Flume 简介及基本使用 二.Sqoop安装 参考:Sqoop简介与安装 三.Flume和Sqoop结合使用案例 日志分析系统整体架构图: 3.1配置nginx环境 请参考 ...
- 入门大数据---安装ClouderaManager,CDH和Impala,Hue,oozie等服务
1.要求和支持的版本 (PS:我使用的环境,都用加粗标识了.) 1.1 支持的操作系统版本 操作系统 版本 RHEL/CentOS/OL with RHCK kernel 7.6, 7.5, 7.4, ...
- 入门大数据---SparkSQL外部数据源
一.简介 1.1 多数据源支持 Spark 支持以下六个核心数据源,同时 Spark 社区还提供了多达上百种数据源的读取方式,能够满足绝大部分使用场景. CSV JSON Parquet ORC JD ...
- 入门大数据---Hadoop是什么?
简单概括:Hadoop是由Apache组织使用Java语言开发的一款应对大数据存储和计算的分布式开源框架. Hadoop的起源 2003-2004年,Google公布了部分GFS和MapReduce思 ...
随机推荐
- 资源在windows编程中的应用----菜单
资源在Windows编程中的应用 资源 加速键.位图.光标.对话框.菜单.字符串.工具条 1.菜单的创建 菜单由以下组成部分: (1)窗口主菜单条 (2)下拉式菜单框 (3)菜单项热键标识 (4)菜单 ...
- Rocket - util - Counters
https://mp.weixin.qq.com/s/q7R2Dn9p9cch_ABN4raReQ 介绍几种计数器的实现,以及其中的一点小细节. 1. ZCounter ...
- DataGuard VS Beedup & GoldenGate灾备方案参数对比
世上本无完美产品,只有合适的才是最好的! 用户重视灾备数据站点的建设,毋庸置疑必备品.如果考虑带宽及事务完整性保证,存储灾备和操作系统级灾备局限性显而易见. 商用价值一般用于解决数据库自带辅助功能的短 ...
- IDEA字节码学习查看神器jclasslib bytecode viewer介绍
转载来自:https://blog.csdn.net/w605283073/article/details/103209221 一.背景 很多人想学习Java反汇编后的字节码,但是一方面缺乏好的资料, ...
- java方法句柄-----4.你所不知道的MethodHandle【翻译】
Method Handles in Java 1.介绍 在本文中,我们将探讨一个重要的API,它是在Java 7中引入的,并在Java 7版本之后更加完善:全限定名是:Java.lang.invoke ...
- Java实现 LeetCode 98 验证二叉搜索树
98. 验证二叉搜索树 给定一个二叉树,判断其是否是一个有效的二叉搜索树. 假设一个二叉搜索树具有如下特征: 节点的左子树只包含小于当前节点的数. 节点的右子树只包含大于当前节点的数. 所有左子树和右 ...
- java实现哈密顿回路问题
1 问题描述 什么是哈密顿回路? 引用自百度百科: 哈密顿图(哈密尔顿图)(英语:Hamiltonian path,或Traceable path)是一个无向图,由天文学家哈密顿提出,由指定的起点前往 ...
- python IDE pycharm的安装与使用
Python开发最牛逼的IDE——pycharm (其实其它的工具,例如eclipse也可以写,只不过比较麻烦,需要安装很多的插件,所以说pycharm是最牛逼的) pycharm,下载专业版的,不要 ...
- 【Java Spring Cloud 实战之路】添加一个SpringBootAdmin监控
0. 前言 在之前的几章中,我们先搭建了一个项目骨架,又搭建了一个使用nacos的gateway网关项目,网关项目中并没有配置太多的东西.现在我们就接着搭建在Spring Cloud 微服务中另一个重 ...
- List集合排序的方法
1.list集合中的对象实现Comparable接口 public class User implements Comparable<User>{ private Integer id; ...