
Spark的安装及其配置
1.Spark下载
https://archive.apache.org/dist/spark/
2.上传解压,配置环境变量 配置bin目录
解压:tar -zxvf spark-2.4.5-bin-hadoop2.7.tgz -C /usr/local/soft/
改名:mv spark-2.4.5-bin-hadoop2.7/ spark-2.4.5
配置环境变量:vim /etc/profile
添加环境变量:
export SPARK_HOME=/usr/local/soft/spark-2.4.5
export PATH=$PATH:$SPARK_HOME/bin
保存配置:source /etc/profile
3.修改配置文件 conf
修改spark-env.sh: cp spark-env.sh.template spark-env.sh
增加配置:
export SPARK_MASTER_IP=master
export SPARK_MASTER_PORT=7077
export SPARK_WORKER_CORES=2
export SPARK_WORKER_INSTANCES=1
export SPARK_WORKER_MEMORY=2g
export JAVA_HOME=/usr/local/soft/jdk1.8.0_171
修改:cp slaves.template slaves
增加:
node1
node2
4.发放到其他节点
xsync spark-2.4.5
(xsync是自己写的脚本,在安装Hadoop的时候写过)
4、在主节点执行启动命令
启动集群,在master中执行
./sbin/start-all.sh

http://master:8080/ 访问spark ui

5.检验安装的Spark
1. standalone client模式 日志在本地输出,一班用于上线前测试(bin/下执行)
需要进入到spark-examples_2.11-2.4.5.jar 包所在的目录下执行
cd /usr/local/soft/spark-2.4.5/examples/jars
spark-submit --class org.apache.spark.examples.SparkPi --master spark://master:7077 --executor-memory 512m --total-executor-cores 1 spark-examples_2.11-2.4.5.jar 100
2. standalone cluster模式 上线使用,不会再本地打印日志
spark-submit --class org.apache.spark.examples.SparkPi --master spark://master:7077 --driver-memory 512m --deploy-mode cluster --supervise --executor-memory 512M --total-executor-cores 1 spark-examples_2.11-2.4.5.jar 100
spark-shell spark 提供的一个交互式的命令行,可以直接写代码

spark-shell master spark://master:7077
6.整合yarn
在公司一般不适用standalone模式,因为公司一般已经有yarn 不需要搞两个资源管理框架
停止spark集群
在spark sbin目录下执行 ./stop-all.sh
spark整合yarn只需要在一个节点整合, 可以删除node1 和node2中所有的spark 文件
1、增加hadoop 配置文件地址
vim spark-env.sh
增加
export HADOOP_CONF_DIR=/usr/local/soft/hadoop-2.7.6/etc/hadoop
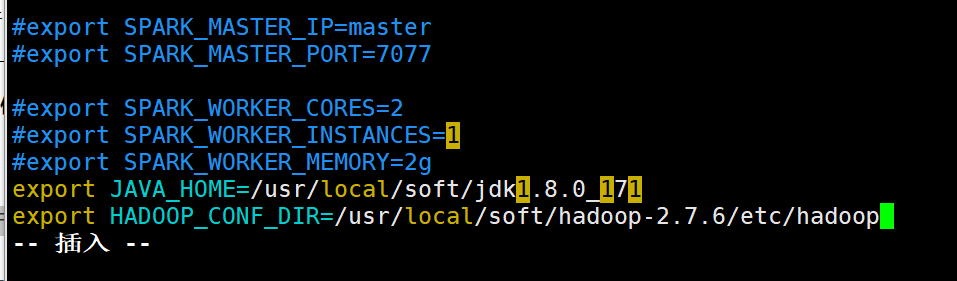
2、往yarn提交任务需要增加两个配置 yarn-site.xml(/usr/local/soft/hadoop-2.7.6/etc/hadoop/yarn-site.xml)
先关闭yarn
stop-yarn.sh
<property>
<name>yarn.nodemanager.pmem-check-enabled</name>
<value>false</value>
</property>
<property>
<name>yarn.nodemanager.vmem-check-enabled</name>
<value>false</value>
</property>
4、同步到其他节点,重启yarn
scp -r yarn-site.xml node1:`pwd`
scp -r yarn-site.xml node2:`pwd`
启动yarn
start-yarn.sh
cd /usr/local/soft/spark-2.4.5/examples/jars
3.spark on yarn client模式 日志在本地输出,一班用于上线前测试
spark-submit --class org.apache.spark.examples.SparkPi --master yarn-client --executor-memory 512M --num-executors 2 spark-examples_2.11-2.4.5.jar 100
4.spark on yarn cluster模式 上线使用,不会再本地打印日志 减少io
spark-submit --class org.apache.spark.examples.SparkPi --master yarn-cluster --executor-memory 512m --num-executors 2 --executor-cores 1 spark-examples_2.11-2.4.5.jar 100
获取yarn程序执行日志 执行成功之后才能获取到
yarn logs -applicationId application_1560967444524_0003
hdfs webui
http://node1:50070
yarn ui
http://node1:8088
在idea中使用spark做wordCount
import org.apache.spark.rdd.RDD

import org.apache.spark.{SparkConf, SparkContext}

object Demo1WordCount {

  def main(args: Array[String]): Unit = {

    // Spark配置文件对象

    val conf: SparkConf = new SparkConf()

    // 设置Spark程序的名字

    conf.setAppName("Demo1WordCount")

    // 设置运行模式为local模式 即在idea本地运行

    conf.setMaster("local")

    // Spark的上下文环境,相当于Spark的入口

    val sc: SparkContext = new SparkContext(conf)

    // 词频统计

    // 1、读取文件

    /**

     * RDD : 弹性分布式数据集(可以先当成scala中的集合去使用)

     */

    val linesRDD: RDD[String] = sc.textFile("spark/data/words")

    // 2、将每一行的单词切分出来

    // flatMap: 在Spark中称为 算子

    // 算子一般情况下都会返回另外一个新的RDD

    val wordsRDD: RDD[String] = linesRDD.flatMap(line => line.split(","))

    // 3、按照单词分组

    val groupRDD: RDD[(String, Iterable[String])] = wordsRDD.groupBy(word => word)

    // 4、统计每个单词的数量

    val countRDD: RDD[String] = groupRDD.map(kv => {

      val word: String = kv._1

      val words: Iterable[String] = kv._2

      // words.size直接获取迭代器的大小

      // 因为相同分组的所有的单词都会到迭代器中

      // 所以迭代器的大小就是单词的数量

      word + "," + words.size

    })

    // 5、将结果进行保存

    countRDD.saveAsTextFile("spark/data/wordCount")

  }

}
Spark的安装及其配置的更多相关文章
- Spark的安装及配置
title: Spark的安装及配置 summary: 关键词:Hadoop集群环境 Spark scala python ubuntu 安装和配置 date: 2019-5-19 13:56 aut ...
- Mac OSX系统中Hadoop / Hive 与 spark 的安装与配置 环境搭建 记录
Mac OSX系统中Hadoop / Hive 与 spark 的安装与配置 环境搭建 记录 Hadoop 2.6 的安装与配置(伪分布式) 下载并解压缩 配置 .bash_profile : ...
- Spark standlone安装与配置
spark的安装简单,去官网下载与集群hadoop版本相一致的文件即可. 解压后,主要需要修改spark-evn.sh文件. 以spark standlone为例,配置dn1,nn2为master,使 ...
- Spark(三): 安装与配置
参见 HDP2.4安装(五):集群及组件安装 ,安装配置的spark版本为1.6, 在已安装HBase.hadoop集群的基础上通过 ambari 自动安装Spark集群,基于hadoop yarn ...
- spark安装及配置
windows下spark的安装与配置教程 Windows下安装spark windows下搭建spark环境出现ChangeFileModeByMask error (3): ??????????? ...
- spark HA 安装配置和使用(spark1.2-cdh5.3)
安装环境如下: 操作系统:CentOs 6.6 Hadoop 版本:CDH-5.3.0 Spark 版本:1.2 集群5个节点 node01~05 node01~03 为worker. node04. ...
- Spark安装和配置
hadoop2的安装教程 Spark可以直接安装在hadoop2上面,主要是安装在hadoop2的yarn框架上面 安装Spark之前需要在每台机器上安装Scala,根据你下载的Spark版本,选择对 ...
- 01、Spark安装与配置
01.Spark安装与配置 1.hadoop回顾 Hadoop是分布式计算引擎,含有四大模块,common.hdfs.mapreduce和yarn. 2.并发和并行 并发通常指针对单个节点的应对多个请 ...
- Spark集群安装与配置
一.Scala安装 1.https://www.scala-lang.org/download/2.11.12.html下载并复制到/home/jun下解压 [jun@master ~]$ cd sc ...
随机推荐
- [源码解析] PyTorch 流水线并行实现 (2)--如何划分模型
[源码解析] PyTorch 流水线并行实现 (2)--如何划分模型 目录 [源码解析] PyTorch 流水线并行实现 (2)--如何划分模型 0x00 摘要 0x01 问题 0x01 自动平衡 1 ...
- vue-cli3 取消eslint 校验代码
项目生成后会有个.eslintrc.js文件 module.exports = { root: true, env: { node: true }, 'extends': [ 'plugin:vue/ ...
- 案例分享 | dubbo 2.7.12 bug导致线上故障
本文已收录 https://github.com/lkxiaolou/lkxiaolou 欢迎star.搜索关注微信公众号"捉虫大师",后端技术分享,架构设计.性能优化.源码阅读. ...
- centos 关于yum无法使用
一.网络问题 1.1 ping # 确认网络是否可以ping通, 通则不是网络问题(跳过), 不通则是网络问题(往下操作) ping www.baidu.com 1.2 检查网络模式 1.关闭虚拟机 ...
- SpringSecurity系列学习(一):初识SpringSecurity
SpringSecurity Spring Security是spring采用AOP思想,基于servlet过滤器实现的安全框架.它提供了完善的认证机制和方法级的 授权功能.是一款非常优秀的权限管理框 ...
- P3291-[SCOI2016]妖怪【凸壳】
正题 题目链接:https://www.luogu.com.cn/problem/P3291 题目大意 给出 \(n\) 个数字对 \((atk,dnf)\),求一个\((a,b)\). 对于每个数字 ...
- P4859-已经没有什么好害怕的了【容斥,dp】
正题 题目链接:https://www.luogu.com.cn/problem/P4859 题目大意 两个长度为\(n\)的序列\(a,b\)两两匹配,求\(a_i>b_i\)的组数比\(a_ ...
- 关于mysql基础
早就想把自己的数据库基础巩固一下,然而一直没有时间,今天终于抽出时间对mysql数据库基础进行了学习与扩展. mysql与其他数据库的区别 Sqlite: 开源免费,体积小,单文件,没有进程.磁盘读性 ...
- 在开源项目或项目中使用git建立fork仓库
前言: vector我们经常使用,对vector里面的基本函数构造函数.增加函数.删除函数.遍历函数我们也会用到.其中在使用遍历之后erase删除元素过程中,会出现一种删除最后一个元素破坏了迭代器的情 ...
- Windows Terminal 美化教程
Windows Terminal 美化教程 1.安装Windows Terminal 在微软商店搜索Windows Terminal下载即可 2.安装相应的插件 使用管理员权限打开Windows Te ...