
Flink sql 之 两阶段聚合与 TwoStageOptimizedAggregateRule(源码分析)
本文源码基于flink1.14
上一篇文章分析了《flink的minibatch微批处理》的源码
乘热打铁分析一下两阶段聚合的源码,因为使用两阶段要先开启minibatch,至于为什么后面会分析到
两阶段聚合的原理,还是简单提一下
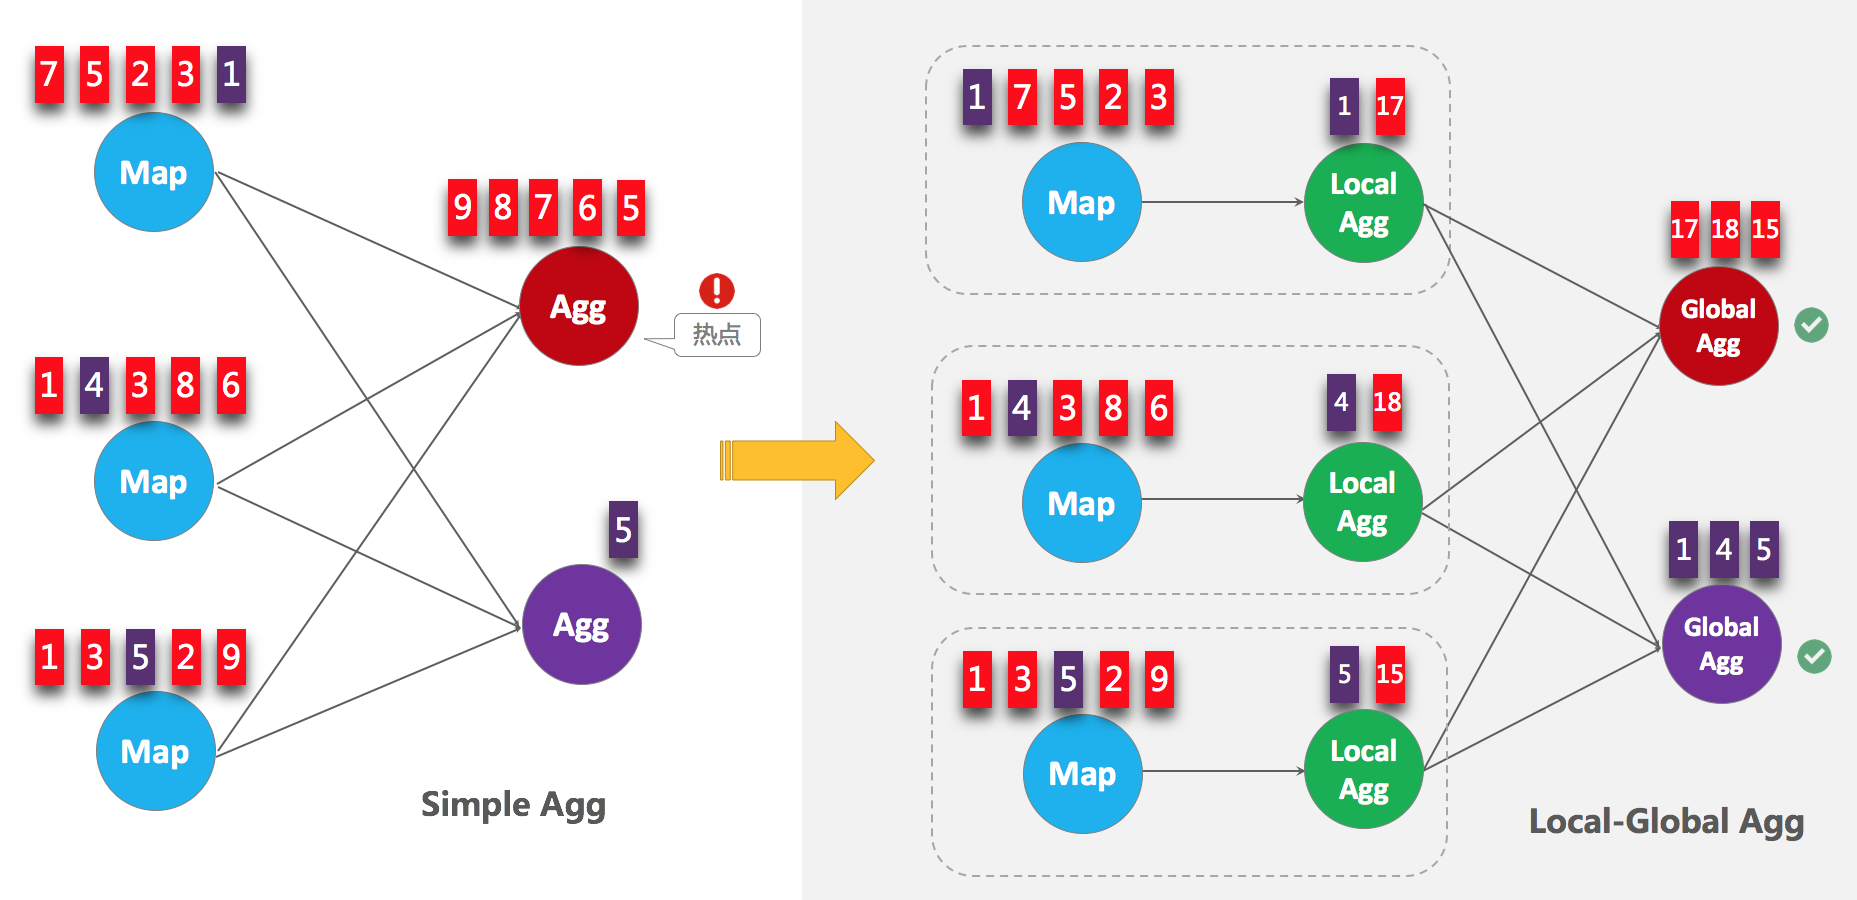
如下图,当聚合发生热点的时候,可以在聚合前,先进行一个本地的聚合,先减小数据量,后接正常的数据交换以后聚合,来达到一个解热点的目的,
先来看下两阶段聚合的Calcite优化rule

看下什么情况会匹配上

并且在onmatch方法中会判断开启了minibatch,以及二阶段聚合的时候会调用
来看下具体逻辑match方法
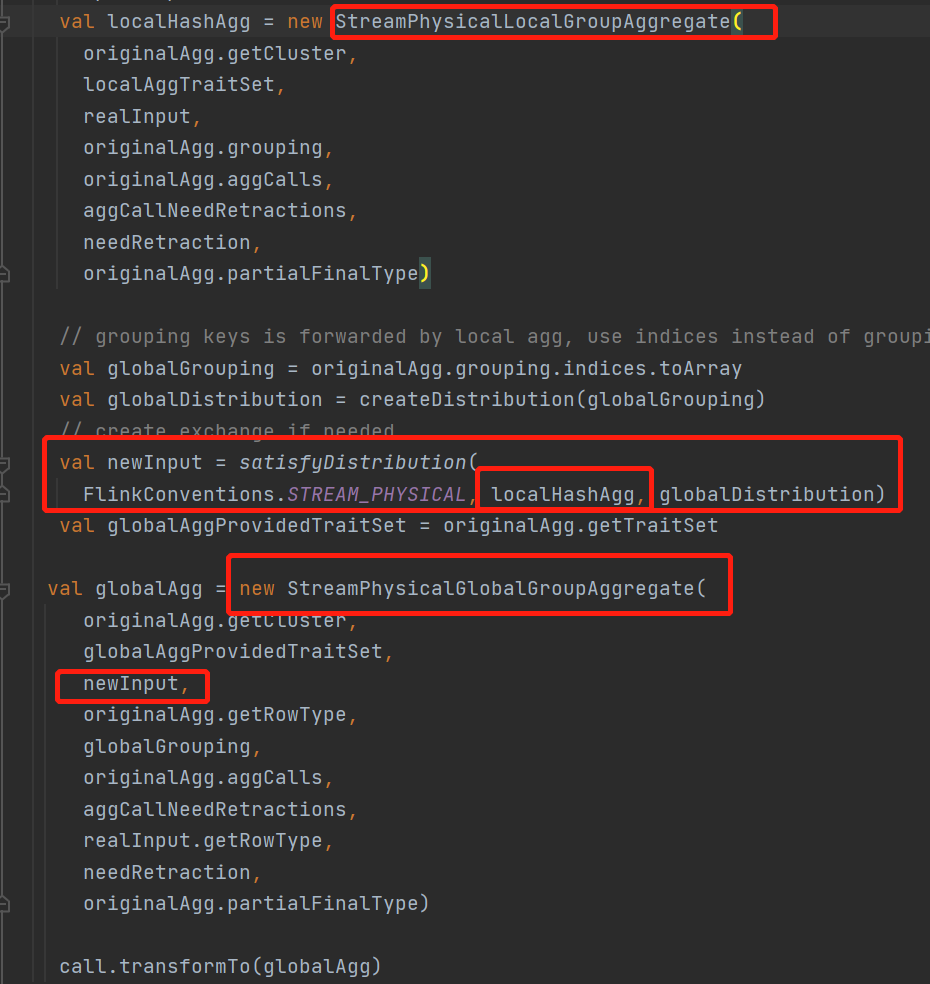
整个两阶段聚合会将原来的一个StreamPhysicalGroupAggregate物理节点,转换成一个
StreamPhysicalLocalGroupAggregate本地聚合节点 + StreamPhysicalGlobalGroupAggregate聚合节点
来看下这个新添加的StreamPhysicalLocalGroupAggregate本地聚合算子的计算逻辑是什么样子的
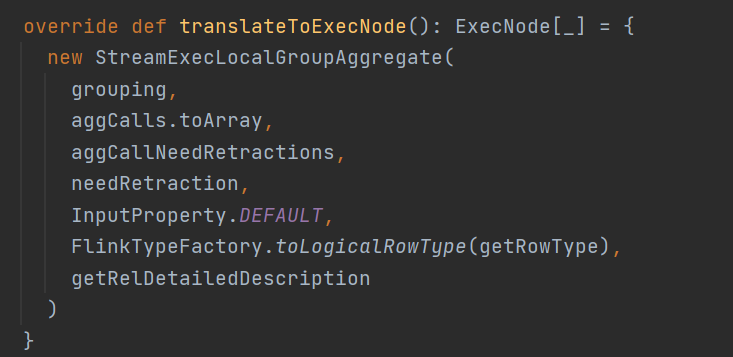
StreamExecLocalGroupAggragate就是StreamPhysicalLocalGroupAggregate本地聚合具体的ExecNode节点了
来看下具体的operator
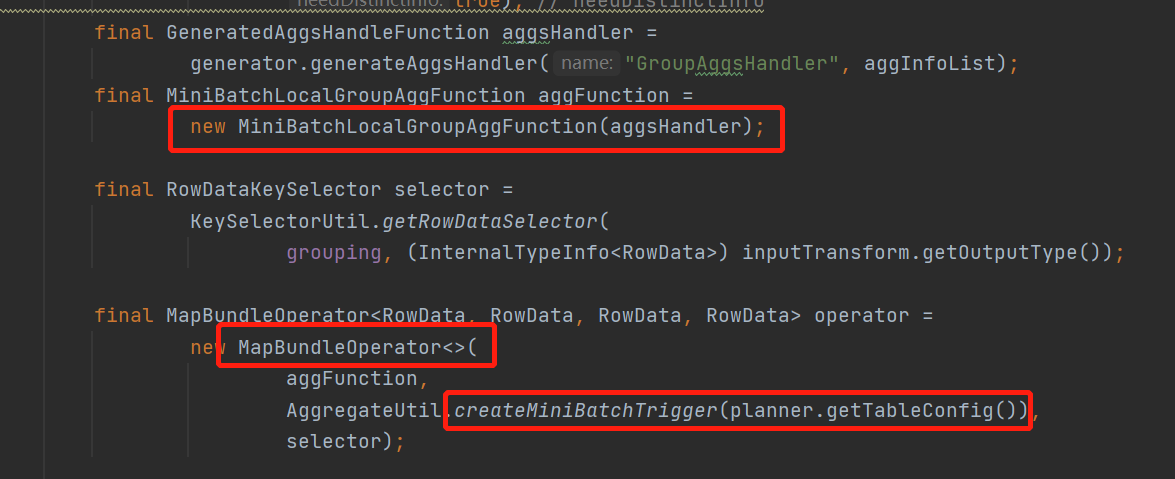
看到这里是不是看到了熟悉的 MapBundleOperator ,如果看过上一篇minibatch优化的就知道,两阶段提交也是使用的这个有界operator作为抽象
在了解一下这个MapBundleOperator
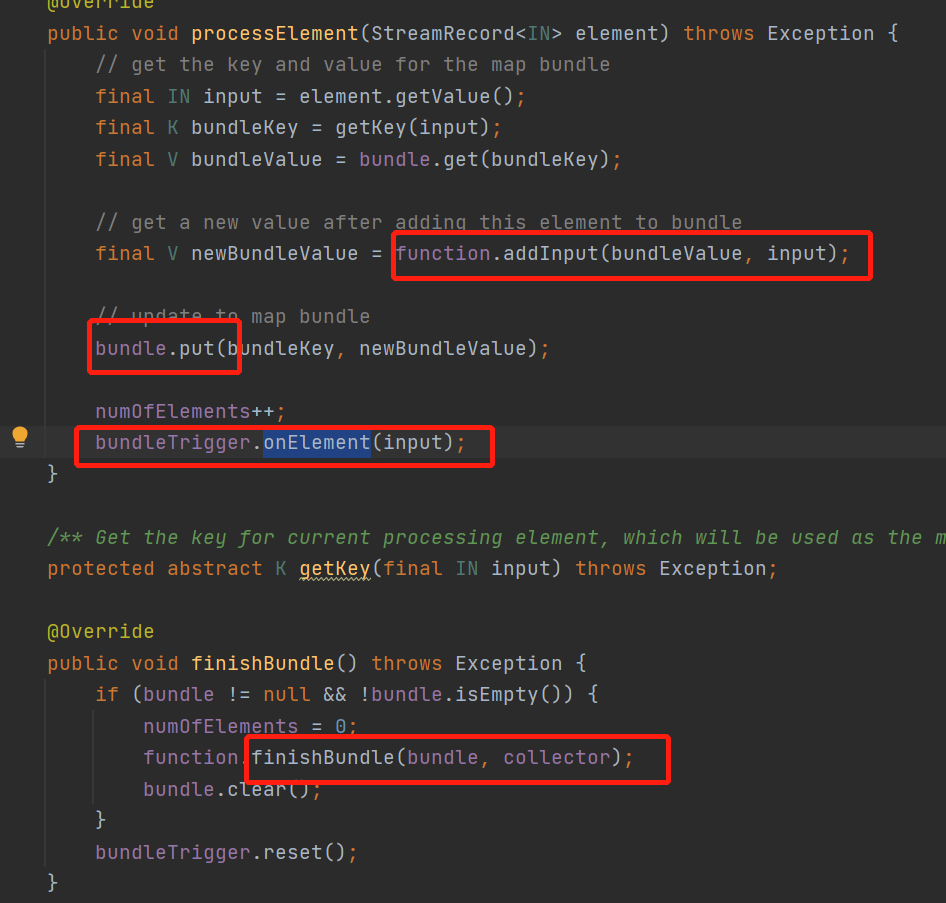
就是每来一条数据,都会调用传入的fun的addInput方法
然后把每个key的结果put保存在一个本地变量,就是个map<Rowdata,Rowdata>里面
然后调用自己的trigger触发器,当这条数据可以触发触发器就会调用finishBundle
这里说到触发器,回到初始化mapBundle的时候通过createMiniBatchTrigger创建的一个minibatch的触发器,看看具体逻辑
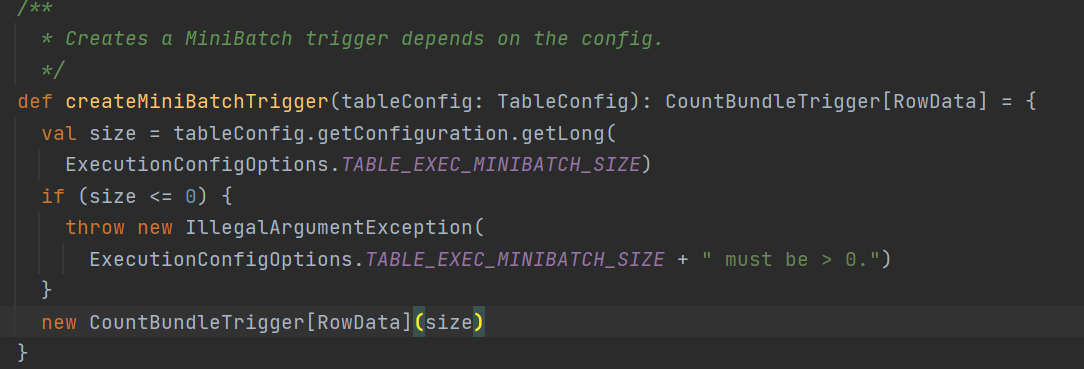
其实就是一个普通的count触发器,触发条件就是直接使用的minibatch配置的size参数, 所以这里知道了为什么两阶段提交要先开minibatch了
先看下每来一条数据会触发的addInput方法,在来看看攒一个批次后触发的finishBundle
minibatch会包装成一个MiniBatchLocalGroupAggFunction这个funtion的addInput来看看
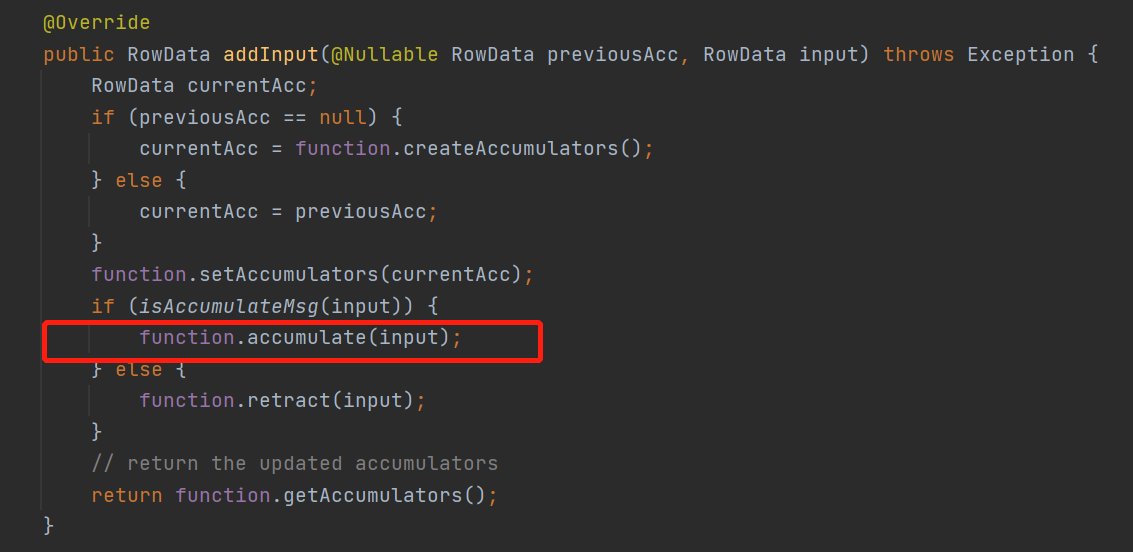
就是来一条数据直接调用聚合函数的accumulate直接计算结果了,虽然计算结果但是还没有往下游发送
来看下当攒一批后,集体是怎么往下游发送的 finishBundle 方法
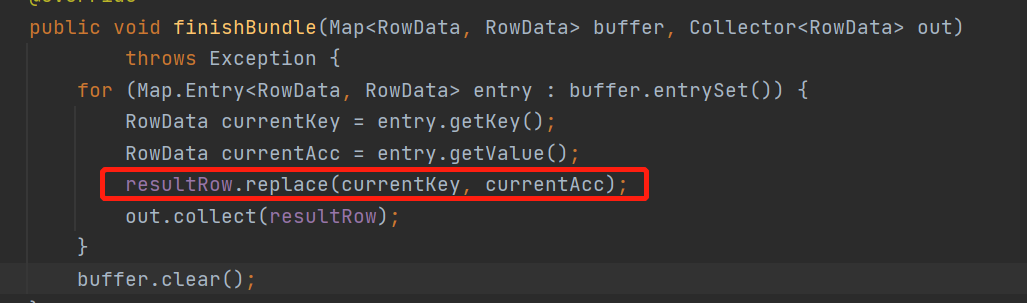
结果都已经计算好了,攒一个批次还能干嘛,就是把当前的计算结果往下游发送呗
那整个二次聚合的优化就讲完了
总结一下
sql会将agg拆成 localminiagg + agg
先在本地聚合localConbine一遍,再往下游发送
下游就正常聚合,优化了热点的问题
Flink sql 之 两阶段聚合与 TwoStageOptimizedAggregateRule(源码分析)的更多相关文章
- 从flink-example分析flink组件(3)WordCount 流式实战及源码分析
前面介绍了批量处理的WorkCount是如何执行的 <从flink-example分析flink组件(1)WordCount batch实战及源码分析> <从flink-exampl ...
- Flink Sql 之 Calcite Volcano优化器(源码解析)
Calcite作为大数据领域最常用的SQL解析引擎,支持Flink , hive, kylin , druid等大型项目的sql解析 同时想要深入研究Flink sql源码的话calcite也是必备 ...
- Flink 如何通过2PC实现Exactly-once语义 (源码分析)
Flink通过全局快照能保证内部处理的Exactly-once语义 但是端到端的Exactly-once还需要下游数据源配合,常见的通过幂等或者二阶段提交这两种方式保证 这里就来分析一下Sink二阶段 ...
- Flink中接收端反压以及Credit机制 (源码分析)
先上一张图整体了解Flink中的反压 可以看到每个task都会有自己对应的IG(inputgate)对接上游发送过来的数据和RS(resultPatation)对接往下游发送数据, 整个反压机制通 ...
- Flink中TaskManager端执行用户逻辑过程(源码分析)
TaskManager接收到来自JobManager的jobGraph转换得到的TDD对象,启动了任务,在StreamInputProcessor类的processInput()方法中 通过一个whi ...
- [源码分析] 带你梳理 Flink SQL / Table API内部执行流程
[源码分析] 带你梳理 Flink SQL / Table API内部执行流程 目录 [源码分析] 带你梳理 Flink SQL / Table API内部执行流程 0x00 摘要 0x01 Apac ...
- 鸿蒙内核源码分析(Shell编辑篇) | 两个任务,三个阶段 | 百篇博客分析OpenHarmony源码 | v71.01
子曰:"我非生而知之者,好古,敏以求之者也." <论语>:述而篇 百篇博客系列篇.本篇为: v71.xx 鸿蒙内核源码分析(Shell编辑篇) | 两个任务,三个阶段 ...
- [源码分析]从"UDF不应有状态" 切入来剖析Flink SQL代码生成 (修订版)
[源码分析]从"UDF不应有状态" 切入来剖析Flink SQL代码生成 (修订版) 目录 [源码分析]从"UDF不应有状态" 切入来剖析Flink SQL代码 ...
- Flink sql 之AsyncIO与LookupJoin的几个疑问 (源码分析)
本文源码基于flink 1.14 被同事问到几个关于AsyncIO和lookUp维表的问题所以翻了下源码,从源码的角度解惑这几个问题 对于AsyncIO不了解的可以看看之前写的这篇 <Flin ...
随机推荐
- SVN终端演练(个人开发\多人开发)
SVN终端演练(个人开发) ### 1. 命令格式 命令行格式: svn <subcommand> [options] [args] svn 子命令 [选项] [参数] ...
- 连接 MySQL 数据库出现问题:The server time zone value ‘�й���ʱ��‘ is unrecogni....
出现问题 The server time zone value '�й���ʱ��' is unrecogni.... 解决方案 在 URL 后面加上 ?serverTimezone=UTC 如下: ...
- 二、SpringBoot实现上传文件到fastDFS文件服务器
上篇文章介绍了如何使用docker安装fastDFS文件服务器,这一篇就介绍整合springBoot实现文件上传到fastDFS文件服务器 1.pom.xml文件添加依赖 <!-- 连接fast ...
- Spring Boot中注解@ConfigurationProperties
在Spring Boot中注解@ConfigurationProperties有三种使用场景,而通常情况下我们使用的最多的只是其中的一种场景.本篇文章带大家了解一下三种场景的使用情况. 场景一 使用@ ...
- Linux目录基础
一.解析映射文件 本地的DNS Linux: /etc/hosts Windows:C:\Windows\System32\drivers\etc\hosts 二.磁盘挂载文件 /etc/fstab ...
- [BUUCTF]PWN——[ZJCTF 2019]Login
[ZJCTF 2019]Login 附件 步骤: 例行检查,64位程序,开启了canary和nx保护 2. 试运行一下程序 3. 64位ida载入,检索字符串,在程序里找到了用户名admin和密码2j ...
- 解决Vulnhub靶机分配不到IP问题
没法找到他的 ip,可能是网卡配置问题 (之前打开 .ova 文件默认联网方式是桥接,改成NAT) 在开机选择的时候,摁 e 编辑一下 把 ro 改成 rw single init=/bin/bash ...
- 用 shell 脚本做自动化测试
前言 项目中有一个功能,需要监控本地文件系统的变更,例如文件的增.删.改名.文件数据变动等等.之前只在 windows 上有实现,采用的是 iocp + ReadDirectoryChanges 方案 ...
- CF1199B Water Lily 题解
Content 有一朵长在水中的莲花,其茎秆部分露出水面的高度为 \(h\).有人将它往右边拽了 \(l\) 米,使得整个茎秆部分都浸在水中.求池水的深度. 数据范围:\(1\leqslant h&l ...
- pycharm字体放大的设置
一.pycharm字体放大的设置 File -> setting -> Keymap ->在搜寻框中输入:increase -> Increase Font Size(双击) ...