
Python 爬虫入门实例(爬取小米应用商店的top应用apk)
一,爬虫是什么?
爬虫就是获取网络上各种资源,数据的一种工具。具体的可以自行百度。
二,如何写简单爬虫
1,获取网页内容
可以通过 Python(3.x) 自带的 urllib,来实现网页内容的下载。实现起来很简单
import urllib.request

url="http://www.baidu.com"

response=urllib.request.urlopen(url)

html_content=response.read()
还可以使用三方库 requests ,实现起来也非常方便,在使用之前当然你需要先安装这个库:pip install requests 即可(Python 3以后的pip非常好使)
import requests

html_content=requests.get(url).text
2, 解析网页内容
获取的网页内容html_content,其实就是html代码,我们需要对其进行解析,获取我们所需要的内容。
解析网页的方法有很多,这里我介绍的是BeautifullSoup,由于这是一个三方库,在使用前 还是要先安装 :pip install bs4
form bs4 imort BeautifullSoup

soup= BeautifullSoup(html_content, "html.parser")
更多使用方法请参考官方文档:http://beautifulsoup.readthedocs.io/zh_CN/latest/
三,实例分析
弄懂爬虫原理的最好办法,就是多分析一些实例,爬虫千变万化,万变不离其宗。废话少说上干货。
===================================我是分割线===================================================
需求:爬取小米应用商店的TOP n 应用
通过浏览器打开小米应用商店排行棒页面,F12审查元素
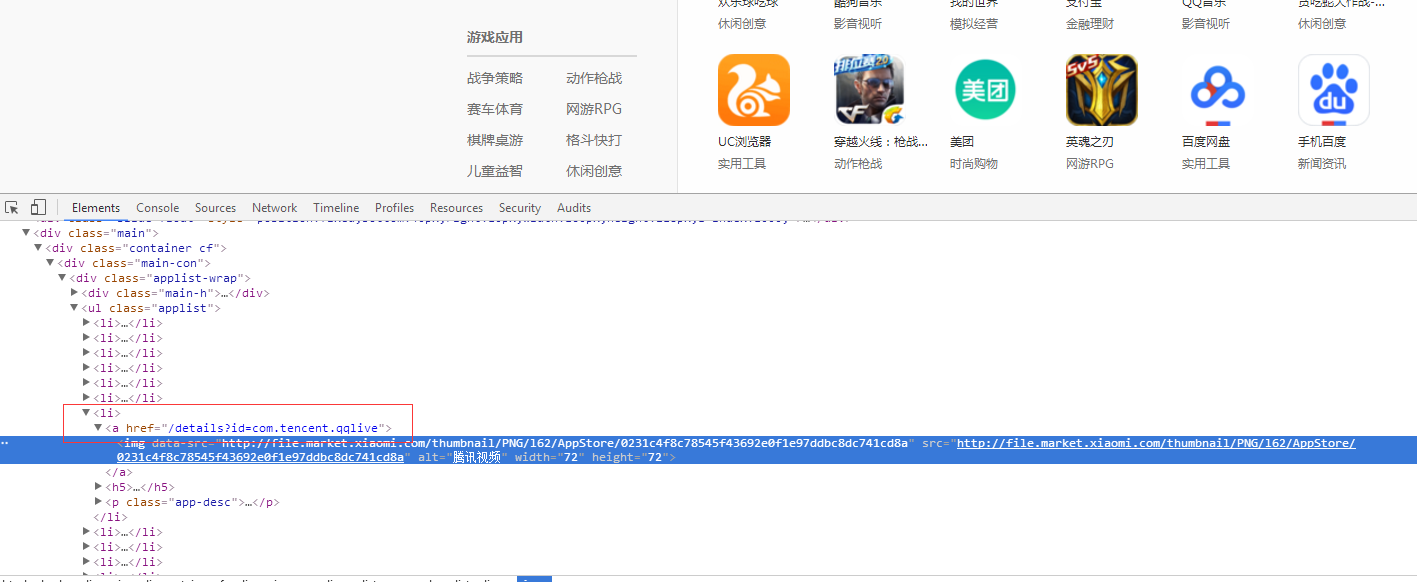
#coding=utf-8

import requests
import re

from bs4 import BeautifullSoup

def parser_apks(self, count=0):

        '''小米应用市场'''

     _root_url="http://app.mi.com" #应用市场主页网址

     res_parser={}

     page_num=1 #设置爬取的页面,从第一页开始爬取,第一页爬完爬取第二页,以此类推

     while count:
         #获取排行榜页面的网页内容

         wbdata = requests.get("http://app.mi.com/topList?page="+str(page_num)).text

            print("开始爬取第"+str(page_num)+"页")
            #解析页面内容获取 应用下载的 界面连接

            soup=BeautifulSoup(wbdata,"html.parser")

            links=soup.body.contents[3].find_all("a",href=re.compile("/details?"), class_ ="", alt="") #BeautifullSoup的具体用法请百度一下吧。。。

            for link in links:

                detail_link=urllib.parse.urljoin(_root_url, str(link["href"]))

                package_name=detail_link.split("=")[1]
                #在下载页面中获取 apk下载的地址

                download_page=requests.get(detail_link).text

                soup1=BeautifulSoup(download_page,"html.parser")

                download_link=soup1.find(class_="download")["href"]

                download_url=urllib.parse.urljoin(_root_url, str(download_link))
                #解析后会有重复的结果,下面通过判断去重

                if download_url not in res_parser.values():

                    res_parser[package_name]=download_url

                    count=count-1

                if count==0:

                    break

            if count >0:

                page_num=page_num+1

        print("爬取apk数量为: "+str(len(res_parser)))

        return res_parser
def craw_apks(self, count=1, save_path="d:\\apk\\"):

        res_dic=parser_apks(count)

        for apk in res_dic.keys():

            print("正在下载应用: "+apk)

            urllib.request.urlretrieve(res_dic[apk],save_path+apk+".apk")

            print("下载完成")
if __name__=="__main__":

    craw_apks(10)
运行结果:
开始爬取第1页

爬取apk数量为: 10

正在下载应用: com.tencent.tmgp.sgame
下载完成
.
.
.
以上就是简单爬虫的内容,其实爬虫的实现还是很复杂的,不同的网页有不同的解析方式,还需要深入学习。。。
Python 爬虫入门实例(爬取小米应用商店的top应用apk)的更多相关文章
- Python 爬虫入门之爬取妹子图
Python 爬虫入门之爬取妹子图 来源:李英杰 链接: https://segmentfault.com/a/1190000015798452 听说你写代码没动力?本文就给你动力,爬取妹子图.如果 ...
- Python 爬虫入门(二)——爬取妹子图
Python 爬虫入门 听说你写代码没动力?本文就给你动力,爬取妹子图.如果这也没动力那就没救了. GitHub 地址: https://github.com/injetlee/Python/blob ...
- Python 爬虫入门(一)——爬取糗百
爬取糗百内容 GitHub 代码地址https://github.com/injetlee/Python/blob/master/qiubai_crawer.py 微信公众号:[智能制造专栏],欢迎关 ...
- python 爬虫入门----案例爬取上海租房图片
前言 对于一个net开发这爬虫真真的以前没有写过.这段时间学习python爬虫,今天周末无聊写了一段代码爬取上海租房图片,其实很简短就是利用爬虫的第三方库Requests与BeautifulSoup. ...
- python 爬虫入门案例----爬取某站上海租房图片
前言 对于一个net开发这爬虫真真的以前没有写过.这段时间开始学习python爬虫,今天周末无聊写了一段代码爬取上海租房图片,其实很简短就是利用爬虫的第三方库Requests与BeautifulSou ...
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- python爬虫+正则表达式实例爬取豆瓣Top250的图片
直接上全部代码 新手上路代码风格可能不太好 import requests import re from fake_useragent import UserAgent #### 用来伪造爬头部信息 ...
- Python爬虫入门:爬取pixiv
终于想开始爬自己想爬的网站了.于是就试着爬P站试试手. 我爬的图的目标网址是: http://www.pixiv.net/search.php?word=%E5%9B%9B%E6%9C%88%E3%8 ...
- python 爬虫入门1 爬取代理服务器网址
刚学,只会一点正则,还只能爬1页..以后还会加入测试 #coding:utf-8 import urllib import urllib2 import re #抓取代理服务器地址 Key = 1 u ...
随机推荐
- EMF与GEF
基于Eclipse的编程架构 类似的场景大家基本都见过: JBPM--流程插件 Mule---ESB插件
- Telnet命令相关+DMZ主机+花生壳
Win7如何解决telnet不是内部或外部命令的方案! telnet用法 测试端口号
- socket和udp简介
socket简介 1.本地的进程间通信(IPC)有很多种方式,例如 队列 同步(互斥锁.条件变量等) 以上通信方式都是在一台机器上不同进程之间的通信方式,那么问题来了 网络中进程之间如何通信? 2. ...
- (翻译)React Container Components
原文:Container Components Container Components 在 React 模式上对我的代码有最深远影响的一个模式叫 container component 模式. 在 ...
- MPI n 体问题
▶ <并行程序设计导论>第六章中讨论了 n 体问题,分别使用了 MPI,Pthreads,OpenMP 来进行实现,这里是 MPI 的代码,分为基本算法和简化算法(引力计算量为基本算法的一 ...
- [代码]set容器查找操作使用
对于set容器来说,查找功能是该容器的主要优势,故针对该容器查找功能作一测试. 主要有如下API接口: 测试源码如下: #include<set> void test(){ set< ...
- 2.spring整合ehcache 注解实现查询缓存,并实现实时缓存更新或删除
转自:http://www.importnew.com/23358.html 写在前面:上一篇博客写了spring cache和ehcache的基本介绍,个人建议先把这些最基本的知识了解了才能对今天主 ...
- Oracle Tip: Choosing an efficient design for Boolean column values
Takeaway: When designing a database table structure, it's important to choose an efficient strategy ...
- Java路程
Java学习这一部分其实也算是今天的重点,这一部分用来回答很多群里的朋友所问过的问题,那就是你是如何学习Java的,能不能给点建议?今天我是打算来点干货,因此咱们就不说一些学习方法和技巧了,直接来谈每 ...
- 新手C#类、对象、字段、方法的学习2018.08.05
类:具有相似属性和方法的对象的集合,如“人”是个类. 对象(实例):对象是具体的看得见摸得着的,如“张三”是“人”这个类的对象.(new Person()开辟了堆空间中,=开辟了栈空间,变量P存放在该 ...