
sklearn中常用数据预处理方法
1. 标准化(Standardization or Mean Removal and Variance Scaling)
变换后各维特征有0均值,单位方差。也叫z-score规范化(零均值规范化)。计算方式是将特征值减去均值,除以标准差。
sklearn.preprocessing.scale(X)
一般会把train和test集放在一起做标准化,或者在train集上做标准化后,用同样的标准化器去标准化test集,此时可以用scaler
 scaler = sklearn.preprocessing.StandardScaler().fit(train)

 scaler.transform(train)

 scaler.transform(test)
实际应用中,需要做特征标准化的常见情景:SVM
2. 最小-最大规范化
最小-最大规范化对原始数据进行线性变换,变换到[0,1]区间(也可以是其他固定最小最大值的区间)
 min_max_scaler = sklearn.preprocessing.MinMaxScaler()

 min_max_scaler.fit_transform(X_train)
3.规范化(Normalization)
规范化是将不同变化范围的值映射到相同的固定范围,常见的是[0,1],此时也称为归一化。《机器学习》周志华
将每个样本变换成unit norm。
 X = [[ 1, -1, 2],[ 2, 0, 0], [ 0, 1, -1]]

 sklearn.preprocessing.normalize(X, norm='l2')
得到
array([[ 0.40, -0.40, 0.81], [ 1, 0, 0], [ 0, 0.70, -0.70]])
可以发现对于每一个样本都有,0.4^2+0.4^2+0.81^2=1,这就是L2 norm,变换后每个样本的各维特征的平方和为1。类似地,L1 norm则是变换后每个样本的各维特征的绝对值和为1。还有max norm,则是将每个样本的各维特征除以该样本各维特征的最大值。
在度量样本之间相似性时,如果使用的是二次型kernel,需要做Normalization
4. 特征二值化(Binarization)
给定阈值,将特征转换为0/1
 binarizer = sklearn.preprocessing.Binarizer(threshold=1.1)

 binarizer.transform(X)
5. 标签二值化(Label binarization)
lb = sklearn.preprocessing.LabelBinarizer()
6. 类别特征编码
有时候特征是类别型的,而一些算法的输入必须是数值型,此时需要对其编码。
 enc = preprocessing.OneHotEncoder()

 enc.fit([[0, 0, 3], [1, 1, 0], [0, 2, 1], [1, 0, 2]])

 enc.transform([[0, 1, 3]]).toarray()  #array([[ 1., 0., 0., 1., 0., 0., 0., 0., 1.]])
上面这个例子,第一维特征有两种值0和1,用两位去编码。第二维用三位,第三维用四位
7.标签编码(Label encoding)
 le = sklearn.preprocessing.LabelEncoder()

 le.fit([1, 2, 2, 6])

 le.transform([1, 1, 2, 6])  #array([0, 0, 1, 2])

 #非数值型转化为数值型

 le.fit(["paris", "paris", "tokyo", "amsterdam"])

 le.transform(["tokyo", "tokyo", "paris"])  #array([2, 2, 1])
8.特征中含异常值时
sklearn.preprocessing.robust_scale
9.生成多项式特征
这个其实涉及到特征工程了,多项式特征/交叉特征。
 poly = sklearn.preprocessing.PolynomialFeatures(2)

 poly.fit_transform(X)
原始特征:

转化后:
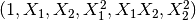
sklearn中常用数据预处理方法的更多相关文章
- sklearn中的数据预处理和特征工程
小伙伴们大家好~o( ̄▽ ̄)ブ,沉寂了这么久我又出来啦,这次先不翻译优质的文章了,这次我们回到Python中的机器学习,看一下Sklearn中的数据预处理和特征工程,老规矩还是先强调一下我的开发环境是 ...
- 机器学习实战基础(八):sklearn中的数据预处理和特征工程(一)简介
1 简介 数据挖掘的五大流程: 1. 获取数据 2. 数据预处理 数据预处理是从数据中检测,纠正或删除损坏,不准确或不适用于模型的记录的过程 可能面对的问题有:数据类型不同,比如有的是文字,有的是数字 ...
- 机器学习实战基础(十五):sklearn中的数据预处理和特征工程(八)特征选择 之 Filter过滤法(二) 相关性过滤
相关性过滤 方差挑选完毕之后,我们就要考虑下一个问题:相关性了. 我们希望选出与标签相关且有意义的特征,因为这样的特征能够为我们提供大量信息.如果特征与标签无关,那只会白白浪费我们的计算内存,可能还会 ...
- 机器学习实战基础(十三):sklearn中的数据预处理和特征工程(六)特征选择 feature_selection 简介
当数据预处理完成后,我们就要开始进行特征工程了. 在做特征选择之前,有三件非常重要的事:跟数据提供者开会!跟数据提供者开会!跟数据提供者开会!一定要抓住给你提供数据的人,尤其是理解业务和数据含义的人, ...
- 机器学习实战基础(十一):sklearn中的数据预处理和特征工程(四) 数据预处理 Preprocessing & Impute 之 处理分类特征:编码与哑变量
处理分类特征:编码与哑变量 在机器学习中,大多数算法,譬如逻辑回归,支持向量机SVM,k近邻算法等都只能够处理数值型数据,不能处理文字,在sklearn当中,除了专用来处理文字的算法,其他算法在fit的 ...
- 机器学习实战基础(十):sklearn中的数据预处理和特征工程(三) 数据预处理 Preprocessing & Impute 之 缺失值
缺失值 机器学习和数据挖掘中所使用的数据,永远不可能是完美的.很多特征,对于分析和建模来说意义非凡,但对于实际收集数据的人却不是如此,因此数据挖掘之中,常常会有重要的字段缺失值很多,但又不能舍弃字段的 ...
- 机器学习实战基础(九):sklearn中的数据预处理和特征工程(二) 数据预处理 Preprocessing & Impute 之 数据无量纲化
1 数据无量纲化 在机器学习算法实践中,我们往往有着将不同规格的数据转换到同一规格,或不同分布的数据转换到某个特定分布的需求,这种需求统称为将数据“无量纲化”.譬如梯度和矩阵为核心的算法中,譬如逻辑回 ...
- matlab、sklearn 中的数据预处理
数据预处理(normalize.scale) 0. 使用 PCA 降维 matlab: [coeff, score] = pca(A); reducedDimension = coeff(:,1:5) ...
- sklearn中的数据预处理----good!! 标准化 归一化 在何时使用
RESCALING attribute data to values to scale the range in [0, 1] or [−1, 1] is useful for the optimiz ...
随机推荐
- Luogu 1641 [SCOI2010]生成字符串
结果和dp没有一点关系…… 30分算法:设$f_{i, j}$表示已经选了$i$个并且有$j$个是白色的状态数,转移显然,最后答案就是$f_{n + m, m}$,时间复杂度$O(n^{2})$. 1 ...
- Markdown语法简介 | Markdown Tutorial
Markdown是一种轻量级标记语言,允许人们使用易读易写的纯文本格式编写文档,然后转换成有效的HTML文档. 与Word相比,使用Markdown最大的好处是可以使人们将注意力集中与文字本身而非排版 ...
- javascript 常用兼容fire fox的解决办法
常用兼容fire fox的解决办法 一.js不兼容:1.event不兼容,必须通过参数传递过来: function test(event){ //兼容fire fox var event = even ...
- 公司内部Wiki及搭建wiki系统-confluence
Wiki 是一个协同著作平台或称开放编辑系统.我们可以用Wiki来建设帮助系统,知识库系统.国内公共wiki最著名就是百度百科.那公司内部为什么要使用wiki呢? 2.内部wiki的作用 1.鼓励分享 ...
- sonar Failed to execute goal org.sonarsource.scanner.maven:sonar-maven-plugin:3.4.0.905:sonar
背景: 今天在项目根目录执行maven sonar:sonar ,报错信息如下,然后就各种的搜,折腾了多半天天也没找出解决办法,最后打算放弃时,看到一遍文章说是mysql max_allowed_p ...
- Mybatis环境搭建中的案例分析 及 如果自己编写DAO接口的实现类
Mybatis环境搭建中的案例分析public static void main (String[] args) throws Exception { //读配置文件 //第一个: 使用类加载器,只能 ...
- linux影响上传文件大小的因素
主要是从三个方面 ①.php代码方面(这个无需说明) ②.php.ini配置 max_execution_time = 600 ;每个PHP页面运行的最大时间值(秒),默认30秒max_input_t ...
- SQL Server 附加数据库 错误5210
前言 那天在弄机房的时候,附加数据库总是附加不上,然而将附加数据库文件放到优盘里,就可以附加成功.我也不知道为什么了,但是这次还是别将就了.于是乎,上网查了查原来是权限不够啊.这可怎么办,见下面三种方 ...
- 洛谷P3178 [HAOI2015]树上操作(线段树)
题目描述 有一棵点数为 N 的树,以点 1 为根,且树点有边权.然后有 M 个操作,分为三种:操作 1 :把某个节点 x 的点权增加 a .操作 2 :把某个节点 x 为根的子树中所有点的点权都增加 ...
- 选课 ( dp 树形dp 动态规划 树规)
和某篇随笔重了?!!?!?!?!?!?不管了留着吧 题目: 在大学里每个学生,为了达到一定的学分,必须从很多课程里选择一些课程来学习,在课程里有些课程必须在某些课程之前学习,如高等数学总是在其它课程之 ...