
【WEB UI自动化】Selenium爬取用户的知乎回答时遇到10002:请求参数异常,请升级客户端后重试
这里分享一个低配版知乎爬虫,利用了Selenium模块
爬取的过程中遇到了10002:请求参数异常,请升级客户端后重试,调用知乎某用户的回答API返回的HTTP状态码是403 Forbidden
之后找了一篇博客,里面给出的解决方案是:使用自己打开的一个浏览器,再用selenium接管这个浏览器这样就可以完成反爬的处理。
步骤
1
cmd切换到chrome.exe所在的目录下,
(文件资源管理器内,到指定目录下,在地址栏输入cmd回车也行)
执行命令chrome.exe --remote-debugging-port=9222 --user-data-dir="E:\selenium_data"
其中--remote-debugging-port是建立新的移植位置,其中端口后面会使用(自定义), --user-data-dir是数据存储的目录(自定义)
2
运行py代码爬取某用户的回答
from selenium import webdriver

from selenium.webdriver.common.action_chains import ActionChains

import time

import requests

from selenium.webdriver.common.keys import Keys

from selenium import webdriver

from selenium.webdriver.chrome.options import Options

from selenium.webdriver.support.ui import WebDriverWait

def load_photo(url, name):

    '''给定图片链接,将图片以某个名称下载到本地'''

    # url = 'http://img14.360buyimg.com/n1/s450x450_jfs/t1/148801/37/12770/118749/5f9d71e4E39f1e893/533675187c108953.jpg'

    reponse = requests.get(url)

    # name = 'd:/photo.jpg'

    with open(name, 'wb') as ft:

        ft.write(reponse.content)

def drop_scroll(browser):

    '''将滑条从头滚动到底,以便让浏览器充分加载'''

    for x in range(1, 11, 2):

        # time.sleep(0.5)

        j = x/10

        js = 'document.documentElement.scrollTop = document.documentElement.scrollHeight * %f' % j

        browser.execute_script(js)

def switch_window(browser):

    '''将browser的指令移到新打开的小窗口处'''

    # time.sleep(0.5) # 如果移转失败,请增大这个时间

    windows = browser.window_handles

    browser.switch_to.window(windows[-1])

def switch_window_back(browser):

    '''将browser的指令移回旧的小窗口'''

    windows = browser.window_handles

    browser.switch_to.window(windows[0])

# 构造网址

u_id= input('请输入https://www.zhihu.com/people/{u_id}中的u_id')

url = f'https://www.zhihu.com/people/{u_id}'

page = int(input("要遍历的页数(从第一页开始)"))

# 打开知乎

chrome_options = Options()

chrome_options.add_experimental_option("debuggerAddress", "127.0.0.1:9222")  #  前面设置的端口号

browser = webdriver.Chrome(options=chrome_options)

# browser.set_window_size(900, 500) # 设置窗口大小

# browser.set_window_position(300, 200) # 设置浏览器的位置

browser.get(url)

btn=browser.find_element_by_xpath("//button[@aria-label='关闭']")

browser.execute_script("arguments[0].click();", btn)

time.sleep(2)

# 遍历页面中每篇回答

count = 1 # 回答的编号

for page_id in range(1,page+1):

    # 翻页

    print("Page:%d" %page_id)

    url = f'https://www.zhihu.com/people/{u_id}/answers/by_votes/?page={page_id}'

    browser.get(url)

    time.sleep(2)

    btn = browser.find_element_by_xpath("//button[@aria-label='关闭']")

    browser.execute_script("arguments[0].click();", btn)

    time.sleep(2)

    switch_window_back(browser)  # 将browser的指令移回到新标签页

    drop_scroll(browser)     #滑条拖到底,让加载完全

    answers = browser.find_elements_by_xpath("//div[@class='ContentItem AnswerItem']")  # 获取所有回答

    for answer in answers:

        print(answer.find_element_by_xpath(".//a[@data-za-detail-view-element_name='Title']").get_attribute('href')\

              , answer.find_element_by_xpath(".//a[@data-za-detail-view-element_name='Title']").text\

              , answer.find_element_by_xpath(".//button[@class='Button VoteButton VoteButton--up']").text

              , sep=' , ')

        print(count)

        count=count+1

一个注意的点是webdriver.Chrome()是可以传入参数的,
executable_path传入的值得当的话不必把chromedriver.exe设在$PATH里

//以上图片来自这个网站
像极了一名爬虫新手的课程作业。。。
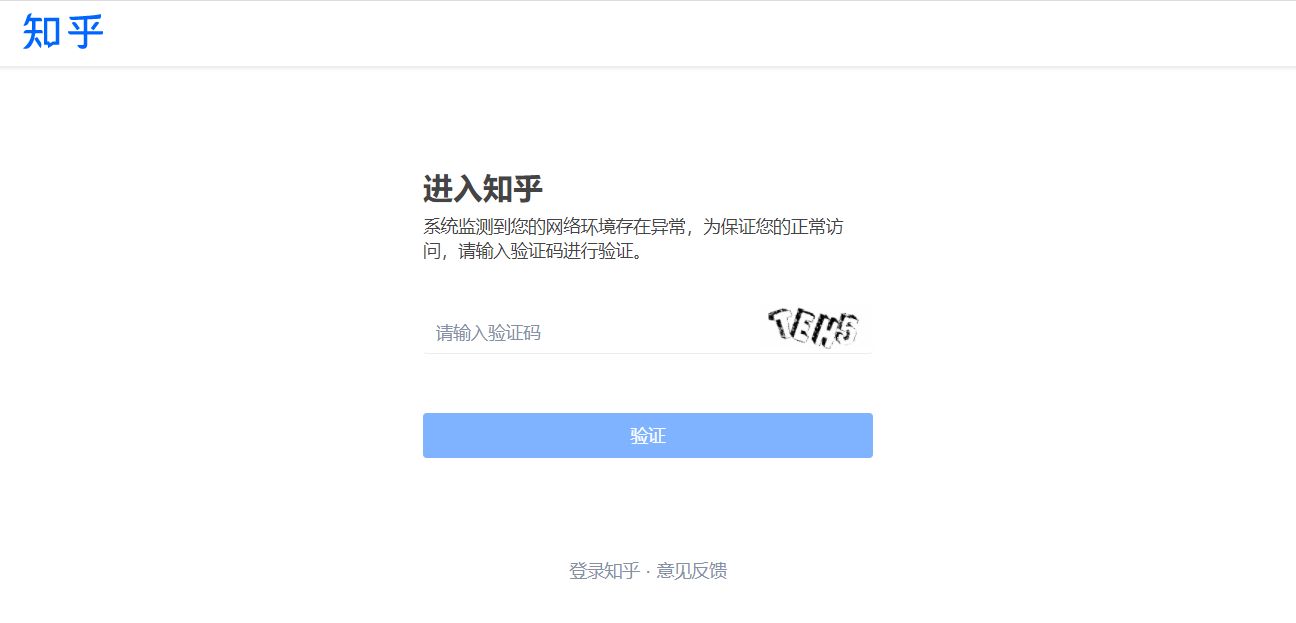
爬取了85页之后被知乎检测到了。。。
【WEB UI自动化】Selenium爬取用户的知乎回答时遇到10002:请求参数异常,请升级客户端后重试的更多相关文章
- selenium登录爬取知乎出现:请求异常请升级客户端后重试的问题(用Python中的selenium接管chrome)
一.问题使用selenium自动化测试爬取知乎的时候出现了:错误代码10001:请求异常请升级客户端后重新尝试,这个错误的产生是由于知乎可以检测selenium自动化测试的脚本,因此可以阻止selen ...
- selenium(12)-web UI自动化项目实战(PO模式,代码封装)
web UI自动化项目实战-项目 项目使用禅道,所以你需要搭建1个禅道,搭建禅道的方法和步骤见 https://www.cnblogs.com/xinhua19/p/13151296.html 搭建U ...
- Python Selenium 搭建Web UI自动化
Python搭建UI自动化环境 下载Python3 Python官网 PyCharm 环境配置 安装Python 勾选Add Python to PATH,一直下一步. 验证:CMD输入Python ...
- UI自动化selenium
1.什么是UI自动化?模拟人用代码的方式去操作页面2.为什么要做UI自动化?后期迭代的时候,老功能比较多,人工维护成本较大,重复性工作较多,这个时候就考虑因为UI自动化3.什么时候做UI自动化?项目稳 ...
- 【Robot Framework 项目实战 02】SeleniumLibrary Web UI 自动化
前言 SeleniumLibrary 是针对 Robot Framework 开发的 Selenium 库.它也 Robot Framework 下面最流程的库之一.主要用于编写 Web UI 自动化 ...
- UI自动化(selenium+python)之元素定位的三种等待方式
前言 在UI自动化过程中,常遇到元素未找到,代码报错的情况.这种情况下,需要用等待wait. 在selenium中可以用到三种等待方式即sleep,implicitly_wait,WebDriverW ...
- web端自动化——Selenium Grid原理
利用Selenium Grid可以在不同的主机上建立主节点(hub)和分支节点(node),可以使主节点上的测试用例在不同的分支节点上运行. 对不同的节点来说,可以搭建不同的测试环境(操作系统.浏 ...
- Selenium系列(十四) - Web UI 自动化基础实战(1)
如果你还想从头学起Selenium,可以看看这个系列的文章哦! https://www.cnblogs.com/poloyy/category/1680176.html 其次,如果你不懂前端基础知识, ...
- Selenium系列(十五) - Web UI 自动化基础实战(2)
如果你还想从头学起Selenium,可以看看这个系列的文章哦! https://www.cnblogs.com/poloyy/category/1680176.html 其次,如果你不懂前端基础知识, ...
- Selenium系列(十六) - Web UI 自动化基础实战(3)
如果你还想从头学起Selenium,可以看看这个系列的文章哦! https://www.cnblogs.com/poloyy/category/1680176.html 其次,如果你不懂前端基础知识, ...
随机推荐
- eclipse中利用Maven逆向工程生成PO类以及mapper(mybatis)
在pom.xml的project>build里面添加如下代码,让maven环境支持mybatis-generator组件 <pluginManagement> <plu ...
- 【批量下载】url——wget,给定网址,批量下载文件
写在前面:最近在学习批量下载sci文章并传入noteexpress,从网上学来了一些方法,其中有一步需要使用url将sci-hub上面的文章批量下载下来. 学习网址:[研究生]快速批量下载 Web o ...
- pycharm的安装与使用
官网下载最新版本,然后用激活码,激活,注意是专业版. 方法找到后更新在这里. 进入软件之后创建新的文件夹,可以自定义,建议自定义在系统盘以外, 1.新建文件略过 2.ctrl + 鼠标中键, 调节字体 ...
- react+antd 开发一个可动态增减的复合组件
需求如图: 与后端协商好的表单数据为: 组件代码: /* 阶梯分成组件 */ import React, { useState, useEffect } from 'react'; import { ...
- 音速启动 Vstart 5.7 win10手动移除后台设置主页
Vstart 用了快12年了,用Wireshark跟踪确实会访问广告页面,也会去上传数据.还会悄悄设置主页 ,所以在Win10上老是被干掉 也想着换 CLaunch 确实不喜欢. Rolan 买了一年 ...
- numpy.ndarray类型方法
numpy.ndarray 类numpy.ndarray(shape,dtype = float,buffer = None,offset = 0,strides = None,order = Non ...
- linux一些指令
一. 文件操作命令 查看当前目录下的文件或文件夹 详细查看ls –l 每列代表不同的意义: 第一列drwxr-xr-x 表示权限, n 其中第一个字符d表示 目录(可能有b-块 ...
- python 如何实现多线程
今天本来打算学习学习多进程的,但是由于我现在的电脑没有Linux系统,无法通过Linux系统编辑一些多进程的程序,因此我打算从多线程入手. 多线程 我们的程序一般都是多任务的,如果你没有好好的利用好, ...
- wait_event_interruptible() 等待队列
在Linux驱动程序中,可以使用等待队列(Wait Queue)来实现阻塞进程的唤醒. 1.定义"等待队列头部" wait_queue_head_t my_queue; wait_ ...
- 与用户交互 Scanner
与用户交互 Scanner Scanner对象 Java提供了一个工具类,可以用以获取用户的输入.java.util.Scanner 是Java5的新特征 基本语法 Scanner s = new S ...