
Python机器学习(1):KMeans聚类
Python进行KMeans聚类是比较简单的,首先需要import numpy,从sklearn.cluster中import KMeans模块:
import numpy as np

from sklearn.cluster import KMeans
然后读取txt文件,获取相应的数据并转换成numpy array:
X = []

f = open('rktj4.txt')

for v in f:

    regex = re.compile('\s+')

    X.append([float(regex.split(v)[3]), float(regex.split(v)[6])])

X = np.array(X)
设置类的数量,并聚类:
n_clusters = 5

cls = KMeans(n_clusters).fit(X)
完整代码:
import numpy as np

from sklearn.cluster import KMeans

import matplotlib.pyplot as plt

import re

X = []

f = open('rktj4.txt')

for v in f:

    regex = re.compile('\s+')

    X.append([float(regex.split(v)[3]), float(regex.split(v)[6])])

X = np.array(X)

n_clusters = 5

cls = KMeans(n_clusters).fit(X)

cls.labels_

markers = ['^','x','o','*','+']

for i in range(n_clusters):

    members = cls.labels_ == i

    plt.scatter(X[members, 0], X[members, 1], s=60, marker=markers[i], c='b', alpha=0.5)

    print

plt.title('')

plt.show()
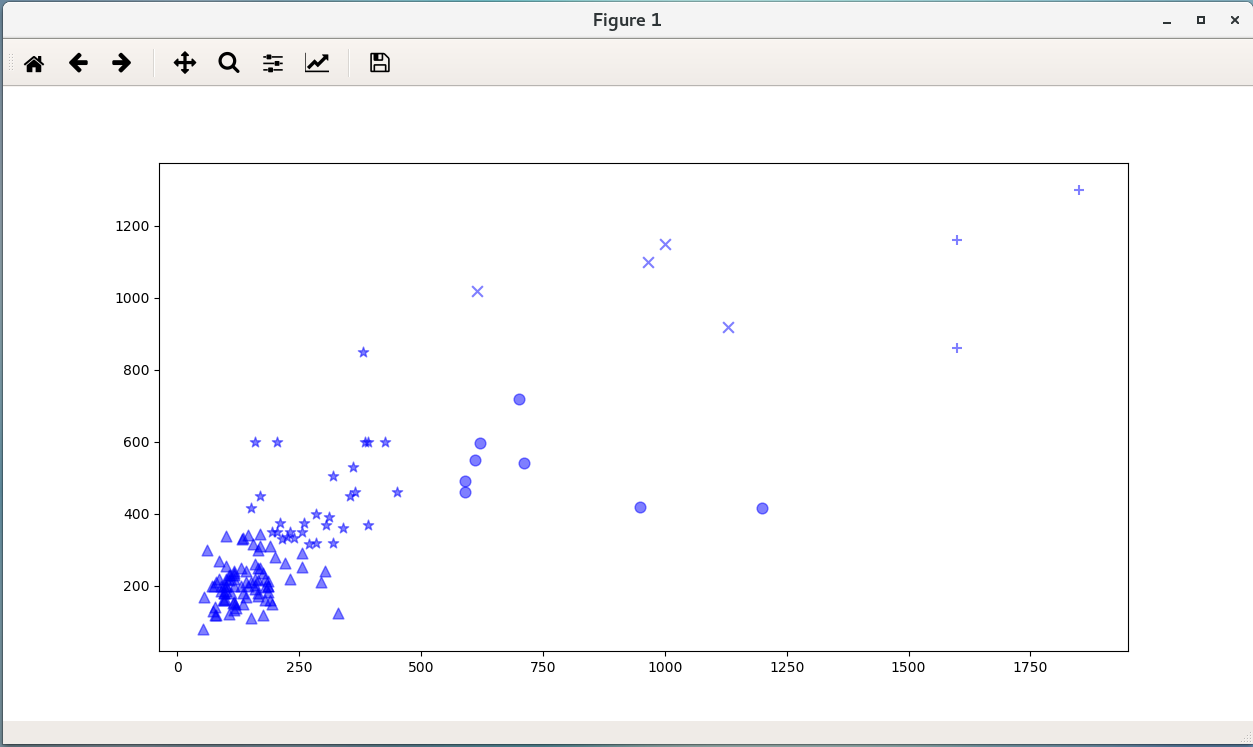
运行结果:
Python机器学习(1):KMeans聚类的更多相关文章
- Python机器学习算法 — K-Means聚类
K-Means简介 步,直到每个簇的中心基本不再变化: 6)将结果输出. K-Means的说明 如图所示,数据样本用圆点表示,每个簇的中心点用叉叉表示: (a)刚开始时是原始数据,杂乱无章 ...
- 机器学习六--K-means聚类算法
机器学习六--K-means聚类算法 想想常见的分类算法有决策树.Logistic回归.SVM.贝叶斯等.分类作为一种监督学习方法,要求必须事先明确知道各个类别的信息,并且断言所有待分类项都有一个类别 ...
- 【Python机器学习实战】聚类算法(1)——K-Means聚类
实战部分主要针对某一具体算法对其原理进行较为详细的介绍,然后进行简单地实现(可能对算法性能考虑欠缺),这一部分主要介绍一些常见的一些聚类算法. K-means聚类算法 0.聚类算法算法简介 聚类算法算 ...
- 吴裕雄 python 机器学习——K均值聚类KMeans模型
import numpy as np import matplotlib.pyplot as plt from sklearn import cluster from sklearn.metrics ...
- 菜鸟之路——机器学习之Kmeans聚类个人理解及Python实现
一些概念 相关系数:衡量两组数据相关性 决定系数:(R2值)大概意思就是这个回归方程能解释百分之多少的真实值. Kmeans聚类大致就是选择K个中心点.不断遍历更新中心点的位置.离哪个中心点近就属于哪 ...
- 机器学习算法-K-means聚类
引文: k均值算法是一种聚类算法.所谓聚类.他是一种无监督学习,将类似的对象归到同一个蔟中.蔟内的对象越类似,聚类的效果越好. 聚类和分类最大的不同在于.分类的目标事先已知.而聚类则不一样. 由于其产 ...
- 转载 | Python AI 教学│k-means聚类算法及应用
关注我们的公众号哦!获取更多精彩哦! 1.问题导入 假如有这样一种情况,在一天你想去某个城市旅游,这个城市里你想去的有70个地方,现在你只有每一个地方的地址,这个地址列表很长,有70个位置.事先肯定要 ...
- 【Python机器学习实战】聚类算法(2)——层次聚类(HAC)和DBSCAN
层次聚类和DBSCAN 前面说到K-means聚类算法,K-Means聚类是一种分散性聚类算法,本节主要是基于数据结构的聚类算法--层次聚类和基于密度的聚类算法--DBSCAN两种算法. 1.层次聚类 ...
- 机器学习: K-means 聚类
今天介绍机器学习里常见的一种无监督聚类算法,K-means.我们先来考虑在一个高维空间的一组数据集,S={x1,x2,...,xN}" role="presentation&quo ...
- 机器学习:K-Means聚类算法
本文来自同步博客. 前面几篇文章介绍了回归或分类的几个算法,它们的共同点是训练数据包含了输出结果,要求算法能够通过训练数据掌握规律,用于预测新输入数据的输出值.因此,回归算法或分类算法被称之为监督学习 ...
随机推荐
- 【C++ Primer | 15】C++虚函数表剖析②
多重继承 下面,再让我们来看看多重继承中的情况,假设有下面这样一个类的继承关系. 注意:子类只overwrite了父类的f()函数,而还有一个是自己的函数(我们这样做的目的是为了用g1()作为一个标记 ...
- springboot+thymeleaf简单使用
关于springboot想必很多人都在使用,由于公司项目一直使用的是SpringMVC,所以自己抽空体验了一下springboot的简单使用. 环境搭建 springbooot的环境搭建可以说很灵活, ...
- 6.Django与Ajax
Ajax 文件夹为Ajaxdemo 向服务器发送请求的途径: 1.浏览器地址栏,默认get请求: 2.form表单: get请求 post请求 3.a标签,超链接(get请求) 4.Ajax请求 特点 ...
- 【Java】 剑指offer(42) 连续子数组的最大和
本文参考自<剑指offer>一书,代码采用Java语言. 更多:<剑指Offer>Java实现合集 题目 输入一个整型数组,数组里有正数也有负数.数组中一个或连续的多个整/ ...
- PHP 扩展 MongoDB
打开phpinfo 查看 nts(非线程) 还是 ts (线程),操作位数: 下载对应的版本的php_mongodb.dll 文件 下载链接: pecl mangodb下载 把文件解压出来 php_m ...
- dns 安全
域名系统组织架构 DNS是全球互联网中最重要的基础服务之一,也是如今唯一的一种有中心点的服务.全球域名系统组织与管理架构如下图所示: ICANN 互联网名称与数字地址分配机构(The Interne ...
- 4067: [Ctsc2015]gender 动态规划 网络流
国际惯例的题面:首先这题是缺少两个隐藏条件的:第一个是这k条链的起点和终点所在的层是对齐的,也就是说不会出现两条链错开的情况,且这张图恰好由n层组成:第二个就是任意一个点都包含在与链上的点直接或间接相 ...
- BZOJ.1009.[HNOI2008]GT考试(KMP DP 矩阵快速幂)
题目链接 设f[i][j]为当前是第i位考号.现在匹配到第j位(已有j-1位和A[]匹配)的方案数 因为假如当前匹配j位,如果选择的下一位与A[j+1]不同,那么新的匹配位数是fail[j]而不是0, ...
- 潭州课堂25班:Ph201805201 python 操作数据库 第五课 (课堂笔记)
一 用 python 操作 mysql 1,导入 pymysql 2,检查配置文件, 3,端口转发 如果 python 在本机,数据库在远程,或虚拟机则需要 4用 python 连接 # -*- co ...
- Flask启动原理,源码流程分析
1.执行Flask的实例对象.run()方法 from flask import Flask,request,session app = Flask(__name__) app.secret_key ...