
【原创】Thinking in BigData (1)大数据简介
提到大数据,就不得不提到Hadoop,提到Hadoop,就不得不提到Google公布的3篇研究论文:GFS、MapReduce、BigTable,Google确实是一家伟大的公司,开启了全球的大数据时代,
在《后谷歌时代:大数据的没落与区块链经济的崛起》中如此说道:
googol一词的意思是10的100次方--一个大到不可思议的数字。
...
随着岁月的流逝,谷歌几乎数字化了世界上所有可以获取的图书(2005),数字化了世界语言这个大织锦挂毯上的所有语言及其翻译(2010),数字化了这个星球的地形(谷歌地图和谷歌地球,2007),甚至细致到了各个街道的面貌和结构(街景)以及其交通状况(位智,2016),它甚至在其数字面部识别软件中(2006年,现在已大规模升级,是谷歌照片的一部分),将整个世界的面部表情都数字化了。2006年,随着YouTube的来袭,谷歌指挥了异常爆炸性的、不断扩大的数字表演,其内容囊括了世界上大部分图像、音乐和访谈。
将地球表面了无定型的混乱的表面、声音、图像、账目、歌曲、演讲、道路、建筑物、文件、信息和叙事都统一到一个行星式的数字工具中,这是一个举世无双、价值连城的伟大壮举。
...
谷歌的成功几乎不可思议。
...
除了少数微小却至关重要的领域,谷歌向其客户提供的一切都免费。
...
免费地图以惊人的覆盖范围和分辨率使谷歌成为移动和本地服务大师;免费YouTube以惊人的质量和多样性正在成为互联网影音的首选载体;免费电子邮件,优雅简洁和略带神秘的垃圾邮件过滤器,方便的附件和数以百兆的存储空间,还能免费链接查看日历和联系人列表;免费的安卓应用,免费的游戏,免费的搜索带来了速度,提高了效率。免费,免费,免费。免费的假期幻灯片,免费的道德提升,免费的世界文学经典,免费的答案。你的一切心血来潮,都来自谷歌的大脑。
先回到一开始,Google是做搜索引擎(Search Engine)起家的,搜索引擎简而言之,首先需要一堆爬虫按照一定的规则将全网的网页全部爬取下来,然后需要对这些网页进行内容提取,然后对内容进行分词并建倒排索引;当用户搜索时将用户的搜索关键词分词然后查倒排索引并结合一些权重将结果排序后分页返回给用户。
这里其实忽略了很多细节,比如爬虫爬取后要存储所有的原始网页数据,就需要分布式文件存储,于是GFS出现了;在GFS中需要解决分布式一致性问题,于是Chubby出现了;在结果排序时需要参考页面权重,也就是计算PageRank,于是计算模型MapReduce出现了;网页数据需要保留历史版本、支持海量实时写入、支持实时随机访问,比如网页快照功能,于是BigTable出现了。。。
下面是我整理的一个简单的对照表,如有谬误欢迎指出,左侧是Google的原创,右侧是开源版:
| OpenSource | |
|---|---|
| GSA | Lucene、Elastic Search |
| Chubby | Zookeeper |
| GFS | Hadoop HDFS |
| MapReduce | Hadoop MapReduce |
| BigTable | HBase |
| Dremel | Drill、Impala |
| Pregel | Giraph |
| MillWheel | Storm、Spark Streaming、Flink、Samza |
| Spanner | |
| Beam | |
| TensorFlow | |
| Kubernetes |
当前大数据开源领域组件眼花缭乱
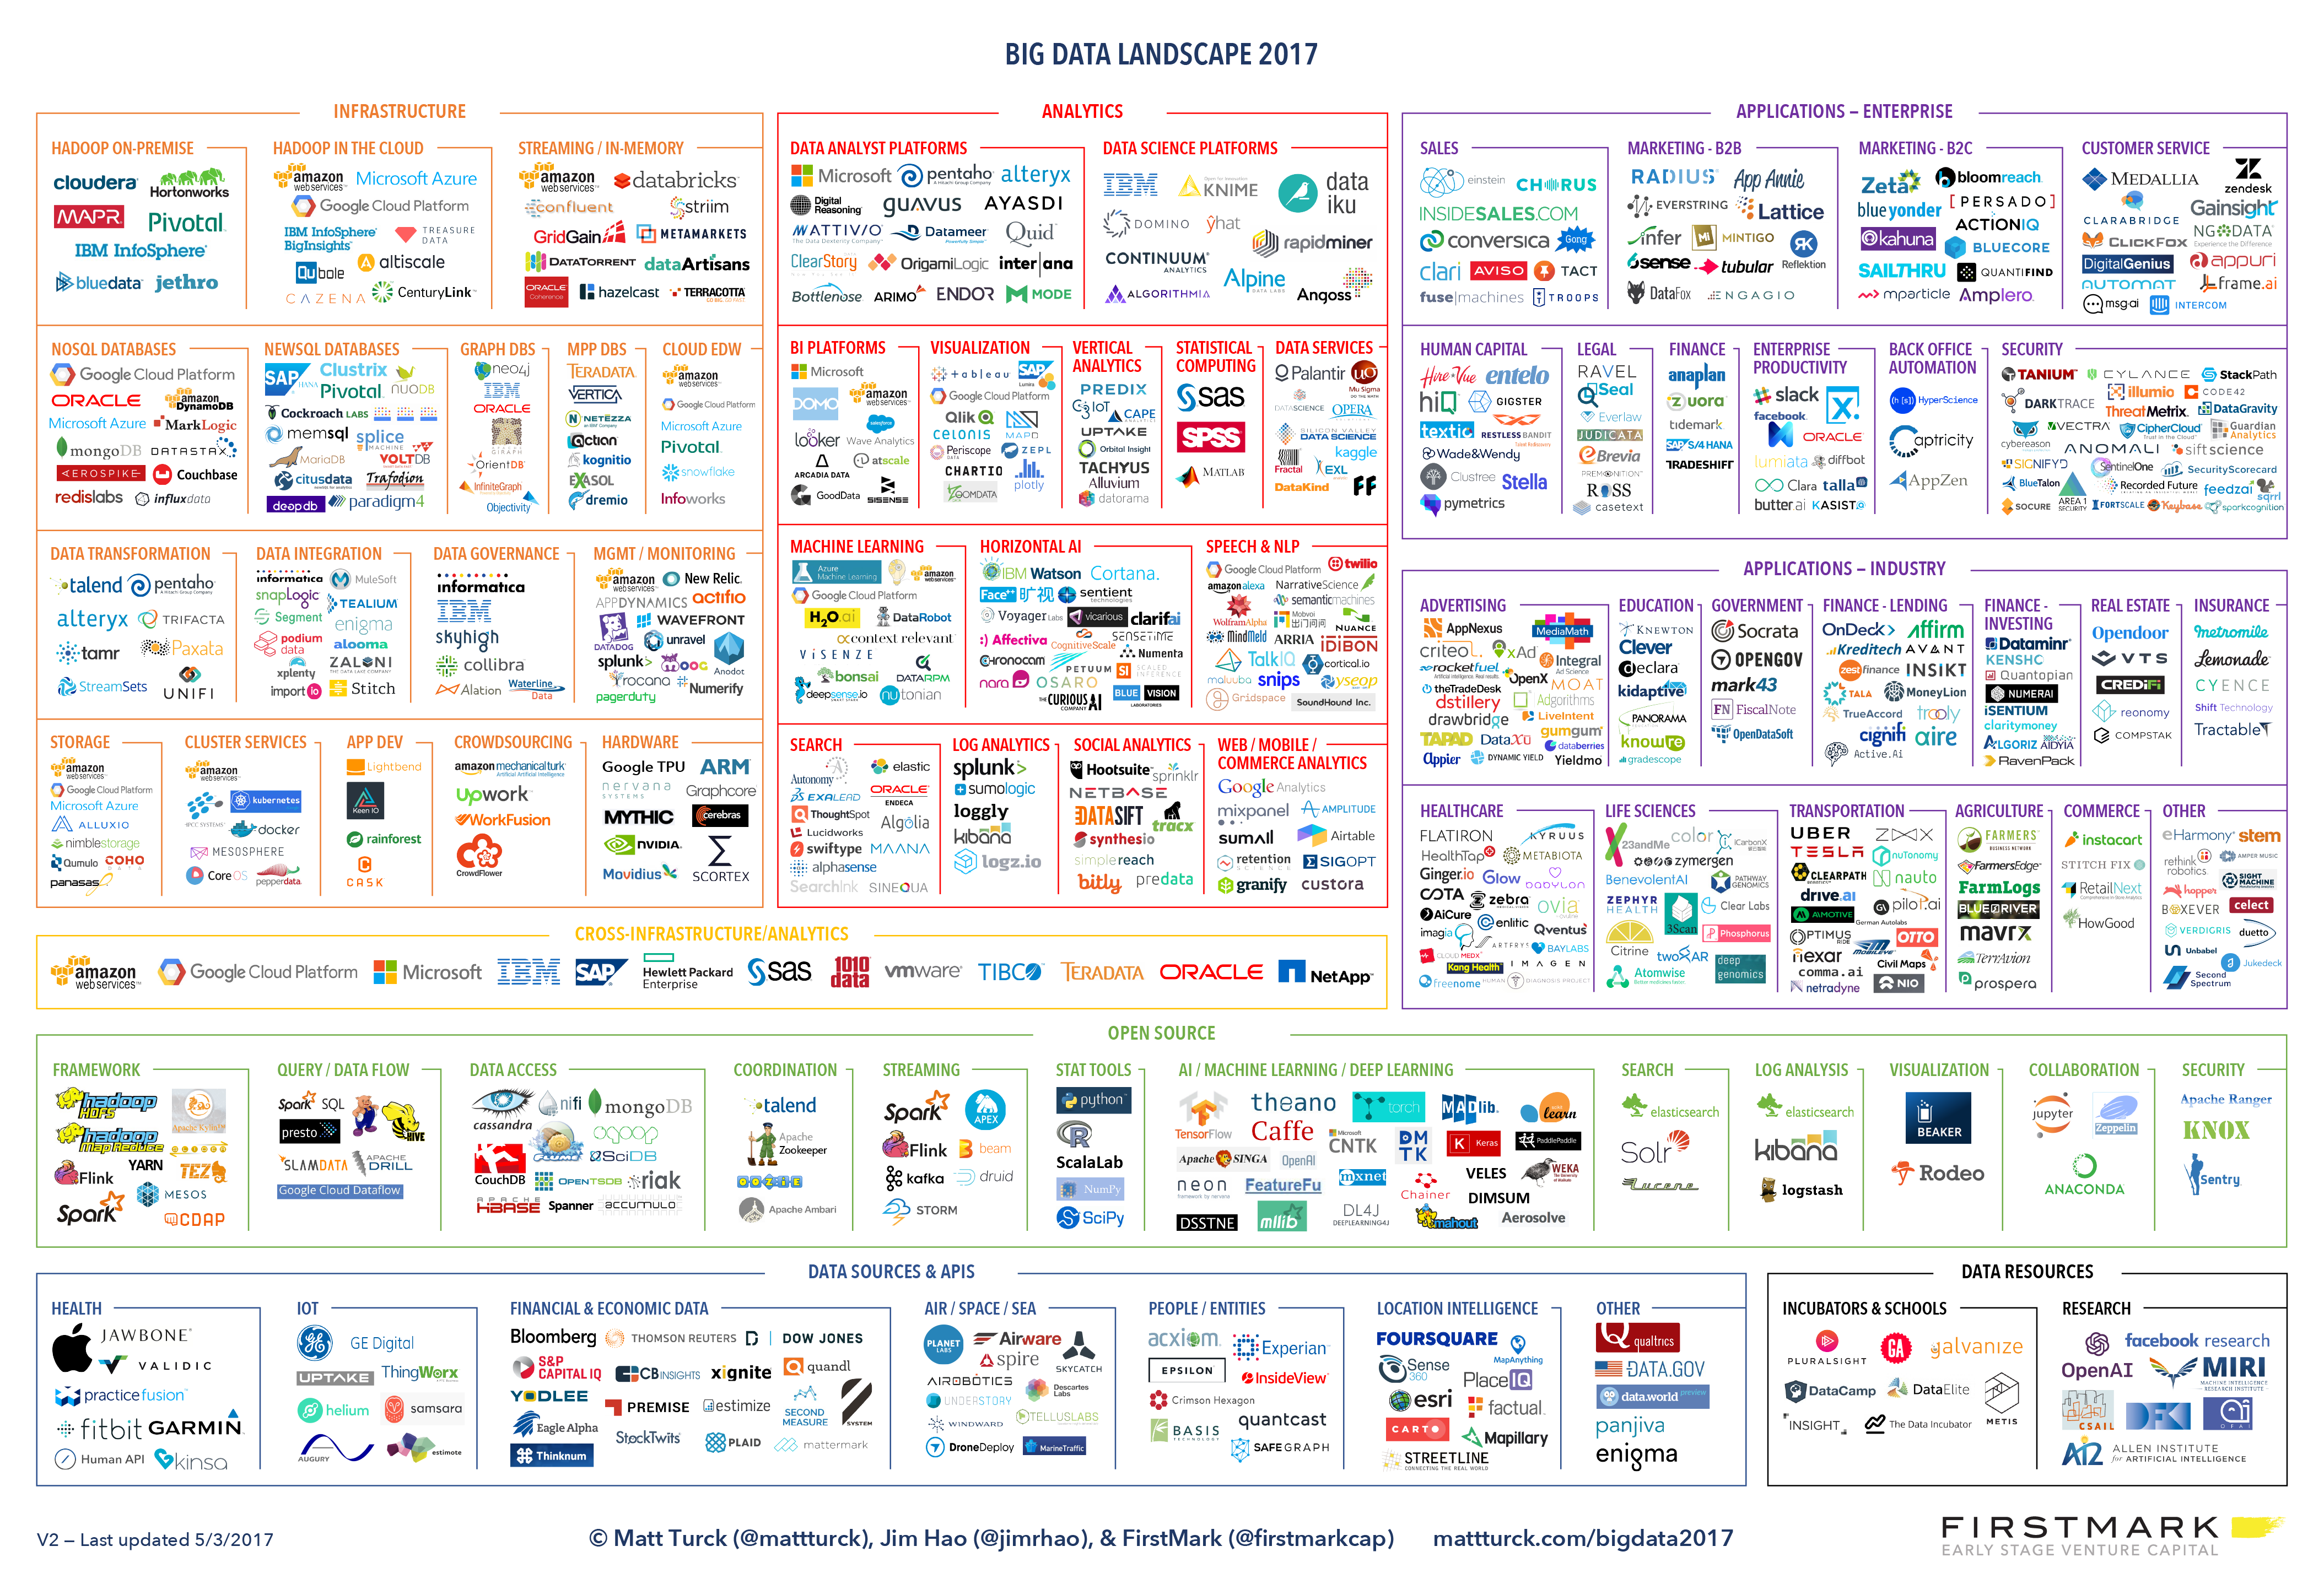
一 常用的开源组件列表
| Zookeeper | 分布式一致性,常用于其他组件的master主从切换 | http://zookeeper.apache.org/ | |
| Kafka | MessageQueue,日志汇总 | http://kafka.apache.org | |
| Hadoop | HDFS | 分布式文件系统 | |
| Yarn | 资源(CPU/Memory)调度 | ||
| MapReduce | 现在基本没有人直接用了,但是其他组件比如hive、oozie等还在用 | ||
| Hive | 数据仓库、离线SQL查询 | ||
| Flume | 日志收集,agent部署在各个终端节点 | ||
| Sqoop | 数据在Hadoop生态内外导入导出,比如hive<->mysql | ||
| Gobblin | ETL工具,比如Kafka->HDFS | ||
| Spark | Spark | 离线计算 | |
| SparkSQL | 离线SQL查询 | ||
| SparkStreaming | 实时计算 | ||
| SparkStructuredStreaming | SQL式实时计算 | ||
| SparkML | 机器学习 | ||
| HBase | 海量KV数据库 | ||
|
Oozie Azkaban Quartz |
任务调度 | ||
|
Parquet ORC Kudu |
数据存储格式,列式存储 | ||
|
ProtocolBuffer Thrift Avro Json |
数据序列化 | ||
| Scala | 编程语言,通吃函数式编程和面向对象编程,代码简洁 | ||
|
ElasticSearch Lucene |
倒排索引搜索 | ||
| Cassandra | 海量KV数据库,比Hbase要快 | ||
| Kylin | 实时查询,利用Hbase空间换时间 | ||
| Druid | |||
|
Impala Drill |
实时查询 | ||
| Hue | Hadoop UI,集成Hadoop生态多个组件的页面UI | ||
| Ambari | 大数据集群快速部署工具、监控工具 | ||
| Nagios | 监控工具 | ||
| Ranger | 权限控制 | ||
| Kerberos | 安全认证 | ||
| Kubernetes | 容器集群管理 |
(内容陆续补充中)
二 发行版
开源组件通常有3个发行版:
1 Apache
基础发行版
2 CDH(Cloudera's Distribution, including Apache Hadoop)
https://www.cloudera.com/products/open-source/apache-hadoop/key-cdh-components.html
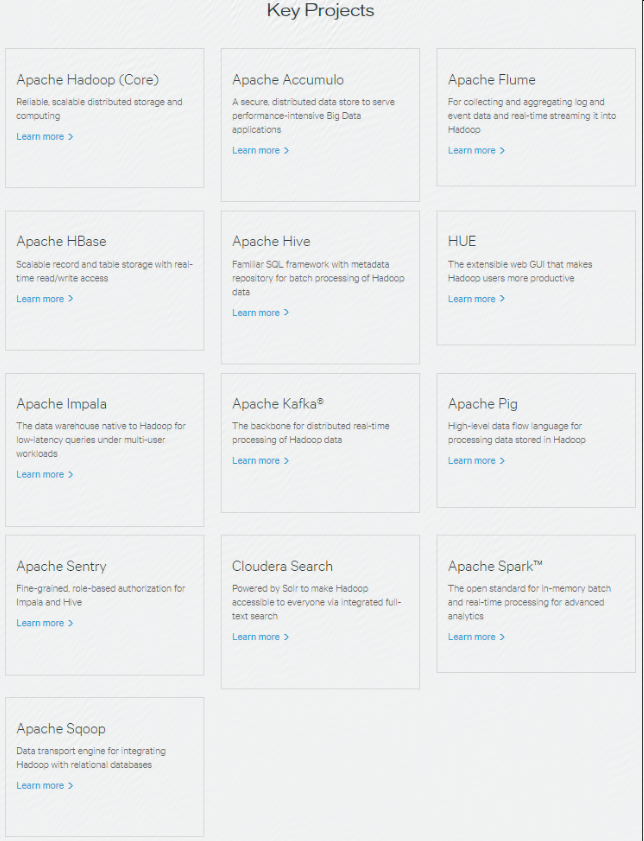
CDH is Cloudera’s 100% open source platform distribution, including Apache Hadoop and built specifically to meet enterprise demands. CDH delivers everything you need for enterprise use right out of the box. By integrating Hadoop with more than a dozen other critical open source projects, Cloudera has created a functionally advanced system that helps you perform end-to-end Big Data workflows.
3 HDP(Hortonworks Data Platform)

HDP is the industry's only true secure, enterprise-ready open source Apache™ Hadoop® distribution based on a centralized architecture (YARN). HDP addresses the complete needs of data-at-rest, powers real-time customer applications and delivers robust big data analytics that accelerate decision making and innovation.
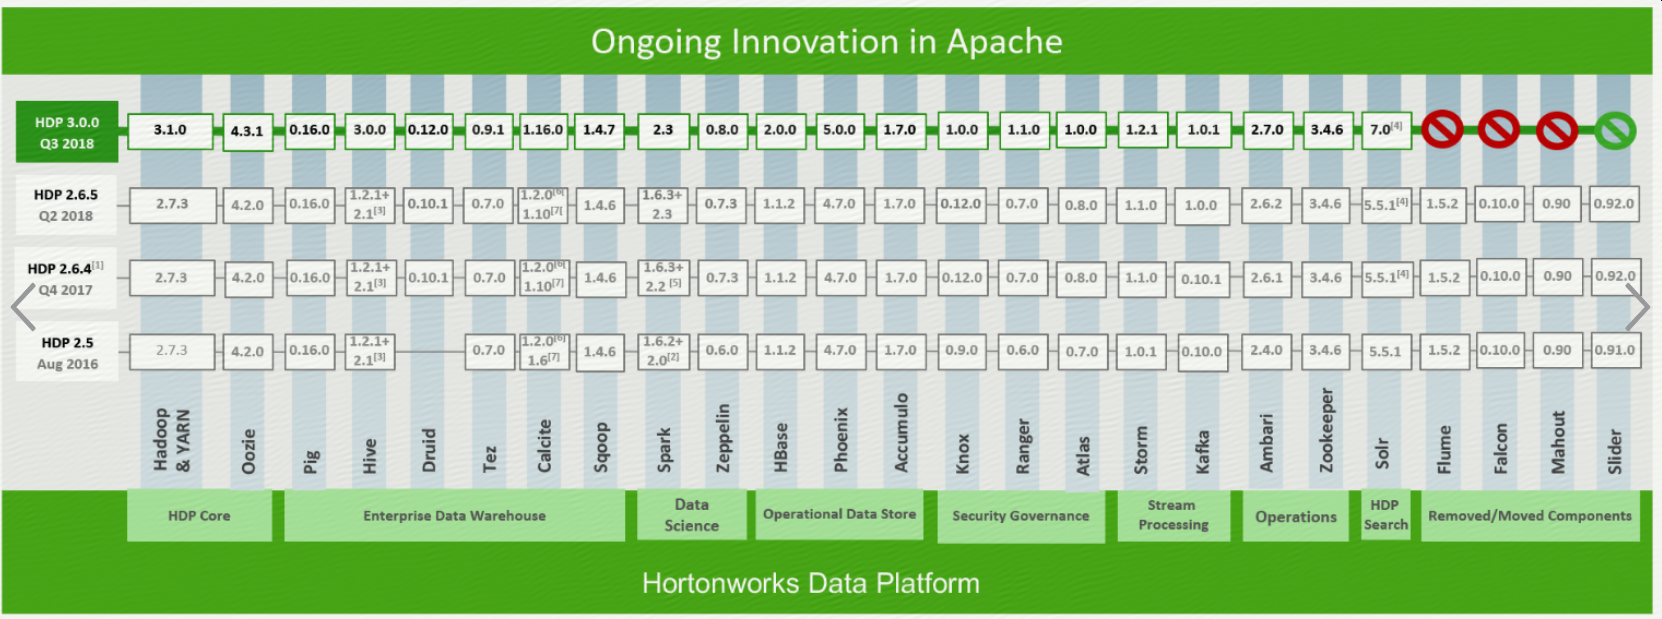
为什么会有这么多发行版,简单来说,CDH和HDP都是基于Apache而来的,直接用Apache的话,各个组件的版本是随意选择的,很容易发生版本兼容问题,CDH和HDP相当于对一系列版本兼容的组件打了一个包并且命名了一个新的版本,更新相对滞后;另外会有一些独有的组件,比如CDH的Cloudera Manager、Hue、Impala等,HDP的Ambari等,方便集群的搭建、管理、监控等工作;
Ambari更开放一些,支持安装第三方组件,比如ElasticSearch、Airflow、Impala、Hue等,详见:https://www.cnblogs.com/barneywill/p/10268501.html
ps:最近Cloudera和Hortonworks两家公司合并了,未来CDH和HDP也可能进一步整合。
【原创】Thinking in BigData (1)大数据简介的更多相关文章
- Spark记录-大数据简介
什么是大数据 大数据(big data),指无法在一定时间范围内用常规软件工具进行捕捉.管理和处理的数据集合,是需要新处理模式才能具有更强的决策力.洞察发现力和流程优化能力的海量.高增长率和多样化的信 ...
- NoSQL数据库技术实战-第1章 NoSQL与大数据简介 NoSQL数据库的类型
键值存储数据库临时性:如Memcached.临时性的键值数据库把数据存储在内存中,在两种情况下会造成上数据的丢失,一是断电,而是数据内容超出内存大小.这种处理的好处是非常快.永久型:如Tokyo Ty ...
- NoSQL数据库技术实战-第1章 NoSQL与大数据简介 NoSQL产生的原因
NoSQL产生的原因: 关系型数据库不擅长的操作,是NoSQL应运而生的原因: 大量的数据写入操作书上写的是“大量数据的写入操作“,我理解的应该是“大量的数据写入操作”,因为大量的数据写入操作才会引起 ...
- 《零起点,python大数据与量化交易》
<零起点,python大数据与量化交易>,这应该是国内第一部,关于python量化交易的书籍. 有出版社约稿,写本量化交易与大数据的书籍,因为好几年没写书了,再加上近期"前海智库 ...
- [转载] 使用 Twitter Storm 处理实时的大数据
转载自http://www.ibm.com/developerworks/cn/opensource/os-twitterstorm/ 流式处理大数据简介 Storm 是一个开源的.大数据处理系统,与 ...
- 大数据的前世今生【Hadoop、Spark】
一.大数据简介 大数据是一个很热门的话题,但它是什么时候开始兴起的呢? 大数据[big data]这个词最早在UNIX用户协会的会议上被使用,来自SGI公司的科学家在其文章“大数据与下一代基础架构 ...
- 保姆级教程,带你认识大数据,从0到1搭建 Hadoop 集群
大数据简介,概念部分 概念部分,建议之前没有任何大数据相关知识的朋友阅读 大数据概论 什么是大数据 大数据(Big Data)是指无法在一定时间范围内用常规软件工具进行捕捉.管理和处理的数据集合,是需 ...
- 【原创】大数据基础之Impala(1)简介、安装、使用
impala2.12 官方:http://impala.apache.org/ 一 简介 Apache Impala is the open source, native analytic datab ...
- 【原创】大数据基础之Benchmark(2)TPC-DS
tpc 官方:http://www.tpc.org/ 一 简介 The TPC is a non-profit corporation founded to define transaction pr ...
随机推荐
- cocos2dx 3.3 笔记
ccs3 加入了 rapidjson ->一个JSON解析库https://github.com/miloyip/rapidjson
- Hbase配置WEB UI界面
1 找到各个节点下面的Hbase-site.xml文件,添加如下配置 <property> <name>hbase.master.info.port</name> ...
- python 的基础 学习 第七天 is id 编码的补充
1,== 两个等号比较的是数值,is比较的是内存地址.print(id())查看的内存地址. 小数据池只存在于数字与字符串中,数字 是 -5^^256,是为了节省空间. 字符串1,如果含有特殊字符 ...
- css哪些属性可以继承
不可继承的:display.margin.border.padding.background.height.min-height.max- height.width.min-width.max-wid ...
- Centos 04 基础系统优化命令
在Linux这个系统当中,几乎所有的硬件设备文件都在/dev这个目录内.举例来说,IDE介面的硬盘的文件名称即为/dev/hd[a-d],其中, 括号内的字母为a-d当中的任意一个,亦即有/dev/h ...
- Shiro入门 - 通过ini文件进行认证
导入依赖 <dependency> <groupId>org.apache.shiro</groupId> <artifactId>shiro-core ...
- Java-Servlet--《12-WEB应用中的普通Java程序如何读取资源文件.mp4》 有疑问
\第五天-servlet开发和ServletConfig与ServletContext对象\12-WEB应用中的普通Java程序如何读取资源文件.mp4; 多层时,DAO为了得到资源文件中的配置参数: ...
- Builder搭建外置服务器
如何利用HBuilder快速设置外部web服务器来测试移动web HBuilder 关于HBuilder工具的简介:HBuilder是DCloud(数字天堂)推出的一款支持HTML5的Web开 ...
- 20165337实验三——敏捷开发与XP实践
实验要求 实验三-1 敏捷开发与XP实践 http://www.cnblogs.com/rocedu/p/4795776.html, Eclipse的内容替换成IDEA 参考 http://www.c ...
- yum upgrade和yum update的区别
Linux升级命令有两个分别是yum upgrade和yum update, 这个两个命令是有区别的: yum -y update 升级所有包同时也升级软件.系统版本和系统内核 yum -y upgr ...