
【集合框架】JDK1.8源码分析之TreeMap(五)
一、前言
当我们需要把插入的元素进行排序的时候,就是时候考虑TreeMap了,从名字上来看,TreeMap肯定是和树是脱不了干系的,它是一个排序了的Map,下面我们来着重分析其源码,理解其底层如何实现排序功能。下面,开始分析。
二、TreeMap示例
import java.util.TreeMap;

import java.util.Map;

public class TreeMapTest {

    public static void main(String[] args) {

        Map<String, String> maps = new TreeMap<String, String>();

        maps.put("aa", "aa");

        maps.put("cc", "cc");

        maps.put("bb", "bb");

        for (Map.Entry<String, String> entry : maps.entrySet()) {

            System.out.println(entry.getKey() + " : " + entry.getValue());

        }

    }

}
运行结果:
aa : aa
bb : bb
cc : cc
说明:从输出结果可以看到TreeMap对插入的元素进行了排序。
三、TreeMap数据结构
TreeMap底层使用的数据结构是红黑树,有印象的的读者,应该知道我们在分析HashMap的时候就已经接触到了红黑树结构,只是没有对红黑树进行详细的分析,现在,笔者也并不打算对红黑树做太过仔细的分析,因为笔者之后会出数据结构的专题(先挖个坑),到时候再来一睹各种数据结构的风采。

说明:上图为典型的红黑树结构,效率很高,具体的细节问题,我们以后详谈。
四、TreeMap源码分析
4.1 类的继承关系
public class TreeMap<K,V>

    extends AbstractMap<K,V>

    implements NavigableMap<K,V>, Cloneable, java.io.Serializable
说明:继承了抽象类AbstractMap,AbstractMap实现了Map接口,实现了部分方法。不能进行实例化,实现了NavigableMap,Cloneable,Serializable接口,其中NavigableMap是继承自SortedMap的接口,定义了一系列规范。
4.2 类的属性
public class TreeMap<K,V>

    extends AbstractMap<K,V>

    implements NavigableMap<K,V>, Cloneable, java.io.Serializable

{

    // 比较器,用于控制Map中的元素顺序

    private final Comparator<? super K> comparator;

    // 根节点

    private transient Entry<K,V> root;

    // 树中结点个数

    private transient int size = 0;

    // 对树进行结构性修改的次数

    private transient int modCount = 0;

}
说明:重点是比较器Comparator,此接口实现了对插入元素进行排序。
4.3 类的构造函数
1. TreeMap()型构造函数
public TreeMap() {

        // 无用户自定义比较器

        comparator = null;

    }
2. TreeMap(Comparator<? super K>)型构造函数
// 自定义了比较器

    public TreeMap(Comparator<? super K> comparator) {

        this.comparator = comparator;

    }
说明:用户自定义了比较器,可以按照用户的逻辑进行比较,确定元素的访问顺序。
3. TreeMap(Map<? extends K, ? extends V>)型构造函数
// 从已有map中构造TreeMap

    public TreeMap(Map<? extends K, ? extends V> m) {

        comparator = null;

        putAll(m);

    }
说明:根据已有的Map构造TreeMap。
4. TreeMap(SortedMap<K, ? extends V>)型构造函数
// 从SortedMap中构造TreeMap,有比较器

    public TreeMap(SortedMap<K, ? extends V> m) {

        comparator = m.comparator();

        try {

            buildFromSorted(m.size(), m.entrySet().iterator(), null, null);

        } catch (java.io.IOException cannotHappen) {

        } catch (ClassNotFoundException cannotHappen) {

        }

    }
说明:传入SortedMap型参数,实现SortedMap接口的类都会实现comparator方法,用于返回比较器。
4.4 核心函数分析
1. put函数
public V put(K key, V value) {

        // 记录根节点

        Entry<K,V> t = root;

        // 根节点为空

        if (t == null) {

            // 比较key

            compare(key, key); // type (and possibly null) check

            // 新生根节点

            root = new Entry<>(key, value, null);

            // 大小加1

            size = 1;

            // 修改次数加1

            modCount++;

            return null;

        }

        int cmp;

        Entry<K,V> parent;

        // 获取比较器

        Comparator<? super K> cpr = comparator;

        // 比较器不为空

        if (cpr != null) {

            // 找到元素合适的插入位置

            do {

                // parent赋值

                parent = t;

                // 比较key与元素的key值,在Comparator类的compare方法中可以实现我们自己的比较逻辑

                cmp = cpr.compare(key, t.key);

                // 小于结点key值,向左子树查找

                if (cmp < 0)

                    t = t.left;

                // 大于结点key值,向右子树查找

                else if (cmp > 0)

                    t = t.right;

                // 表示相等,直接更新结点的值

                else

                    return t.setValue(value);

            } while (t != null);

        }

        // 比较器为空

        else {

            // key为空,抛出异常

            if (key == null)

                throw new NullPointerException();

            @SuppressWarnings("unchecked")

                // 取得K实现的比较器

                Comparable<? super K> k = (Comparable<? super K>) key;

            // 寻找元素插入位置

            do {

                parent = t;

                cmp = k.compareTo(t.key);

                if (cmp < 0)

                    t = t.left;

                else if (cmp > 0)

                    t = t.right;

                else

                    return t.setValue(value);

            } while (t != null);

        }

        // 新生一个结点

        Entry<K,V> e = new Entry<>(key, value, parent);

        // 根据比较结果决定存为左结点或右结点

        if (cmp < 0)

            parent.left = e;

        else

            parent.right = e;

        // 插入后进行修正

        fixAfterInsertion(e);

        // 大小加1

        size++;

        // 进行了结构性修改

        modCount++;

        return null;

    }
说明:插入一个元素时,若用户自定义比较器,则会按照用户自定义的逻辑确定元素的插入位置,否则,将会使用K自身实现的比较器确定插入位置。
2. getEntry函数
final Entry<K,V> getEntry(Object key) {

        // 判断比较器是否为空

        if (comparator != null)

            // 根据自定义的比较器来返回结果

            return getEntryUsingComparator(key);

        // 比较器为空

        // key为空,抛出异常

        if (key == null)

            throw new NullPointerException();

        @SuppressWarnings("unchecked")

            // 取得K自身实现了比较接口

            Comparable<? super K> k = (Comparable<? super K>) key;

        Entry<K,V> p = root;

        // 根据Comparable接口的compareTo函数来查找元素

        while (p != null) {

            int cmp = k.compareTo(p.key);

            if (cmp < 0)

                p = p.left;

            else if (cmp > 0)

                p = p.right;

            else

                return p;

        }

        return null;

    }
说明:当我们调用get函数时,实际上是委托getEntry函数获取元素,对于用户自定义实现的Comparator比较器而言,是使用getEntryUsingComparator函数来完成获取逻辑。
具体代码如下
final Entry<K,V> getEntryUsingComparator(Object key) {

        @SuppressWarnings("unchecked")

            // 向下转型

            K k = (K) key;

        // 取得比较器

        Comparator<? super K> cpr = comparator;

        // 比较器不为空

        if (cpr != null) {

            Entry<K,V> p = root;

            // 开始遍历树节点找到对应的结点

            while (p != null) {

                int cmp = cpr.compare(k, p.key);

                // 小于结点key值,向左子树查找

                if (cmp < 0)

                    p = p.left;

                // 大于结点key值,向右子树查找

                else if (cmp > 0)

                    p = p.right;

                // 相等,找到,直接返回

                else

                    return p;

            }

        }

        return null;

    }
说明:会根据用户定义在compare函数里面的逻辑进行元素的查找。
3. deleteEntry函数
private void deleteEntry(Entry<K,V> p) {

        // 结构性修改

        modCount++;

        // 大小减1

        size--;

        // p的左右子结点均不为空

        if (p.left != null && p.right != null) {

            // 找到p结点的后继

            Entry<K,V> s = successor(p);

            // 将p的值用其后继结点的key-value替换,并且用s指向其后继

            p.key = s.key;

            p.value = s.value;

            p = s;

        }

        // 开始进行修正,具体的修正过程我们会在之后的数据结构专区进行讲解

        // 现在可以看成是为了保持红黑树的特性,提高性能

        Entry<K,V> replacement = (p.left != null ? p.left : p.right);

        if (replacement != null) {

            // Link replacement to parent

            replacement.parent = p.parent;

            if (p.parent == null)

                root = replacement;

            else if (p == p.parent.left)

                p.parent.left  = replacement;

            else

                p.parent.right = replacement;

            // Null out links so they are OK to use by fixAfterDeletion.

            p.left = p.right = p.parent = null;

            // Fix replacement

            if (p.color == BLACK)

                fixAfterDeletion(replacement);

        } else if (p.parent == null) { // return if we are the only node.

            root = null;

        } else { //  No children. Use self as phantom replacement and unlink.

            if (p.color == BLACK)

                fixAfterDeletion(p);

            if (p.parent != null) {

                if (p == p.parent.left)

                    p.parent.left = null;

                else if (p == p.parent.right)

                    p.parent.right = null;

                p.parent = null;

            }

        }

    }
说明:deleteEntry函数会在remove函数中被调用,它完成了移除元素的主要工作,删除该结点后会对红黑树进行修正,此部分内容以后会详细讲解,同时,在此函数中需要调用successor函数,即找到该结点的后继结点。具体函数代码如下
// 找到后继

    static <K,V> TreeMap.Entry<K,V> successor(Entry<K,V> t) {

        // t为null,直接返回null

        if (t == null)

            return null;

        // 右孩子不为空

        else if (t.right != null) {

            // 找到右孩子的最底层的左孩子,返回

            Entry<K,V> p = t.right;

            while (p.left != null)

                p = p.left;

            return p;

        } else { // 右孩子为空

            // 保存t的父节点

            Entry<K,V> p = t.parent;

            // 保存t结点

            Entry<K,V> ch = t;

            // 进行回溯,找到后继,直到p == null || ch != p.right

            while (p != null && ch == p.right) {

                ch = p;

                p = p.parent;

            }

            return p;

        }

    }
说明:当结点的右子树为空的时候,进行回溯可以找到该结点的后继结点。
五、问题扩展
1. 如何找到小于指定结点的最大结点?参考getLowerEntry函数源码
2. 如何找到大于指定结点的最小结点?参考getHigherEntry函数源码
对getLowerEntry源码分析如下
final Entry<K,V> getLowerEntry(K key) {

        // 保存根节点

        Entry<K,V> p = root;

        // 根节点不为空

        while (p != null) {

            // 比较该key与节点的key

            int cmp = compare(key, p.key);

            if (cmp > 0) { // 如果该key大于结点的key

                // 如果结点的右子树不为空,与该结点右结点进行比较

                if (p.right != null)

                    p = p.right;

                else // 右子树为空,则直接返回结点;因为此时已经没有比该结点key更大的结点了(右子树为空)

                    return p;

            } else { // 如果该key小于等于结点的key

                // 结点的左子树不为空,与该结点的左结点进行比较

                if (p.left != null) {

                    p = p.left;

                } else { // 结点的左子树不为空,则开始进行回溯

                    Entry<K,V> parent = p.parent;

                    Entry<K,V> ch = p;

                    while (parent != null && ch == parent.left) {

                        ch = parent;

                        parent = parent.parent;

                    }

                    return parent;

                }

            }

        }

        return null;

    }
流程图如下:
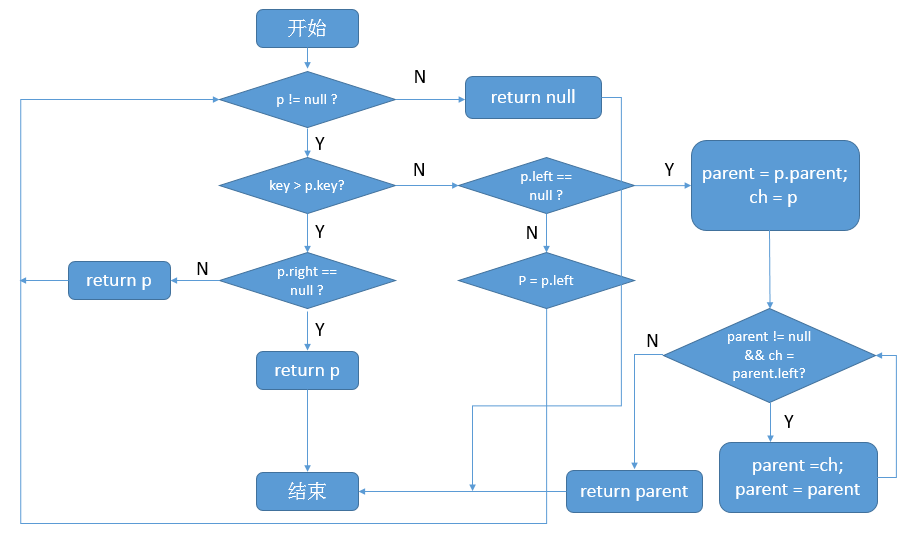
getHigherEntry则可以以此类推。
六、总结
由TreeMap我们可以知道其底层的数据结构为红黑树,并且可以使用用户自定义的比较器来实现比较逻辑。对于其核心函数的分析就到此为止了,谢谢各位园友的观看~
【集合框架】JDK1.8源码分析之TreeMap(五)的更多相关文章
- 【集合框架】JDK1.8源码分析之HashMap(一) 转载
[集合框架]JDK1.8源码分析之HashMap(一) 一.前言 在分析jdk1.8后的HashMap源码时,发现网上好多分析都是基于之前的jdk,而Java8的HashMap对之前做了较大的优化 ...
- 【集合框架】JDK1.8源码分析之ArrayList详解(一)
[集合框架]JDK1.8源码分析之ArrayList详解(一) 一. 从ArrayList字表面推测 ArrayList类的命名是由Array和List单词组合而成,Array的中文意思是数组,Lis ...
- 【集合框架】JDK1.8源码分析之Collections && Arrays(十)
一.前言 整个集合框架的常用类我们已经分析完成了,但是还有两个工具类我们还没有进行分析.可以说,这两个工具类对于我们操作集合时相当有用,下面进行分析. 二.Collections源码分析 2.1 类的 ...
- 【集合框架】JDK1.8源码分析HashSet && LinkedHashSet(八)
一.前言 分析完了List的两个主要类之后,我们来分析Set接口下的类,HashSet和LinkedHashSet,其实,在分析完HashMap与LinkedHashMap之后,再来分析HashSet ...
- 集合之TreeSet(含JDK1.8源码分析)
一.前言 前面分析了Set接口下的hashSet和linkedHashSet,下面接着来看treeSet,treeSet的底层实现是基于treeMap的. 四个关注点在treeSet上的答案 二.tr ...
- 集合之LinkedHashSet(含JDK1.8源码分析)
一.前言 上篇已经分析了Set接口下HashSet,我们发现其操作都是基于hashMap的,接下来看LinkedHashSet,其底层实现都是基于linkedHashMap的. 二.linkedHas ...
- 集合之HashSet(含JDK1.8源码分析)
一.前言 我们已经分析了List接口下的ArrayList和LinkedList,以及Map接口下的HashMap.LinkedHashMap.TreeMap,接下来看的是Set接口下HashSet和 ...
- 【JUC】JDK1.8源码分析之ArrayBlockingQueue(三)
一.前言 在完成Map下的并发集合后,现在来分析ArrayBlockingQueue,ArrayBlockingQueue可以用作一个阻塞型队列,支持多任务并发操作,有了之前看源码的积累,再看Arra ...
- Java集合系列[4]----LinkedHashMap源码分析
这篇文章我们开始分析LinkedHashMap的源码,LinkedHashMap继承了HashMap,也就是说LinkedHashMap是在HashMap的基础上扩展而来的,因此在看LinkedHas ...
随机推荐
- 在页面使用js回车键
网上有大量的文章关于 js回车事件的,但是只有适合自己的才是最好的. 第一种: // submit closest form $(".keydown_submit").keydow ...
- Sort简单排序
List<T> 类型排序: public List<ProductionMaterialModel> OrderBybom(List<ProductionMaterial ...
- 用FlexGrid做开发,轻松处理百万级表格数据
表格数据处理是我们项目开发中经常会遇到的设计需求之一,所需处理的数据量也较大,通常是万级.甚至百万级.此时,完全依赖平台自带的表格工具,往往无法加载如此大的数据量,或者加载得很慢影响程序执行. 那么, ...
- OAuth2 Backend Web Application 验证过程
本文是从我的 github 博客转载的,原文请看. 一图胜千言.图片请自由转载,请保留图片的原始签名.
- ZooKeeper典型应用场景
ZooKeeper典型应用场景一览 数据发布与订阅(配置中心) 发布与订阅模型,即所谓的配置中心,顾名思义就是发布者将数据发布到ZK节点上,供订阅者动态获取数据,实现配置信息的集中式管理和动态更新.例 ...
- web应用中使用JavaMail发送邮件
现在很多的网站都提供有用户注册功能, 通常我们注册成功之后就会收到一封来自注册网站的邮件.邮件里面的内容可能包含了我们的注册的用户名和密码以及一个激活账户的超链接等信息.今天我们也来实现一个这样的功能 ...
- js中的块作用域
今天我们来一起研究下JavaScript中的变量作用域问题,话不多说,直接上代码. <script type="text/javascript"> (function( ...
- KnockoutJS 3.X API 第七章 其他技术(7) 微任务
注意:本文档适用于Knockout 3.4.0及更高版本. Knockout的微任务队列 Knockout的微任务队列支持调度任务尽可能快地运行,同时仍然是异步的,努力安排它们在发生I / O,回流或 ...
- 使用paramiko如何连接服务器?
本文和大家分享的是python开发中使用paramiko连接服务器的方法和步骤,希望通过本文的,对大家学习和使用paramiko有所帮助. ssh连接步骤 1.ssh server建立server p ...
- Sql Server系列:自定义函数
用户自定义函数可以像系统函数一样在查询或存储过程中调用,可以接受参数.执行操作并将操作结果以值的形式返回.返回值可以是单个标量或结果集. 1. 标量函数 标量函数返回一个确定类型的标量值,对于多语句的 ...