
xpath-房价爬取
xpath
xpath两种使用方式
和bs类似,一种是调用本地资源,一种是网络资源
etree.parse(filePath)
etree.HTML('page_text')
xpath表达式
层级:/一个层级 //多个层级 (注意如果从html开始取,要在前面加一个/ 写成/html,局部./li)
属性定位:类似//div[@class='zx']
索引取值: 类似p[3](注意xpath中的索引,是从1开始的)
取文本:/text()直系 //text()取所有
取属性:类似/@src
xpath实战
功能:爬取安居客某区域所有的房价信息,最终以条形图的方式显示
import requests

from lxml import etree

import matplotlib.pyplot as plt

headers = {

    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36"

}

all_price=[]

def work(count):

    page=1

    while page<=count:

        url=f"https://hangzhou.anjuke.com/sale/yuhang-q-hzpingyao/p{page}/#filtersort"

        res=requests.get(url=url,headers=headers).text

        tree=etree.HTML(res)

        all_house=tree.xpath("//div[@class='sale-left']/ul/li")

        for i in all_house:

            #截取有效的价格

            price=i.xpath("./div[@class='pro-price']/span[2]/text()")[0][:-4]

            price=int(price)

            #价格添加到list中

            all_price.append(price)

            print(price)

        page+=1

    print(all_price)

def show():

    #画图

    plt.hist(all_price, bins=50)

    plt.show()

    print(len(all_price))

if __name__ == '__main__':

    #爬取25页

    work(25)

    show()
如图
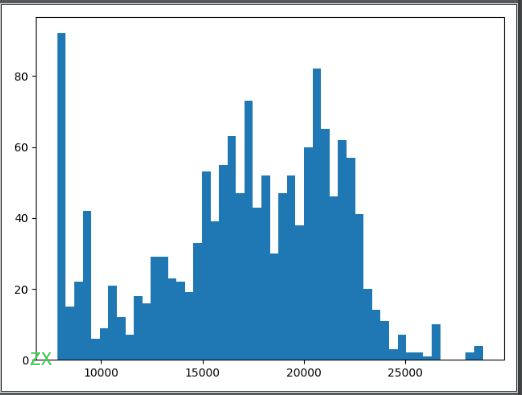
但是安居客有部分数据感觉并不可靠
xpath-房价爬取的更多相关文章
- requests+xpath+map爬取百度贴吧
# requests+xpath+map爬取百度贴吧 # 目标内容:跟帖用户名,跟帖内容,跟帖时间 # 分解: # requests获取网页 # xpath提取内容 # map实现多线程爬虫 impo ...
- 一起学爬虫——使用xpath库爬取猫眼电影国内票房榜
之前分享了一篇使用requests库爬取豆瓣电影250的文章,今天继续分享使用xpath爬取猫眼电影热播口碑榜 XPATH语法 XPATH(XML Path Language)是一门用于从XML文件中 ...
- 【个人】爬虫实践,利用xpath方式爬取数据之爬取虾米音乐排行榜
实验网站:虾米音乐排行榜 网站地址:http://www.xiami.com/chart 难度系数:★☆☆☆☆ 依赖库:request.lxml的etree (安装lxml:pip install ...
- Java - XPath解析爬取内容
code { margin: 0; padding: 0; white-space: pre; border: none; background: transparent; } pre { backg ...
- Scrapy中用xpath/css爬取豆瓣电影Top250:解决403HTTP status code is not handled or not allowed
好吧,我又开始折腾豆瓣电影top250了,只是想试试各种方法,看看哪一种的方法效率是最好的,一直进行到这一步才知道 scrapy的强大,尤其是和selector结合之后,速度飞起.... 下面我就采用 ...
- Python 2.7_利用xpath语法爬取豆瓣图书top250信息_20170129
大年初二,忙完家里一些事,顺带有人交流爬取豆瓣图书top250 1.构造urls列表 urls=['https://book.douban.com/top250?start={}'.format(st ...
- python3通过Beautif和XPath分别爬取“小猪短租-北京”租房信息,并对比时间效率(附源代码)
爬虫思路分析: 1. 观察小猪短租(北京)的网页 首页:http://www.xiaozhu.com/?utm_source=baidu&utm_medium=cpc&utm_term ...
- xpath+多进程爬取网易云音乐热歌榜。
用到的工具,外链转换工具 网易云网站直接打开源代码里面并没有对应的歌曲信息,需要对url做处理, 查看网站源代码路径:发现把里面的#号去掉会显示所有内容, 右键打开的源代码路径:view-source ...
- 使用Xpath+多进程爬取诗词名句网的史书典籍类所有文章。update~
上次写了爬取这个网站的程序,有一些地方不完善,而且爬取速度较慢,今天完善一下并开启多进程爬取,速度就像坐火箭.. # 需要的库 from lxml import etree import reques ...
- python+xpath+requests爬取维基百科历史上的今天
import requests import urllib.parse import datetime from lxml import etree fhout = open("result ...
随机推荐
- 初始bat命令
任务:manven打包的jar包以及相关的bat文件,要将其设置为开机自启动. bat :批处理文件,通过简单的命令行方式对windows进行操作. 简单的bat命令: 1echo 显示命令,@带着个 ...
- 利用Python迭代器查找最小值和最大值
迭代器的用法为for...in.... 迭代器如同for循环,可以遍历所有的值,但我们熟悉的的语言,都是通过下标完成的,python的循环程度要高于C语言的循环,因为python的迭代不止可以用在Li ...
- CSP2019知识点整理
也算是接下来二十天的复习计划吧 仅止于联赛难度左右 基础算法 字符串 char[] cstring memset() 输入无& gets(), fgets(stdin, ,); strcmp, ...
- 学习笔记23_AspMVC项目
*创建AspMVC项目 (1)会自动创建App_Data文件夹,是用户不能访问和下载的.一般用户能访问那些文件夹,可以在IIS中配置. (2)App_Start文件夹,用于放置与程序有关的配置文件. ...
- [考试反思]1107csp-s模拟测试104: 速度
20分钟能做什么? 不粘排行榜,没意义,第一机房集体重启,我侥幸找回了两个文件才有分. 实际得分应该是70+100+60,第二机房rank1...放在第一机房就不知道了 T1:中间值 比较喜欢题解的第 ...
- LeetCode刷题总结-数组篇(下)
本期讲O(n)类型问题,共14题.3道简单题,9道中等题,2道困难题.数组篇共归纳总结了50题,本篇是数组篇的最后一篇.其他三个篇章可参考: LeetCode刷题总结-数组篇(上),子数组问题(共17 ...
- DAY 3 数论专场
2019-07-23 今天的题目一个比一个神仙,很早之前就在讨论今天是不是晚上回宾馆就没脑子了,后来发现,是中午.... 一上午就讲了一个PPT,然而标题就两个子---数论... 这谁顶的住....整 ...
- Kubernetes3-kubectl管理Kubernetes容器平台-2
一.kubectl管理集群中deployment资源与service服务 1.相关参数 kubectl edit 编辑服务器侧资源 kubectl replace 替换,使用 yaml 配置文件来替换 ...
- 更新linux时候提示“由于没有公钥,无法验证下列签名".
本文链接:https://blog.csdn.net/loovejava/article/details/21837935 新安装的Ubuntu在使用sudo apt-get update更新源码的时 ...
- supervisord进程管理
一:简介 supervisord是一个进程管理工具,提供web页面管理,能对进程进行自动重启等操作. 优点: - 可以将非后台运行程序后台运行 - 自动监控,重启进程 缺点: - 不能管理后台运行程序 ...