
Python 信息提取-爬虫
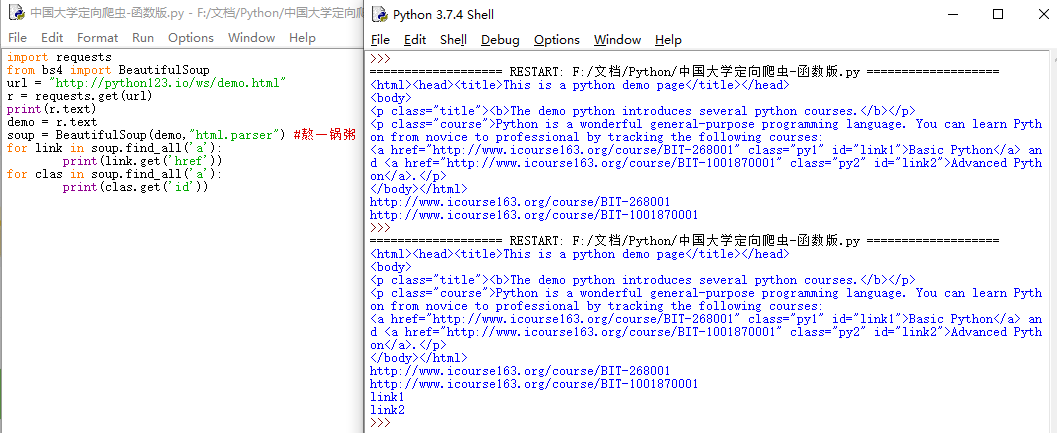
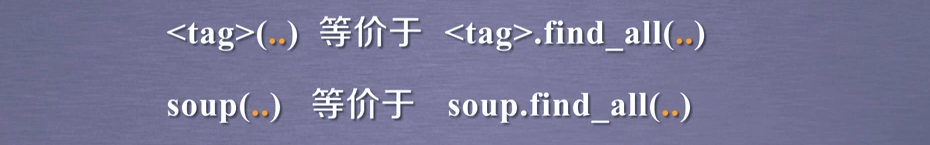

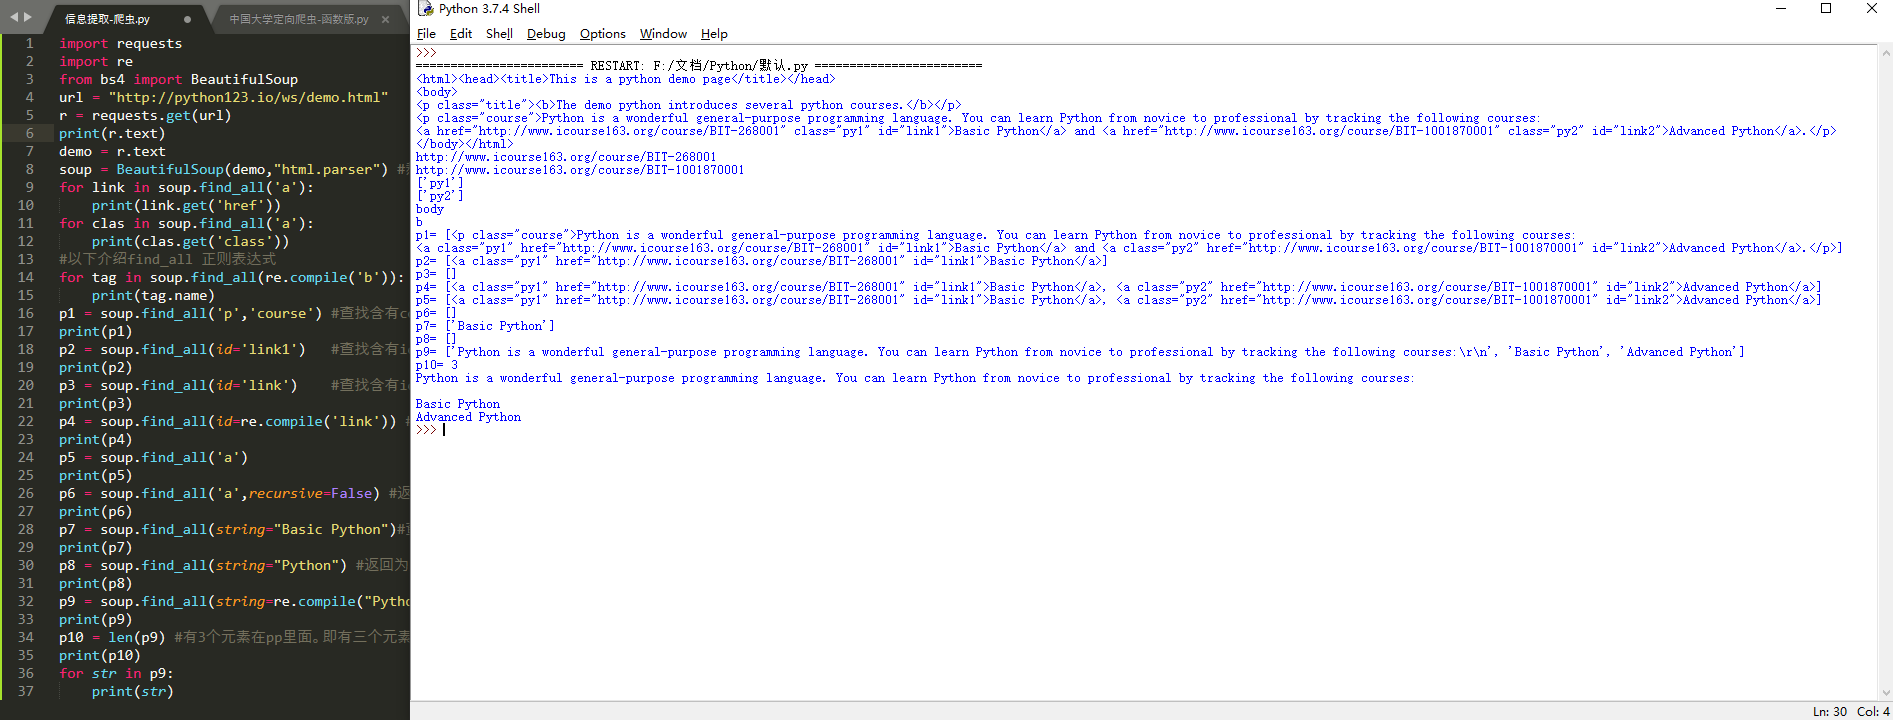
import requests

import re

from bs4 import BeautifulSoup

url = "http://python123.io/ws/demo.html"

r = requests.get(url)

print(r.text)

demo = r.text

soup = BeautifulSoup(demo,"html.parser") #熬一锅粥

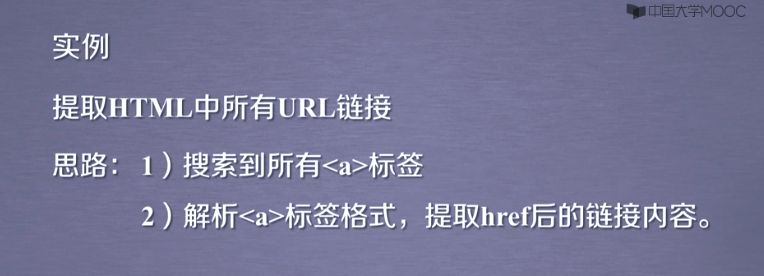
for link in soup.find_all('a'):

    print(link.get('href'))

for clas in soup.find_all('a'):

    print(clas.get('class'))

#以下介绍find_all 正则表达式

for tag in soup.find_all(re.compile('b')): #查找所有以b开头的标签,第一个属性

    print(tag.name)

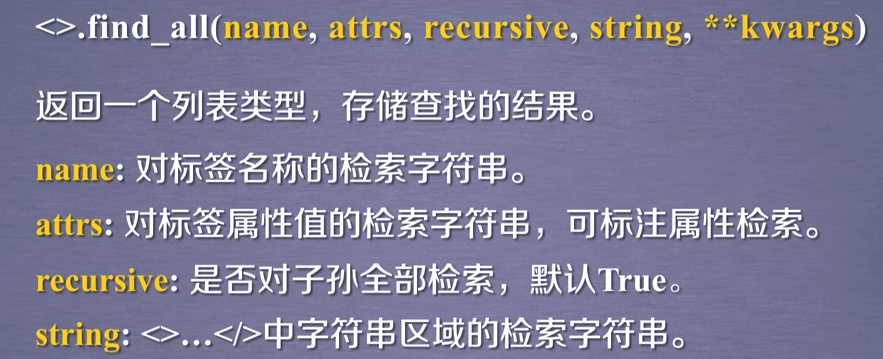
p1 = soup.find_all('p','course') #查找含有course的p标签内容

print(p1)

p2 = soup.find_all(id='link1')   #查找含有id='link1'属性的标签内容,注意:属性不等于文本

print(p2)

p3 = soup.find_all(id='link')    #查找含有id='link'属性的标签内容,没有,所以返回未空,即[]

print(p3)

p4 = soup.find_all(id=re.compile('link')) #使用正则表达式查找id属性含有link的内容

print(p4)

p5 = soup.find_all('a')                    #返回不为空,说明soup的子孙节点含有a标签

print(p5)

p6 = soup.find_all('a',recursive=False) #返回为空,说明soup的子节点无a标签

print(p6)

p7 = soup.find_all(string="Basic Python")#查找正文为且仅为Basic Python的元素

print(p7)

p8 = soup.find_all(string="Python") #返回为空

print(p8)

p9 = soup.find_all(string=re.compile("Python")) #正则表达式查找含有Python的元素,返回列表类型

print(p9)

p10 = len(p9) #有3个元素在pp里面。即有三个元素含Python

print(p10)

for str in p9:

    print(str)
Python 信息提取-爬虫的更多相关文章
- Python网络爬虫与信息提取
1.Requests库入门 Requests安装 用管理员身份打开命令提示符: pip install requests 测试:打开IDLE: >>> import requests ...
- 第3次作业-MOOC学习笔记:Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 4.提供图片或网站显示的学习进 ...
- 第三次作业-Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 过程. 5.写一篇不少于100 ...
- 第三次作业-MOOC学习笔记:Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 第一周 Requests库的爬 ...
- Python网络爬虫与信息提取笔记
直接复制粘贴笔记发现有问题 文档下载地址//download.csdn.net/download/hide_on_rush/12266493 掌握定向网络数据爬取和网页解析的基本能力常用的 Pytho ...
- 基于Scrapy框架的Python新闻爬虫
概述 该项目是基于Scrapy框架的Python新闻爬虫,能够爬取网易,搜狐,凤凰和澎湃网站上的新闻,将标题,内容,评论,时间等内容整理并保存到本地 详细 代码下载:http://www.demoda ...
- Python简单爬虫入门三
我们继续研究BeautifulSoup分类打印输出 Python简单爬虫入门一 Python简单爬虫入门二 前两部主要讲述我们如何用BeautifulSoup怎去抓取网页信息以及获取相应的图片标题等信 ...
- Ubuntu下配置python完成爬虫任务(笔记一)
Ubuntu下配置python完成爬虫任务(笔记一) 目标: 作为一个.NET汪,是时候去学习一下Linux下的操作了.为此选择了python来边学习Linux,边学python,熟能生巧嘛. 前期目 ...
- Python简单爬虫入门二
接着上一次爬虫我们继续研究BeautifulSoup Python简单爬虫入门一 上一次我们爬虫我们已经成功的爬下了网页的源代码,那么这一次我们将继续来写怎么抓去具体想要的元素 首先回顾以下我们Bea ...
随机推荐
- 设计模式(八)Abstract Factory模式
抽象工厂的工作是将“抽象零件”组装为“抽象产品”.在抽象工厂模式中将会出现抽象工厂,它会将抽象零件组装为抽象产品.也就是说,我们并不关心零件的具体实现,而是只关心接口.我们仅适用该接口将零件组装起来成 ...
- requests+lxml+xpath爬取豆瓣电影
(1)lxml解析html from lxml import etree #创建一个html对象 html=stree.HTML(text) result=etree.tostring(html,en ...
- 在jupyter中调用R
目录 安装R 关联jupyter notebook 安装R 系统:Ubuntu:16.04 步骤1.添加镜像源 $ sudo echo "deb http://cran.rstudio.co ...
- Java中的substring()用法
String str = "Hello Java World!"; Method1: substring(int beginIndex) 返回从起始位置(beginIndex)至 ...
- 认识JVM的内存分配
当我们在JVM中运行一段程序代码,JVM初始运行的时候都会分配好Method Area(方法区)和Heap(堆),而JVM每遇到一个线程,就为其分配一个Program Counter Register ...
- java中Arrays.sort()对二位数组进行排序
int [][]a = new int [5][2]; //定义一个二维数组,其中所包含的一维数组具有两个元素 对于一个已定义的二位数组a经行如下规则排序,首先按照每一个对应的一维数组第一个元素进行升 ...
- Java8系列 (七) CompletableFuture异步编程
概述 Java8之前用 Future 处理异步请求, 当你需要获取任务结果时, 通常的做法是调用 get(long timeout, TimeUnit unit) 此方法会阻塞当前的线程, 如果任务 ...
- 程序员接私活经验总结,来自csdn论坛语录
以下为网上摘录,以做笔记: 可是到网上看看,似乎接私活也有很多不容易,技术问题本身是个因素,还有很多有技术的人接私活时被骗,或者是合作到最后以失败告终,所以想请有经验的大侠们出来指点一下,接私活是怎么 ...
- MIT线性代数:21.特征值和特征向量
- 轰炸行动(bomb):tarjan,拓扑排序
考场上看错题,没什么好说的. 然而它就是一个大板子. 发的题解勉强还能看.但是我还想再讲讲. 题目的表述是,如果从A能直接或间接到B,那么就不能同时轰炸A和B. 那么我们从图里随便拽出一条有向路径,从 ...