
爬虫框架之Scrapy(四 ImagePipeline)
ImagePipeline
使用scrapy框架我们除了要下载文本,还有可能需要下载图片,scrapy提供了ImagePipeline来进行图片的下载。
ImagePipeline还支持以下特别的功能:
1 生成缩略图:通过配置IMAGES_THUMBS = {'size_name': (width_size,heigh_size),}
2 过滤小图片:通过配置IMAGES_MIN_HEIGHT和IMAGES_MIN_WIDTH来过滤过小的图片。
具体其他功能可以看下参考官网手册:https://docs.scrapy.org/en/latest/topics/media-pipeline.html.
ImagePipelines的工作流程
1 在spider中爬取需要下载的图片链接,将其放入item中的image_urls.
2 spider将其传送到pipieline
3 当ImagePipeline处理时,它会检测是否有image_urls字段,如果有的话,会将url传递给scrapy调度器和下载器
4 下载完成后会将结果写入item的另一个字段images,images包含了图片的本地路径,图片校验,和图片的url。
示例 爬取巴士lol的英雄美图
只爬第一页

第一步:items.py
import scrapy

class Happy4Item(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    image_urls = scrapy.Field()

    images = scrapy.Field()
爬虫文件lol.py
# -*- coding: utf-8 -*-

import scrapy

from happy4.items import Happy4Item

class LolSpider(scrapy.Spider):

    name = 'lol'

    allowed_domains = ['lol.tgbus.com']

    start_urls = ['http://lol.tgbus.com/tu/yxmt/']

    def parse(self, response):

        li_list = response.xpath('//div[@class="list cf mb30"]/ul//li')

        for one_li in li_list:

            item = Happy4Item()

            item['image_urls'] =one_li.xpath('./a/img/@src').extract()

            yield item
最后 settings.py
BOT_NAME = 'happy4'

SPIDER_MODULES = ['happy4.spiders']

NEWSPIDER_MODULE = 'happy4.spiders'

# Crawl responsibly by identifying yourself (and your website) on the user-agent

USER_AGENT = 'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0'

# Obey robots.txt rules

ROBOTSTXT_OBEY = False

ITEM_PIPELINES = {

   'scrapy.pipelines.images.ImagesPipeline': 1,

}

IMAGES_STORE = 'images'
不需要操作管道文件,就可以爬去图片到本地
极大的减少了代码量.
注意:因为图片管道会尝试将所有图片都转换成JPG格式的,你看源代码的话也会发现图片管道中文件名类型直接写死为JPG的。所以如果想要保存原始类型的图片,就应该使用文件管道。
示例 爬取mm131美女图片
要求爬取的就是这个网站

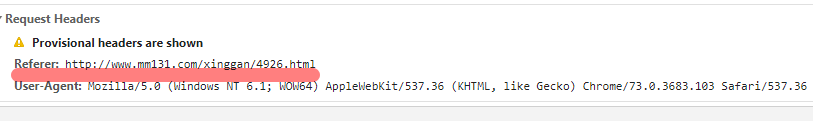
这个网站是有反爬的,当你直接去下载一个图片的时候,你会发现url被重新指向了别处,或者有可能是直接报错302,这是因为它使用了referer这个请求头里的字段,当你打开一个图片的url的时候,你的请求头里必须有referer,不然就会被识别为爬虫文件,禁止你的爬取,那么如何解决呢?
手动在爬取每个图片的时候添加referer字段。
xingan.py
# -*- coding: utf-8 -*-

import scrapy

from happy5.items import Happy5Item

import re

class XinganSpider(scrapy.Spider):

    name = 'xingan'

    allowed_domains = ['www.mm131.com']

    start_urls = ['http://www.mm131.com/xinggan/']

    def parse(self, response):

        every_html = response.xpath('//div[@class="main"]/dl//dd')

        for one_html in every_html[0:-1]:

            item = Happy5Item()

            # 每个图片的链接

            link = one_html.xpath('./a/@href').extract_first()

            # 每个图片的名字

            title = one_html.xpath('./a/img/@alt').extract_first()

            item['title'] = title

            # 进入到每个标题里面

            request = scrapy.Request(url=link, callback=self.parse_one, meta={'item':item})

            yield request

    # 每个人下面的图集

    def parse_one(self, response):

        item = response.meta['item']

        # 找到总页数

        total_page = response.xpath('//div[@class="content-page"]/span[@class="page-ch"]/text()').extract_first()

        num = int(re.findall('(\d+)', total_page)[0])

        # 找到当前页数

        now_num = response.xpath('//div[@class="content-page"]/span[@class="page_now"]/text()').extract_first()

        now_num = int(now_num)

        # 当前页图片的url

        every_pic = response.xpath('//div[@class="content-pic"]/a/img/@src').extract()

        # 当前页的图片url

        item['image_urls'] = every_pic

        # 当前图片的refer

        item['referer'] = response.url

        yield item

        # 如果当前数小于总页数

        if now_num < num:

            if now_num == 1:

                url1 = response.url[0:-5] + '_%d'%(now_num+1) + '.html'

            elif now_num > 1:

                url1 = re.sub('_(\d+)', '_' + str(now_num+1), response.url)

            headers = {

                'referer':self.start_urls[0]

            }

            # 给下一页发送请求

            yield scrapy.Request(url=url1, headers=headers, callback=self.parse_one, meta={'item':item})
items.py
import scrapy

class Happy5Item(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    image_urls = scrapy.Field()

    images = scrapy.Field()

    title = scrapy.Field()

    referer = scrapy.Field()
pipelines.py
from scrapy.pipelines.images import ImagesPipeline

from scrapy.exceptions import DropItem

from scrapy.http import Request

class Happy5Pipeline(object):

    def process_item(self, item, spider):

        return item

class QiushiImagePipeline(ImagesPipeline):

    # 下载图片时加入referer请求头

    def get_media_requests(self, item, info):

        for image_url in item['image_urls']:

            headers = {'referer':item['referer']}

            yield Request(image_url, meta={'item': item}, headers=headers)

            # 这里把item传过去,因为后面需要用item里面的书名和章节作为文件名

    # 获取图片的下载结果, 控制台查看

    def item_completed(self, results, item, info):

        image_paths = [x['path'] for ok, x in results if ok]

        if not image_paths:

            raise DropItem("Item contains no images")

        return item

    # 修改文件的命名和路径

    def file_path(self, request, response=None, info=None):

        item = request.meta['item']

        image_guid = request.url.split('/')[-1]

        filename = './{}/{}'.format(item['title'], image_guid)

        return filename
settings.py
BOT_NAME = 'happy5'

SPIDER_MODULES = ['happy5.spiders']

NEWSPIDER_MODULE = 'happy5.spiders'

# Crawl responsibly by identifying yourself (and your website) on the user-agent

USER_AGENT = 'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0'

# Obey robots.txt rules

ROBOTSTXT_OBEY = False

ITEM_PIPELINES = {

   # 'scrapy.pipelines.images.ImagesPipeline': 1,

   'happy5.pipelines.QiushiImagePipeline': 2,

}

IMAGES_STORE = 'images'
得到图片文件:
这种图还是要少看。
爬虫框架之Scrapy(四 ImagePipeline)的更多相关文章
- Scrapy爬虫框架教程(四)-- 抓取AJAX异步加载网页
欢迎关注博主主页,学习python视频资源,还有大量免费python经典文章 sklearn实战-乳腺癌细胞数据挖掘 https://study.163.com/course/introduction ...
- 06 爬虫框架:scrapy
爬虫框架:scrapy 一 介绍 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前S ...
- Python-S9-Day125-Web微信&爬虫框架之scrapy
01 今日内容概要 02 内容回顾:爬虫 03 内容回顾:网络和并发编程 04 Web微信之获取联系人列表 05 Web微信之发送消息 06 为什么request.POST拿不到数据 07 到底使用j ...
- 九、爬虫框架之Scrapy
爬虫框架之Scrapy 一.介绍 二.安装 三.命令行工具 四.项目结构以及爬虫应用简介 五.Spiders 六.Selectors 七.Items 八.Item Pipelin 九. Dowload ...
- Golang 网络爬虫框架gocolly/colly 四
Golang 网络爬虫框架gocolly/colly 四 爬虫靠演技,表演得越像浏览器,抓取数据越容易,这是我多年爬虫经验的感悟.回顾下个人的爬虫经历,共分三个阶段:第一阶段,09年左右开始接触爬虫, ...
- 爬虫框架之Scrapy
一.介绍 二.安装 三.命令行工具 四.项目结构以及爬虫应用简介 五.Spiders 六.Selectors 七.Items 八.Item Pipelin 九. Dowloader Middeware ...
- 洗礼灵魂,修炼python(72)--爬虫篇—爬虫框架:Scrapy
题外话: 前面学了那么多,相信你已经对python很了解了,对爬虫也很有见解了,然后本来的计划是这样的:(请忽略编号和日期,这个是不定数,我在更博会随时改的) 上面截图的是我的草稿 然后当我开始写博文 ...
- 爬虫框架:scrapy
一 介绍 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前Scrapy的用途十分广泛,可 ...
- 爬虫框架之Scrapy(一)
scrapy简介 scrapy是一个用python实现为了爬取网站数据,提取结构性数据而编写的应用框架,功能非常的强大. scrapy常应用在包括数据挖掘,信息处理或者储存历史数据的一系列程序中. s ...
随机推荐
- Javascript 设计模式 单例
转载请标明出处:http://blog.csdn.net/lmj623565791/article/details/30490955 一直很喜欢Js,,,今天写一个Js的单例模式实现以及用法. 1.单 ...
- Python爬虫-尝试使用人工和OCR处理验证码模拟登入
刚开始在网上看别人一直在说知乎登入首页有有倒立的汉字验证码,我打开自己的知乎登入页面,发现只有账号和密码,他们说的倒立的验证码去哪了,后面仔细一想我之前登入过知乎,应该在本地存在cookies,然后我 ...
- 关于crontab命令
crontab命令 crontab命令常见于Unix和类Unix的操作系统之中,用于设置周期性被执行的指令.该命令从标准输入设备读取指令,并将其存放于"crontab"文件中,以供 ...
- java equals和tostring
Object类概述 是所有类中的父类,最大的超类,所有的类都继承他. equals方法 比较2个对象是否相同,其实他是在比较两个对象的地址是否相同,在equals方法中我们用==来判断 但是比较2个地 ...
- bzoj 4916: 神犇和蒟蒻 (杜教筛+莫比乌斯反演)
题目大意: 读入n. 第一行输出“1”(不带引号). 第二行输出$\sum_{i=1}^n i\phi(i)$. 题解: 所以说那个$\sum\mu$是在开玩笑么=.= 设$f(n)=n\phi(n) ...
- CentOS7 安装Redis 单机版
1,下载Redis4.0.9 进入Redis中文网的下载页面 http://www.redis.cn/download.html 2,上传压缩包到linux系统 cd /user/local/java ...
- 如何在ST官网下载STM32固件库
1.首先要注册一个ST账号,下载的时候需要. 2.找到工具与软件 3.进去之后选"产品列表" 4.在产品列表里选STM32微控制器软件,直接点下图标号2,不要点左边的加号 5.进去 ...
- 【h5+c3】web前端实战项目、快装webapp手机案例源码
快装WebApp项目(Web移动端开发案例)webapp移动端项目源码.html5+css3实战案例分享.微信端H5实例开发 简介快装WebApp是一个面向移动端的快速装修app,此项目为手机端:使用 ...
- 微信jssdk config:invalid signature 签名错误 ,问题排查过程
invalid signature签名错误.建议按如下顺序检查: 确认签名算法正确,可用 http://mp.weixin.qq.com/debug/cgi-bin/sandbox?t=jsapisi ...
- 开发 chrome 扩展 GitHub-Remarks 的一些想法以及遗憾
前文 对于单页应用中如何监听 URL 变化的思考 说到我在开发 chrome 扩展 GitHub Remarks 中遇到的一个问题,本文来聊聊开发这个扩展的前后心路历程. 为什么开发这个扩展?前文说到 ...