
Databricks 第11篇:Spark SQL 查询(行转列、列转行、Lateral View、排序)
本文分享在Azure Databricks中如何实现行转列和列转行。
一,行转列
在分组中,把每个分组中的某一列的数据连接在一起:
- collect_list:把一个分组中的列合成为数组,数据不去重,格式是['a','a','b']
- collect_set:把一个分组中的列合成为集合,数据去重,格式是['a','b']
用于连接文本数组的函数,通过sep把数组中的item分割开,连接成一个字符串:
concat_ws(sep, [str | array(str)]+)
举个例子,把每个用户的game,通过逗号连接起来:
select uid

 ,concat_ws(",",collect_list(game)) as game_list

from user_game
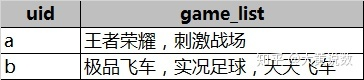
二,列转行
Explode(expr) 用于处理array和map结构的数据,把一行的列值转换成多行,该函数产生一个虚拟表,包含一行或多行数据,也就是说,Explode(expr)函数把array类型expr中的元素分成多行,或者将map类型的expr中的元素分成多行和多列。
举个例子,把game_list中的每个item转换为一行数据:
with cte_game as

(

  select uid

    ,collect_list(game) as game_list

  from user_game
  group by uid

)

select uid

  ,explode(game_list) as game

from cte_game
三,Lateral View子句
Lateral View子句用于连接表值函数(UDTF),比如explode、split 。Lateral View通过UDTF函数把数据拆分成多行,再把多行结果组合成一个虚拟表。
该子句主要解决的问题是:在select使用UDTF做查询的过程中,该查询只能包含单个UDTF,不能包含其它字段以及多个UDTF的情况。
LATERAL VIEW udtf(expression) tableAlias AS columnAlias (',' columnAlias)
使用LATERAL VIEW + explode 函数进行查询,语句如下:
select movie,category_name

from movie_info

LATERAL VIEW explode(category) tmpTable as category_name;

-- category_name 是给 explode(category) 列起的别名
四,排序
在SELECT子句中,ORDER BY子句用于保证最终数据的顺序,除此之外,还可以按照分区来排序。
[ WITH with_query [ , ... ] ]

select_statement[ ORDER BY { expression [ ASC | DESC ] [ NULLS { FIRST | LAST } ] [ , ... ] } ]

  [ SORT BY { expression [ ASC | DESC ] [ NULLS { FIRST | LAST } ] [ , ... ] } ]

  [ CLUSTER BY { expression [ , ... ] } ]

  [ DISTRIBUTE BY { expression [, ... ] } ]

  [ WINDOW { named_window [ , WINDOW named_window, ... ] } ]
1,DISTRIBUTE BY子句
根据输入表达式对表进行重新分区,
DISTRIBUTE BY { expression [ , ... ] }
举个例子,把age相同的person作为同一个cluster(或partition)。
SELECT age, name FROM person DISTRIBUTE BY age;
2,SORT BY子句
在每个分区中,按照指定的顺序对每个分区内的数据进行排序,如果分区不止一个,那么SORT BY可能会返回部分排序的结果。
SORT BY { expression [ sort_direction | nulls_sort_order ] [ , ... ] }
参数注释:
nulls_sort_order 的有效值是 NULLS { FIRST | LAST },可选,用于指定在非NULL值之前/之后是否返回NULL值。
如果未指定null_sort_order,则如果排序顺序为ASC,则NULL排在最前面,如果排序顺序为DESC,则NULL排在最后面。
- 如果指定了NULLS FIRST,则无论排序顺序如何,都将首先返回NULL值。
- 如果指定了NULLS LAST,则无论排序顺序如何,最后都会返回NULL值。
举个例子,按照name对每个分区中的数据进行排序:
SELECT /*+ REPARTITION(zip_code) */ name, age, zip_code FROM person

    SORT BY name ASC, age DESC;
3,CLUSTER BY子句
根据输入表达式对数据进行重新分区,然后对每个分区内的数据进行排序。从语义上讲,这等效于先执行DISTRIBUTE BY,再执行SORT BY。该子句仅确保结果行在每个分区内排序,并且不保证输出的总顺序。
CLUSTER BY { expression [ , ... ] }
举个例子,按照age把person分区,age相同的person位于同一个分区,然后按照age对每个分区中的person进行排序。
SELECT age, name FROM person CLUSTER BY age;
参考文档:
SQL reference for Databricks Runtime 7.x
Databricks 第11篇:Spark SQL 查询(行转列、列转行、Lateral View、排序)的更多相关文章
- 大数据技术之_19_Spark学习_03_Spark SQL 应用解析 + Spark SQL 概述、解析 、数据源、实战 + 执行 Spark SQL 查询 + JDBC/ODBC 服务器
第1章 Spark SQL 概述1.1 什么是 Spark SQL1.2 RDD vs DataFrames vs DataSet1.2.1 RDD1.2.2 DataFrame1.2.3 DataS ...
- 2. 执行Spark SQL查询
2.1 命令行查询流程 打开Spark shell 例子:查询大于21岁的用户 创建如下JSON文件,注意JSON的格式: {"name":"Michael"} ...
- spark sql 查询hive表并写入到PG中
import java.sql.DriverManager import java.util.Properties import com.zhaopin.tools.{DateUtils, TextU ...
- SQL数据单条转多条(Lateral View)
Lateral View和split,explode等UDTF一起使用,它能够将一行数据拆成多行数据,并在此基础上对拆分后的数据进行聚合. 单个Lateral View语句语法定义如下:lateral ...
- Entity Framework 第四篇 优化SQL查询
Expression<Func<TEntity, bool>>与Func<TEntity, bool>的异同 public IList<TEntity> ...
- sql查询行转列
昨天下午碰到一个需求,一个大约30万行的表,其中有很多重复行,在这些行中某些字段值是不重复的. 比如有ID,NAME,CONTRACT_id,SALES,PRODUCT等,除了PRODUCT字段,其余 ...
- SQL多行转多列
--★转换结果如上图 1.首先创建表: CREATE TABLE [成绩表]( ,) NOT NULL, )NULL, , )NULL, , )NULL, , )NULL ) ON [PRIMARY] ...
- SQL查询结果增加序号列
--sql 2000 ) ,学号 ,姓名 from tb t --sql 2005 select 序号 = row_number() over(order by 学号),学号 ,姓名 from tb ...
- sql 查询表格中多列重复的数据并显示该表的其他列
我们一般情况下通过分组函数group by来查询重复的列 ) R 但是查询出的结果不能显示该表的其他列 想要查询一张表中有多个列重复的数据且也要显示该表的其他列 SELECT M.* FROM [db ...
随机推荐
- M8 E147 不可能为条目*确立账户
今天用BAPI做发票校验, BAPI_INCOMINGINVOICE_CREATE这个函数使用都正常,可是突然就无法做发票检验了 报了个错误,"不可能为条目BOXT TR 确立账户" ...
- 07--Docker安装Redis
1.拉取redis:3.2 docker pull redis:3.2 2.创建redis容器 docker run -p 6379:6379 -v /zhengcj/myredis/data:/da ...
- 1、kubernetes简介
Kubernetes简介 文档信息 中文官网:https://kubernetes.io/zh 中文社区:https://www.kubernetes.org.cn/ Kubernetes是容器集群管 ...
- Bagging和Boosting的介绍及对比
"团结就是力量"这句老话很好地表达了机器学习领域中强大「集成方法」的基本思想.总的来说,许多机器学习竞赛(包括 Kaggle)中最优秀的解决方案所采用的集成方法都建立在一个这样的假 ...
- CentOS7 通过snat进行上网
需求: 有两台服务器,一台绑定了弹性公网IP,另外一台没有,需要内网服务器通过有弹性ip的机器代理进行上网. 环境: centos7 操作系统 服务器A: 192.168.0.18 (可以上网,有弹性 ...
- 京东零售mockRpc实践
https://mp.weixin.qq.com/s/A0T6ySub0DfQiXJAbWm2Qg jsf协议是基于tcp的而且对数据进行了序列化.加密等操作,直接截获的方式很难实现.最后决定注入自己 ...
- 《Effective C#》之减少装箱和拆箱
<Effective C#>之减少装箱和拆箱_天极网 http://dev.yesky.com/msdn/359/3486359.shtml <Effective C#>之减少 ...
- 正则re高级用法
search 需求:匹配出文章阅读的次数 #coding=utf-8 import re ret = re.search(r"\d+", "阅读次数为 9999" ...
- springBoot controller入参LocalDateTime
@JsonFormat(shape = JsonFormat.Shape.STRING, pattern="yyyy-MM-dd HH:mm:ss") @DateTimeForma ...
- 服务注册中心:Eureka
第一章 注册中心介绍 1.1.什么是注册中心 注册中心可以说是微服务架构中的"通讯录",它记录了服务和服务地址的映射关系.在分布式系统中,服务会注册到这里,当服务需要调用其它服务时 ...