
[Spark News] Spark + GPU are the next generation technology
一、资源:Spark进行机器学习,支持GPU
From:https://my.oschina.net/u/2306127/blog/1602291
为了使用Spark进行机器学习,支持GPU是必须的,上层再运行神经网络引擎。
目前AWS\GCP和Databricks的云都已经支持GPU的机器学习,AliYun也在实验之中。
这包括几个层次:
- GPU直接支持Spark。因为Spark是多线程的,而GPU往往只能起一个单例,导致线程会竞争GPU资源,需要进行管理、加锁和调度。方法包括:
- 原生代码内置编译支持。
- 引入cuDNN等NVidia库进行调用。
- 通过Tensorflow等间接进行支持。
- JIT方式即时编译调用方式支持。
- GPU支持的Docker中运行Spark。如果将Spark节点放入Docker容器中运行,则需要使用NVidia提供的特殊版本Docker,而且需要安装NVidai提供的cuDNN等软件支持库。由于这些库调用了系统驱动,而且是C++编写,因此Spark要能够进行系统库的调用。
- GPU支持的Kubernetes之上运行Spark。
- 在上面的基础上,支持GPU的Docker容器需要能够接受Kubernetes的管理和调度。
- 参考:https://my.oschina.net/u/2306127/blog/1808304
只有同时满足上面的条件,才能通过Kubernetes的集群管理对Docker中Spark进行GPU操作。
下面是已经做的一些研究。
- IBMSparkGPU 的方案可以将GPU用于RDD和DataFrame,支持通用计算,重点支持机器学习;
- deeplearning4j 是基于Java的,包含数值计算和神经网络,支持GPU;
- NUMBA 的方案通过PySpark即时编译产生GPU的调用代码,兼容性好;
- Tensorflow/Caffe/MXNet等与Spark整合主要是节点调度,GPU由深度学习引擎调度,RDD需要数据交换,主要用于存储中间超参数数据。如TensorFrame的实现-https://github.com/databricks/tensorframes
Reference
- https://github.com/databricks/spark-deep-learning,Deep Learning Pipelines for Apache Spark,直接支持Images的一些功能。
- http://www.spark.tc/simd-and-gpu/, Spark多种支持GPU方法。
- http://www.spark.tc/gpu-acceleration-on-apache-spark-2/,GPU扩展
- https://my.oschina.net/u/2306127/blog/1602295,同上。
- http://www.spark.tc/0-to-life-changing-app-new-apache-systemml-api-on-spark-shell/,systemML在Spark中使用。
- Continuum-Anaconda,NUMBA: A PYTHON JIT COMPILER,http://on-demand.gputechconf.com/gtc/2016/presentation/s6413-stanley-seibert-apache-spark-python.pdf
- http://spark.tc/why-you-should-be-using-apache-systemml-2/,关于SystemML。
- 基于Java的神经网络深度学习系列库(支持GPU,https://deeplearning4j.org/),https://github.com/deeplearning4j
- https://github.com/IBMSparkGPU,源码:https://github.com/IBMSparkGPU/GPUEnabler
- Spark Summit 2016 Talk by Jun Feng Liu (IBM) and Yonggang Hu (IBM)
- Hadoop, Spark, Deep Learning Mesh on Single GPU Cluster,https://www.nextplatform.com/2016/02/24/hadoop-spark-deep-learning-mesh-on-single-gpu-cluster/
- IBM,关于GPU RDD的讨论,http://on-demand.gputechconf.com/gtc/2016/presentation/s6280-rajesh-bordawekar-accelerating-spark.pdf
- GPU Computing with Apache Spark and Python,http://on-demand.gputechconf.com/gtc/2016/presentation/s6413-stanley-seibert-apache-spark-python.pdf
- Spark ML Runs 10x Faster on GPUs, Databricks Says。https://www.datanami.com/2016/10/27/spark-ml-runs-faster-gpus/
二、在笔记本上实现Spark-GPU集群开发教程
From: https://www.jdon.com/bigdata/spark-gpu.html
第1部分:Spark-Notebook
选择Scala:完整的Spark API;GPU库允许我无需编写编译C代码而直接使用Java (这样从scala调用Java)。
Zeppelin -> buggy API
Spark-Notebook -> 导入依赖很头疼
Sparknotebook -> 就选择这个了,杀手级应用
下面是从Sparknotebook 仓储Clone下载一份,按照其指引操作,比如下载IScala.jar等等。
第2部分:在JVM上GPU
灵感来自于一个令人印象深刻的库包 ScalaNLP。 他们声称有一个解析器,可以在一台计算机上每分钟解析一百万字。
Aparapi出现的原因。 它编译Java代码到OpenCL,如果不能获得一个GPU则使用Java线程池运行。
第3部分:整合Spark和笔记本中Aparapi
真正的挑战是让这些工具相互调用。 集成的第一步,我们需要做的就是aparapi jar导入iscala笔记本。
第4部分:在笔记本(仅使用Scala)构建案例
第5部分:在Spark 集群执行GPU内核
下面是Spark运行在笔记本上的内核上示意图:
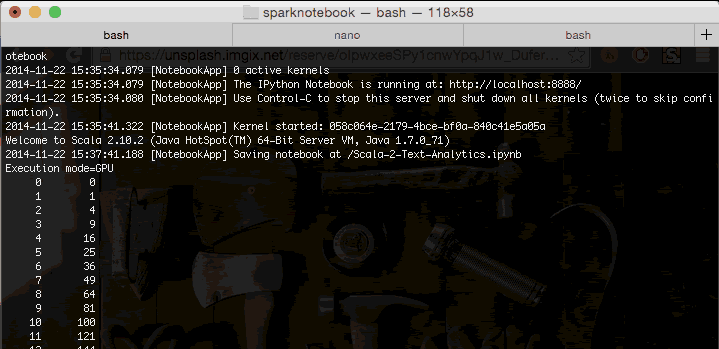
程序日志记录出现GPU…显示它确实是被运行在GPU。
但问题在于深度学习必须使用cuda,还是cuda才是正道。
/* implement */
[Spark News] Spark + GPU are the next generation technology的更多相关文章
- 【转】科普Spark,Spark是什么,如何使用Spark
本博文是转自如下链接,为了方便自己查阅学习和他人交流.感谢原博主的提供! http://www.aboutyun.com/thread-6849-1-1.html http://www.aboutyu ...
- 科普Spark,Spark核心是什么,如何使用Spark(1)
科普Spark,Spark是什么,如何使用Spark(1)转自:http://www.aboutyun.com/thread-6849-1-1.html 阅读本文章可以带着下面问题:1.Spark基于 ...
- Spark之 spark简介、生态圈详解
来源:http://www.cnblogs.com/shishanyuan/p/4700615.html 1.简介 1.1 Spark简介Spark是加州大学伯克利分校AMP实验室(Algorithm ...
- 科普Spark,Spark是什么,如何使用Spark
科普Spark,Spark是什么,如何使用Spark 1.Spark基于什么算法的分布式计算(很简单) 2.Spark与MapReduce不同在什么地方 3.Spark为什么比Hadoop灵活 4.S ...
- Spark Shell & Spark submit
Spark 的 shell 是一个强大的交互式数据分析工具. 1. 搭建Spark 2. 两个目录下面有可执行文件: bin 包含spark-shell 和 spark-submit sbin 包含 ...
- Spark:使用Spark Shell的两个示例
Spark:使用Spark Shell的两个示例 Python 行数统计 ** 注意: **使用的是Hadoop的HDFS作为持久层,需要先配置Hadoop 命令行代码 # pyspark >& ...
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
- [Spark][Python]spark 从 avro 文件获取 Dataframe 的例子
[Spark][Python]spark 从 avro 文件获取 Dataframe 的例子 从如下地址获取文件: https://github.com/databricks/spark-avro/r ...
- [Spark][Python]Spark 访问 mysql , 生成 dataframe 的例子:
[Spark][Python]Spark 访问 mysql , 生成 dataframe 的例子: mydf001=sqlContext.read.format("jdbc").o ...
随机推荐
- Linux学习笔记(三)Linux常用命令:链接命令和文件查找命令
一.链接命令 ln -s [原文件] [目标文件] (link) -s意为创建软连接 硬链接和软连接 硬链接的特点: (1)拥有相同的 i 结点和block块,可以看作是同一个文件 (2)可以通过 i ...
- Hadoop_18_MapRduce 内部的shuffle机制
1.Mapreduce的shuffle机制: Mapreduce中,map阶段处理的数据如何传递给Reduce阶段,是mapreduce框架中最关键的一个流程,这个流程就叫shuffle 将mapta ...
- JAVA8初探-让方法参数具备行为能力并引入Lambda表达式
关于JAVA8学习的意义先来贴一下某网站上的对它的简单介绍:“Java 8可谓Java语言历史上变化最大的一个版本,其承诺要调整Java编程向着函数式风格迈进,这有助于编写出更为简洁.表达力更强,并且 ...
- jenkins 配置主从机制(master-slaver)
1. 中文:系统管理——节点管理——新建节点(左上侧) 英文:Manage Jenkins——Manage Node——新建节点(左上侧) 2. 中文配图 英文配图: 3. 远程工作目录 以mac为例 ...
- summernote 富文本编辑器限制输入字符长度
项目中需要一个比较简单的富文本编辑器,于是选中了summernote .虽然比较轻量,但是在开发中也遇到了几个问题,在此记录一下. 1:样式和bootstrap冲突,初始化之后显示为: .note-e ...
- 前端知识体系:JavaScript基础-变量和类型
前端工程师自检清单 1. JavaScript规定了几种语言类型 2. JavaScript对象的底层数据结构是什么 3. Symbol类型在实际开发中的应用.可手动实现一个简单的 Symbo 4. ...
- Jquery 前端解码base64出现中文乱码的问题解决方案
<script src="../static/js/jquery.base64.js"></script> <script src="../ ...
- elementUI el-date-picker 时间范围设置 固定时间段可选 配置
https://blog.csdn.net/sinat_37255207/article/details/91793889 <el-date-picker v-model="start ...
- 题解 [51nod1274] 最长递增路径
题面 解析 这题一眼DP啊. 然而想了半天毫无思路. 后来看题解后发现可以按边权的大小顺序DP. 将边权从小到大排序,对于权值相同的边分为一组. 设\(f[i][0]\)表示经过当前权值的边后到达\( ...
- 【Wince-截图】对Wince进行截图
对Wince进行截图 方法一 使用Wince桌面助手对Wince进行截图 PC通过USB成功连接到手持机 打开Wince桌面助手CERHOST.exe程序 File->Capture进行截图 C ...