
PYTHON之爬虫学习(一)基础
关于python爬虫,大家都很熟悉,那么我就不多说,开始做了。
首先,python爬虫先安装python库,主要是requests库,在windows中cmd中输入,pip install requests ,之后会自动安装。
之后再python IDLE 中输入import requests 无报错说明安装正确。
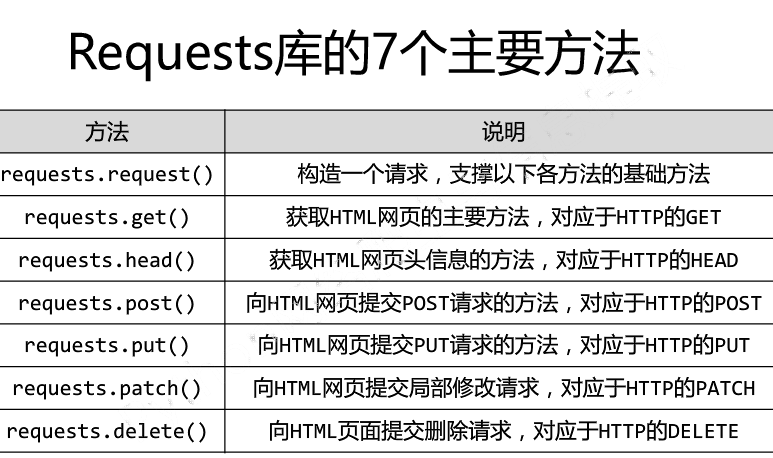
下面试试爬取百度页面:
最简单的方式
import requests

r=requests.get("http://www.baidu.com")

print(r.text)
返回的结果:
<!DOCTYPE html> <!--STATUS OK--><html> <head>
<meta http-equiv=content-type content=text/html;charset=utf-8><meta http-equiv=X-UA-Compatible content=IE=Edge> <meta content=always name=referrer><link rel=stylesheet type=text/css href=http://s1.bdstatic.com/r/www/cache/bdorz/baidu.min.css>
<title>ç¾åº¦ä¸ä¸ï¼ä½ å°±ç¥é</title></head> <body link=#0000cc>
<div id=wrapper> <div id=head> <div class=head_wrapper> <div class=s_form>
<div class=s_form_wrapper> <div id=lg> <img hidefocus=true src=//www.baidu.com/img/bd_logo1.png width=270 height=129> </div>
<form id=form name=f action=//www.baidu.com/s class=fm> <input type=hidden name=bdorz_come value=1>
<input type=hidden name=ie value=utf-8> <input type=hidden name=f value=8>
<input type=hidden name=rsv_bp value=1> <input type=hidden name=rsv_idx value=1>
<input type=hidden name=tn value=baidu><span class="bg s_ipt_wr"><input id=kw name=wd class=s_ipt value maxlength=255 autocomplete=off autofocus>
</span><span class="bg s_btn_wr"><input type=submit id=su value=ç¾åº¦ä¸ä¸ class="bg s_btn"></span> </form>
</div> </div> <div id=u1> <a href=http://news.baidu.com name=tj_trnews class=mnav>æ°é»</a>
<a href=http://www.hao123.com name=tj_trhao123 class=mnav>hao123</a>
<a href=http://map.baidu.com name=tj_trmap class=mnav>å°å¾</a> <a href=http://v.baidu.com name=tj_trvideo class=mnav>è§é¢</a>
<a href=http://tieba.baidu.com name=tj_trtieba class=mnav>è´´å§</a>
<noscript> <a href=http://www.baidu.com/bdorz/login.gif?login&tpl=mn&u=http%3A%2F%2Fwww.baidu.com%2f%3fbdorz_come%3d1 name=tj_login class=lb>ç»å½</a>
</noscript> <script>document.write('<a href="http://www.baidu.com/bdorz/login.gif?login&tpl=mn&u='+ encodeURIComponent(window.location.href+ (window.location.search === "" ? "?" : "&")+ "bdorz_come=1")+ '" name="tj_login" class="lb">ç»å½</a>');</script> <a href=//www.baidu.com/more/ name=tj_briicon class=bri style="display: block;">æ´å¤äº§å</a> </div> </div> </div> <div id=ftCon> <div id=ftConw> <p id=lh> <a href=http://home.baidu.com>å ³äºç¾åº¦</a> <a href=http://ir.baidu.com>About Baidu</a> </p> <p id=cp>©2017 Baidu <a href=http://www.baidu.com/duty/>使ç¨ç¾åº¦åå¿ è¯»</a> <a href=http://jianyi.baidu.com/ class=cp-feedback>æè§åé¦</a> 京ICPè¯030173å· <img src=//www.baidu.com/img/gs.gif> </p> </div> </div> </div> </body> </html>
返回页面的所有代码
PYTHON之爬虫学习(一)基础的更多相关文章
- python网络爬虫学习笔记
python网络爬虫学习笔记 By 钟桓 9月 4 2014 更新日期:9月 4 2014 文章文件夹 1. 介绍: 2. 从简单语句中開始: 3. 传送数据给server 4. HTTP头-描写叙述 ...
- Python网络爬虫学习总结
1.检查robots.txt 让爬虫了解爬取该网站时存在哪些限制. 最小化爬虫被封禁的可能,而且还能发现和网站结构相关的线索. 2.检查网站地图(robots.txt文件中发现的Sitemap文件) ...
- Python网络爬虫学习手记(1)——爬虫基础
1.爬虫基本概念 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本.--------百度百科 简单的说,爬 ...
- python之爬虫学习记录与心得
之前在寒假的时候,学习了python基础.在慕课网上看的python入门:http://www.imooc.com/learn/177 python进阶:http://www.imooc.com/le ...
- python网络爬虫学习笔记(二)BeautifulSoup库
Beautiful Soup库也称为beautiful4库.bs4库,它可用于解析HTML/XML,并将所有文件.字符串转换为'utf-8'编码.HTML/XML文档是与“标签树一一对应的.具体地说, ...
- python网络爬虫学习笔记(一)Request库
一.Requests库的基本说明 引入Rquests库的代码如下 import requests 库中支持REQUEST, GET, HEAD, POST, PUT, PATCH, DELETE共7个 ...
- Python scrapy爬虫学习笔记01
1.scrapy 新建项目 scrapy startproject 项目名称 2.spiders编写(以爬取163北京新闻为例) 此例中用到了scrapy的Itemloader机制,itemloade ...
- python网络爬虫学习
网络爬虫 Requests官方中文教程地址:http://docs.python-requests.org/zh_CN/latest/user/quickstart.html Beautiful So ...
- python beautifulsoup爬虫学习
BeautifulSoup(page_html, "lxml").select(),这里可以通过浏览器开发者模式选择copy selector,并且并不需要完整路径. github ...
随机推荐
- Java多线程学习(四)等待/通知(wait/notify)机制
转载请备注地址:https://blog.csdn.net/qq_34337272/article/details/79690279 系列文章传送门: Java多线程学习(一)Java多线程入门 Ja ...
- Python模块学习 - click
Click模块 click模块是Flask的作者开发的一个第三方模块,用于快速创建命令行.它的作用与Python标准库的argparse相同,但是,使用起来更简单. click是一个第三方库,因此使用 ...
- 工具安装===Sublime Text-安装
Sublime Text 是一款通用型轻量级编辑器,支持多种编程语言.有许多功能强大的快捷键(如 Ctrl+d),支持丰富的插件扩展.如果平时需要在不同编程语言间切换,那么它将会是一个,不错的选择. ...
- RemoteBox 1.6 发布,VirtualBox 管理工具
RemoteBox 1.6 发布,VirtualBox 管理工具 http://www.lupaworld.com/article-230113-1.html 安装VirtualBox Extensi ...
- Chrome控制台的妙用之使用XPATH
谷歌浏览器,对于作为程序员的我们来说可以是居家必备了,应该用的相当的熟悉了,我们用的最多的应该是network选项吧,一般用来分析网页加载的请求信息,比如post参数之类的,这些基本的功能基本上够用了 ...
- C中级 数据序列化简单使用和讨论 (二)
引言 - 一种更好的方式 其实不管什么语言, 开发框架都会遇到序列化问题. 序列化可以理解为A 和 B 交互的一种协议. 很久以前利用 printf 和 scanf 的协议实现过一套序列化问题. C ...
- JDBC数据源连接池(3)---Tomcat集成DBCP
此文续<JDBC数据源连接池(2)---C3P0>. Apache Tomcat作为一款JavaWeb服务器,内置了DBCP数据源连接池.在使用中,只要进行相应配置即可. 首先,确保Web ...
- java中的构造方法与其作用
什么是构造方法呢? 方法名和类名相同 没有返回值类型,连void都不能写 没有具体的返回值 构造方法分为无参构造方法与有参构造方法. 先来看一下最简单的无参构造方法: Student.java pac ...
- LeetCode解题报告—— Swap Nodes in Pairs & Divide Two Integers & Next Permutation
1. Swap Nodes in Pairs Given a linked list, swap every two adjacent nodes and return its head. For e ...
- Storm实战常见的问题
该文档为实实在在的原创文档,转载请注明: http://blog.sina.com.cn/s/blog_8c243ea30101k0k1.html 类型 详细 备注 该文档是群里几个朋友在storm实 ...