
Sqoop(四)增量导入、全量导入、减量导入
增量导入
一、说明
当在生产环境中,我们可能会定期从与业务相关的关系型数据库向Hadoop导入数据,导入数仓后进行后续离线分析。这种情况下我们不可能将所有数据重新再导入一遍,所以此时需要数据增量导入。
增量导入数据分为两种方式:
一是基于递增列的增量数据导入(Append方式)。
二是基于时间列的数据增量导入(LastModified方式)。
二、增量导入
方式一:Append方式
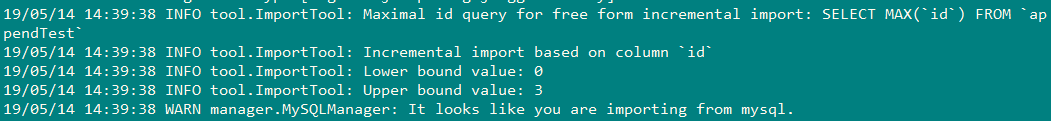
比如:有一个订单表,里面每个订单有一个唯一标识自增列ID,在关系型数据库中以主键形式存在,之前已经将id在1-3的编号的订单导入到了Hive中,现在一段时间后我们需要将近期产生的新的订单数据(id为4、5的两条数据)导入Hive,供后续数仓进行分析。此时我们只需要指定-incremental参数为append,-last-value参数为3即可。表示只从大于3后开始导入。
1、MYSQL建表
CREATE TABLE `appendTest` (

  `id` int(11) ,

  `name` varchar(255)

)
2、导入数据
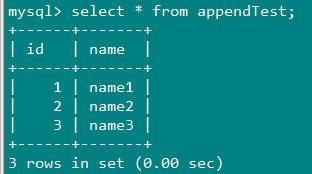
insert into appendTest(id,name) values(1,'name1');

insert into appendTest(id,name) values(2,'name2');

insert into appendTest(id,name) values(3,'name3');
3、创建一张跟mysql中的appendTest表一样的hive表appendTest
sqoop create-hive-table \

--connect jdbc:mysql://192.168.200.100:3306/yang \

--username root \

--password 010209 \

--table appendTest \

--hive-table appendTest
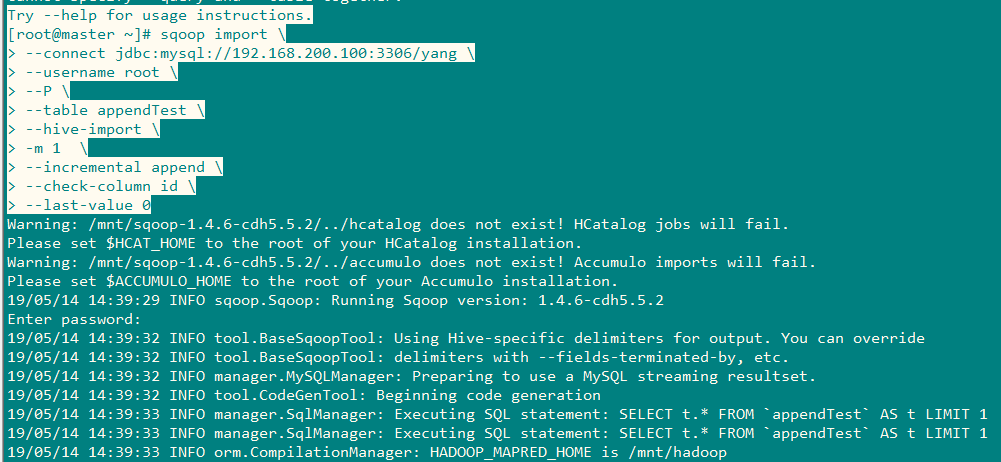
4、进行导入,将id>0的三条数据进行导入
sqoop import \

--connect jdbc:mysql://192.168.200.100:3306/yang \

--username root \

--P \

--table appendTest \

--hive-import \

-m 1  \
--hive-table appendTest \

--incremental append \

--check-column id \

--last-value 0
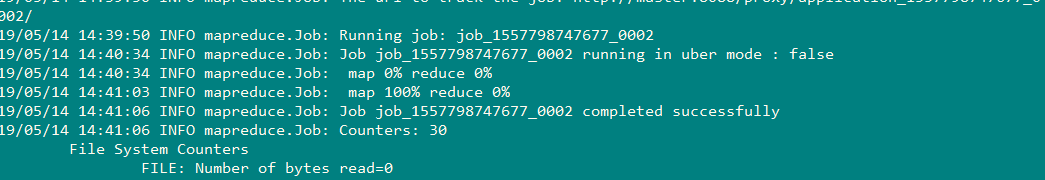
结果:
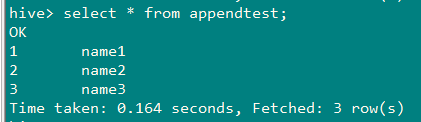
5、查看
6、向mysql表appendTest再次插入数据
insert into appendTest(id,name) values(4,'name4');
insert into appendTest(id,name) values(5,'name5');
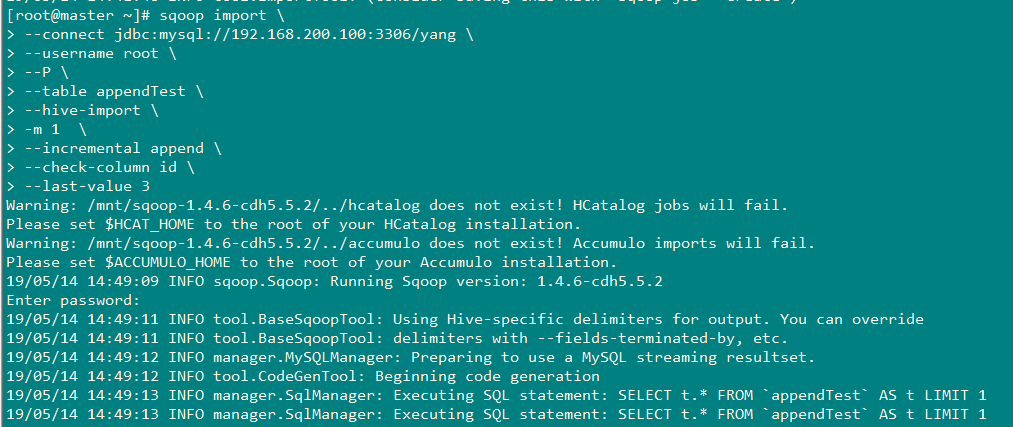
7、再次执行增量导入
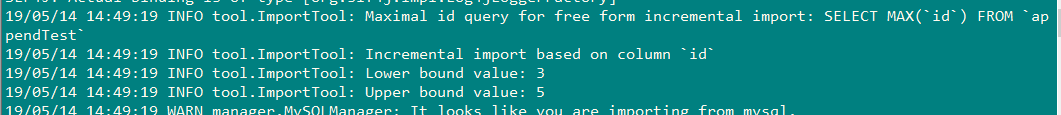
由于上一次导入的时候,,将--last-value设置为0,将id>0的三条数据导入后,现在进行导入了时候需要将last-value设置为3
sqoop import \

--connect jdbc:mysql://192.168.200.100:3306/yang \

--username root \

--P \

--table appendTest \

--hive-import \

-m 1  \
--hive-table appendTest \

--incremental append \

--check-column id \

--last-value 3
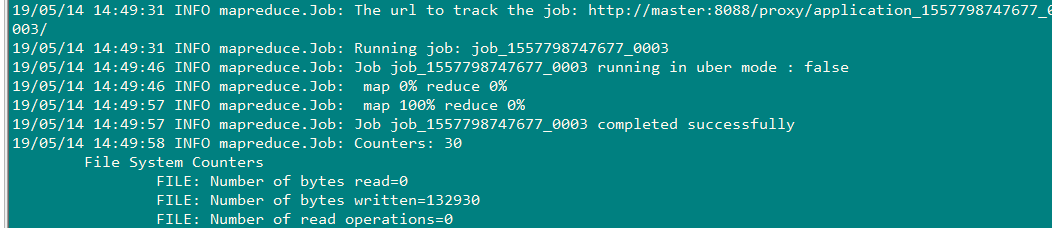
结果:
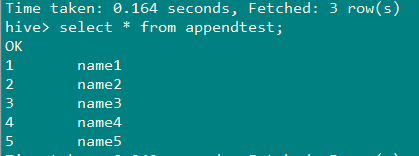
8、查看hive表appendTest
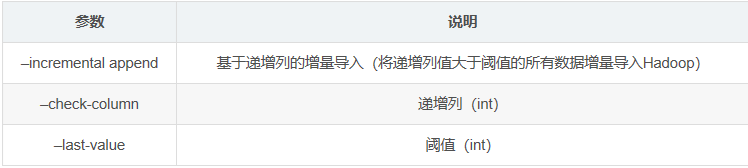
重要参数说明:
9、说明
说明:
增量抽取,需要指定--incremental append,同时指定按照源表中哪个字段进行增量--check-column id,
并指定hive表appendTest当前最大值--last-value 3。创建sqoop job的目的是,每次执行job以后,sqoop会自动记录appedndTest的last-value,
下次再执行时,就会自动指定last-value,不需要手工去改了。
方式二:lastModify方式
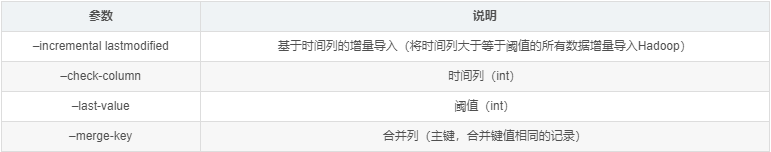
基于lastModify的方式,要求原表中有time字段,它能指定一个时间戳,让SQoop把该时间戳之后的数据导入至Hive,因为后续订单可能状态会发生变化,变化后time字段时间戳也会发生变化,此时SQoop依然会将相同状态更改后的订单导入Hive,当然我们可以指定merge-key参数为id,表示将后续新的记录与原有记录合并。
1、Mysql建表
CREATE TABLE lastModifyTest (

id INT,

name VARCHAR (20),

last_mod TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP

);
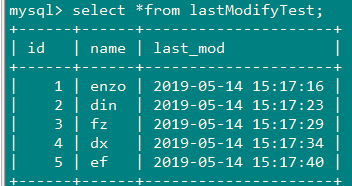
2、导入数据
insert into lastModifyTest(id,name) values(1,'enzo');

insert into lastModifyTest(id,name) values(2,'din');

insert into lastModifyTest(id,name) values(3,'fz');

insert into lastModifyTest(id,name) values(4,'dx');

insert into lastModifyTest(id,name) values(5,'ef');
3、HIve建表
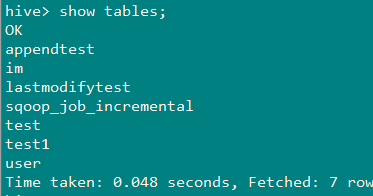
sqoop create-hive-table \

--connect jdbc:mysql://192.168.200.100:3306/yang \

--username root \

--password 010209 \

--table lastModifyTest \

--hive-table lastModifyTest
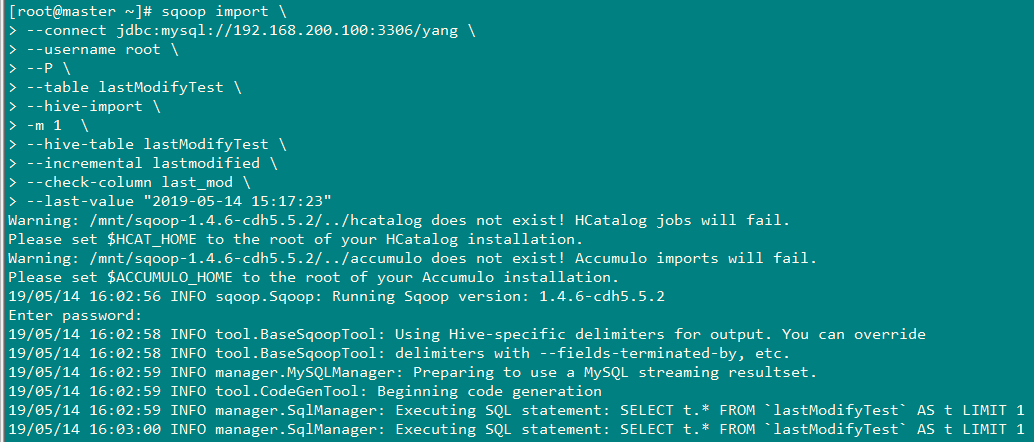
4、导入数据,将 时间以后的数据进行导入
sqoop import \

--connect jdbc:mysql://192.168.200.100:3306/yang \

--username root \

--P \

--table lastModifyTest \

--hive-import \

-m 1  \

--hive-table lastModifyTest \

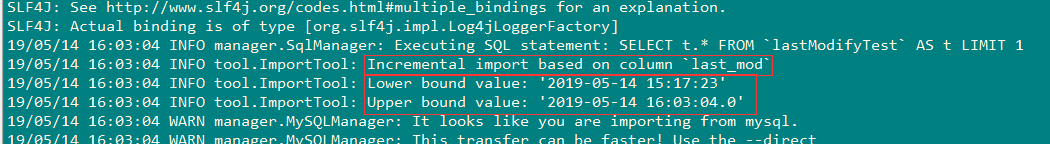
--incremental lastmodified \

--check-column last_mod \

--last-value "2019-05-14 15:17:23"
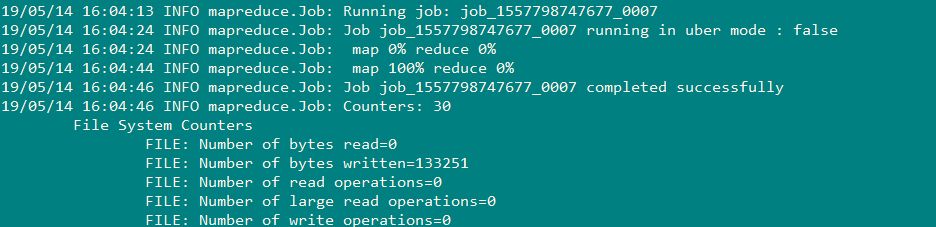
结果:
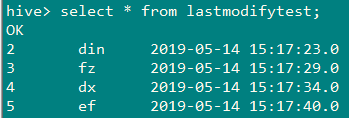
5、查看数据导入结果
6、参数说明
全量导入
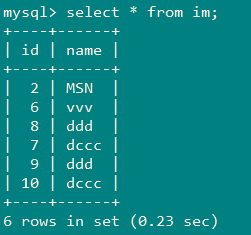
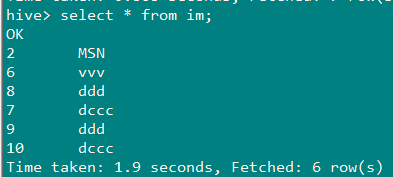
将mysql表中全部数据都导入Hive,下面来查看实例:
1、MYSQL数据
2、一次性将mysql表im数据全量导入hive中
sqoop import \

--connect jdbc:mysql://192.168.200.100:3306/yang \

--username root \

--password 010209 \

--table im \

--hive-import \

--hive-table im \

-m 1
减量导入
设置where条件,通过判断条件可以判断减少的数据和增加的数据,控制更加灵活。
sqoop import \

--connect jdbc:mysql://192.168.200.100:3306/yang \

--username root \

--P \

--table appendTest \

--hive-import \

-m 1  \

--incremental append \

--where "age>30"

--check-column id \

--last-value 0
Sqoop(四)增量导入、全量导入、减量导入的更多相关文章
- hbase增量和全量备份
1.星期五全量备份星期四23:59:59的数据,星期一全量备份到星期日23:59:59的数据,其他的增量备份,备份前一天00:00:00 - 23:59:59的数据 * * /opt/prodfu ...
- solr-DIH:dataimport增量全量创建索引
索引创建完毕,就要考虑怎么定时的去重建, 除了写solrj,可以定时调用下面两条url进行增量或者全量创建索引 全量:http://ip:port/webapp_name/core_name/da ...
- mysql的全量备份与增量备份
mysql的全量备份与增量备份 全量备份:可以使用mysqldump直接备份整个库或者是备份其中某一个库或者一个库中的某个表. 备份所有数据库:[root@my ~]# mysqldump -uroo ...
- Logstash学习之路(四)使用Logstash将mysql数据导入elasticsearch(单表同步、多表同步、全量同步、增量同步)
一.使用Logstash将mysql数据导入elasticsearch 1.在mysql中准备数据: mysql> show tables; +----------------+ | Table ...
- hadoop项目实战--ETL--(三)实现mysql表到HIVE表的全量导入与增量导入
一 在HIVE中创建ETL数据库 ->create database etl; 二 在工程目录下新建MysqlToHive.py 和conf文件夹 在conf文件夹下新建如下文件,最后的工程目录 ...
- sqoop1.4.6 全量导入与增量导入 与使用技巧
全量导入: sqoop import --connect jdbc:mysql://192.168.0.144:3306/db_blog --username root --password 1234 ...
- 10.Solr4.10.3数据导入(DIH全量增量同步Mysql数据)
转载请出自出处:http://www.cnblogs.com/hd3013779515/ 1.创建MySQL数据 create database solr; use solr; DROP TABLE ...
- MySQL5.7.18 备份、Mysqldump,mysqlpump,xtrabackup,innobackupex 全量,增量备份,数据导入导出
粗略介绍冷备,热备,温暖,及Mysqldump,mysqlpump,xtrabackup,innobackupex 全量,增量备份 --备份的目的 灾难恢复:意外情况下(如服务器宕机.磁盘损坏等)对损 ...
- sqoop定时增量导入导出
sqoop定时增量导入 2013-11-06 14:23 4553人阅读 评论(0) 收藏 举报 sqoop使用hsql来存储job信息,开启metastor service将job信息共享,所有no ...
随机推荐
- 2016 piapiapia 数组绕过
0x00.感悟 写完这道题,我感觉到了扫源码的重要性.暑假复现的那些CVE,有的就是任意文件读取,有的是任意命令执行,这些应该都是通过代码审计,得到的漏洞.也就和我们的CTF差不多了. ...
- shell 编程 && bash 简介(shell 变量、shell操作环境、数据流重导向、管线命令、shell script)
如何学习一门编程语言 数据类型 运算符 关键字 1 认识BASH 这个shell linux是操作系统核心,用户通过shell与核心进行沟通,达到我们想要的目的.硬件.核心.用户之间的关系: 原理:所 ...
- css3(::before)伪元素的使用
1 <!DOCTYPE html> 2 <html lang="en"> 3 4 <head> 5 <meta charset=" ...
- 基于Fisco-Bcos的区块链智能合约-业务数据上链SDK实现
合约的编写 基于springboot : https://github.com/FISCO-BCOS/spring-boot-starter pragma solidity ^0.4.24; cont ...
- 六、Zookeeper-开源客户端ZkClient与Curator
ZkClient 从创建会话.创建节点.读取数据.更新数据.删除节点拉介绍ZkClient 添加依赖: pom.xml <dependency> <groupId>com.10 ...
- EM 算法-对鸢尾花数据进行聚类
公号:码农充电站pro 主页:https://codeshellme.github.io 之前介绍过K 均值算法,它是一种聚类算法.今天介绍EM 算法,它也是聚类算法,但比K 均值算法更加灵活强大. ...
- postgresql修改postgres用户密码
[postgres@pg01 ~]$ psql -Upostgres -dpostgres postgres=# alter user postgres with password 'postgres ...
- ADF 第五篇:转换数据
映射数据流(Mapping Data Flow)的核心功能是转换数据,数据流的结构分为Source.转换和Sink(也就是Destination),这种结构非常类似于SSIS的数据流. 在数据流中,数 ...
- css 14-CSS3属性详解:Web字体
14-CSS3属性详解:Web字体 #前言 开发人员可以为自已的网页指定特殊的字体(将指定字体提前下载到站点中),无需考虑用户电脑上是否安装了此特殊字体.从此,把特殊字体处理成图片的方式便成为了过去. ...
- Python高级语法-私有属性-魔法属性(4.7.2)
@ 目录 1.说明 2.代码 关于作者 1.说明 常用的一些魔法方法如下 所谓魔法方法,就是调用的时候 不好好正常调用 2.代码 class Test: """ 我是__ ...