
mysql关于group by的用法
原文:https://blog.csdn.net/u014717572/article/details/80687042
先来看下表1,表名为test:
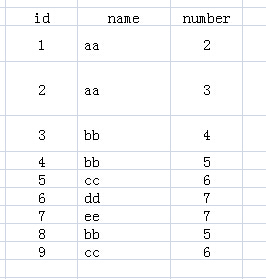
表1
执行如下SQL语句:
SELECT name FROM test
GROUP BY name你应该很容易知道运行的结果,没错,就是下表2:
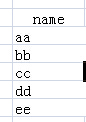
表2
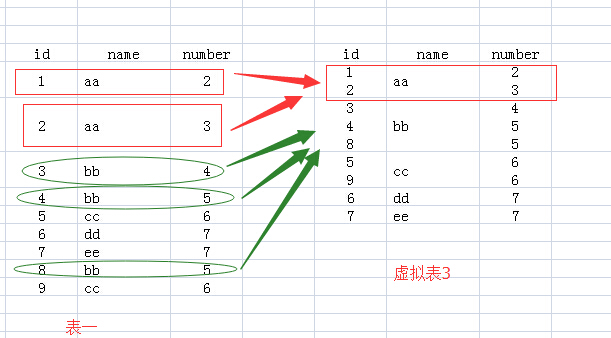
可是为了能够更好的理解“group by”多个列“和”聚合函数“的应用,我建议在思考的过程中,由表1到表2的过程中,增加一个虚构的中间表:虚拟表3。下面说说如何来思考上面SQL语句执行情况:
1.FROM test:该句执行后,应该结果和表1一样,就是原来的表。
2.FROM test Group BY name:该句执行后,我们想象生成了虚拟表3,如下所图所示,生成过程是这样的:group by name,那么找name那一列,具有相同name值的行,合并成一行,如对于name值为aa的,那么<1 aa 2>与<2 aa 3>两行合并成1行,所有的id值和number值写到一个单元格里面。
3.接下来就要针对虚拟表3执行Select语句了:
(1)如果执行select *的话,那么返回的结果应该是虚拟表3,可是id和number中有的单元格里面的内容是多个值的,而关系数据库就是基于关系的,单元格中是不允许有多个值的,所以你看,执行select * 语句就报错了。
(2)我们再看name列,每个单元格只有一个数据,所以我们select name的话,就没有问题了。为什么name列每个单元格只有一个值呢,因为我们就是用name列来group by的。
(3)那么对于id和number里面的单元格有多个数据的情况怎么办呢?答案就是用聚合函数,聚合函数就用来输入多个数据,输出一个数据的。如cout(id),sum(number),而每个聚合函数的输入就是每一个多数据的单元格。
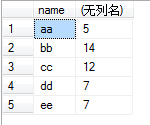
(4)例如我们执行select name,sum(number) from test group by name,那么sum就对虚拟表3的number列的每个单元格进行sum操作,例如对name为aa的那一行的number列执行sum操作,即2+3,返回5,最后执行结果如下:
(5)group by 多个字段该怎么理解呢:如group by name,number,我们可以把name和number 看成一个整体字段,以他们整体来进行分组的。如下图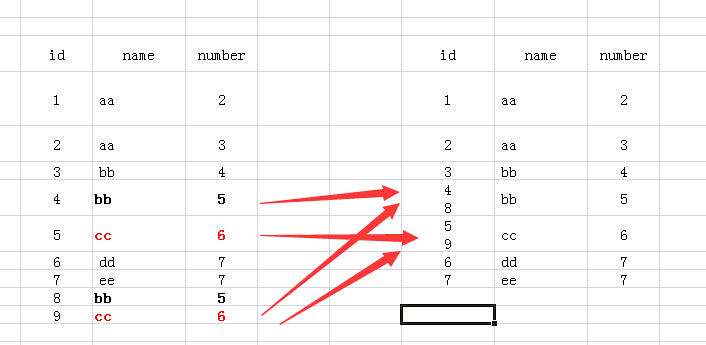
(6)接下来就可以配合select和聚合函数进行操作了。如执行select name,sum(id) from test group by name,number,结果如下图:
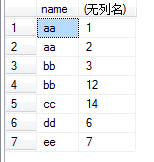
至此,我已经对我自己对如此简单的问题有如此天马行空的想法所折服,洗洗睡觉。
mysql关于group by的用法的更多相关文章
- mysql中group by 的用法解析
1. group by的常规用法 group by的常规用法是配合聚合函数,利用分组信息进行统计,常见的是配合max等聚合函数筛选数据后分析,以及配合having进行筛选后过滤. 假设现有数据库表如下 ...
- mysql笔记--group by,limit用法
table: id tag status a b c d 一.group by用法 .与count 联合计数 select status,count(*) from table group by st ...
- mysql中INSTR函数的用法
mysql中INSTR函数的用法 INSTR(字段名, 字符串) 这个函数返回字符串在某一个字段的内容中的位置, 没有找到字符串返回0,否则返回位置(从1开始) SELECT * FROM tblTo ...
- 带你了解数据库中group by的用法
前言 本章主要介绍数据库中group by的用法,也是我们在使用数据库时非常基础的一个知识点.并且也会涉及Join的使用,关于Join的用法,可以看我写的上一篇文章:带你了解数据库中JOIN的用法如有 ...
- mysql sum() 求和函数的用法
查询在record表中 name=? 的 money 加起来的值使用聚和函数 sum() 求和select sum(money) from record t where t.name = ?另外:co ...
- SQL中group by的用法
group by即按照给定字段对结果集进行分组,从字面意义上理解就是根据"by"指定的规则对数据进行分组,所谓的分组就是将一个"数据集"划分成若干个" ...
- 总结 group by 的用法
今天用实例总结一下group by的用法. 归纳一下:group by:ALL ,Cube,RollUP,Compute,Compute by 创建数据脚本 Create Table SalesInf ...
- 转:深入研究mysql中group by与order by取分类最新时间内容
鉴于项目的需要,就从网上找到该文章,文章分析得很详细也很易懂,在android里, (不知道是不是现在水平的限制,总之我还没找到在用ContentProvider时可以使用子查询),主要方法是用SQL ...
- MySQL优化GROUP BY-松散索引扫描与紧凑索引扫描
满足GROUP BY子句的最一般的方法是扫描整个表并创建一个新的临时表,表中每个组的所有行应为连续的,然后使用该临时表来找到组并应用累积函数(如果有).在某些情况中,MySQL能够做得更好,即通过索引 ...
随机推荐
- MySQL高可用篇之MHA集群
1 准备工作 1.1 修改主机名 vim /etc/hosts # 添加对应主机 192.168.28.128 mha1 192.168.28.131 mha2 192.168.28.132 mha3 ...
- 在Cent OS云服务器上部署基于TP5后端代码踩坑记录_艾孜尔江撰
推荐使用镜像安装Cent OS系统,或者在纯净安装完成之后在完成Apache+MySQL+PHP的时候不要每个单独安装,因为这样会出一些三者之间版本不配的问题,网上各种说法都有,查起来也非常困难,版本 ...
- 如何基于 echarts 在柱状图或条形图上实现转换率?(有想法吗?)
目录 需求 探索一 探索二 探索三 转换实践思路1 转换实践思路2 其他思路 探索四(揭晓答案) 答案篇说明 backgroundColor 用法 双柱合一 始终在轴的中间 百分在变,但是距离轴的距离 ...
- 01 . HAProxy原理使用和配置
HaProxy简介 HaProxy是什么? HAProxy是一个免费的负载均衡软件,可以运行于大部分主流的Linux操作系统上. HAProxy提供了L4(TCP)和L7(HTTP)两种负载均衡能力, ...
- 05 . Nginx的反向代理与负载均衡
Nginx负载均衡 客户端的访问都被代理到后端的一台服务器上,最终会出现性能瓶颈,从而导致效率降低,前端用户的访问速度急速下降,要解决这个问题就需要添加多台httpd,同时承受大量并发连接,每台服务器 ...
- data类型的url
所谓"data"类型的Url格式,是在RFC2397中 提出的,目的对于一些"小"的数据,可以在网页中直接嵌入,而不是从外部文件载入.例如对于img这个Ta ...
- [Python3]为什么map比for循环快
实验结论 如果需要在循环结束后获得结果,推荐列表解析: 如果不需要结果,直接使用for循环, 列表解析可以备选; 除了追求代码优雅和特定规定情境,不建议使用map 如果不需要返回结果 这里有三个pro ...
- oracle11g数据库导入、导出操作
一.在linux系统中导入数据库. 1.linux中先输入 su - oracle下切换到oracle用户.然后以sysdba打开sqlplus:sqlplus / as sysdba 然后创建表空间 ...
- Java实现 LeetCode 785 判断二分图(分析题)
785. 判断二分图 给定一个无向图graph,当这个图为二分图时返回true. 如果我们能将一个图的节点集合分割成两个独立的子集A和B,并使图中的每一条边的两个节点一个来自A集合,一个来自B集合,我 ...
- Java实现 蓝桥杯 算法训练 Pollution Solution
试题 算法训练 Pollution Solution 问题描述 作为水污染管理部门的一名雇员,你需要监控那些被有意无意倒入河流.湖泊和海洋的污染物.你的其中一项工作就是估计污染物对不同的水生态系统(珊 ...