
潭州课堂25班:Ph201805201 爬虫高级 第五课 sclapy 框架 日志和 settings 配置 模拟登录(课堂笔记)


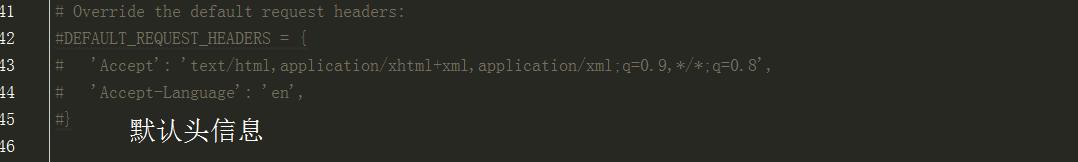
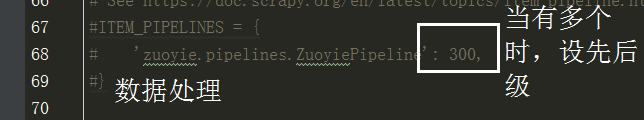
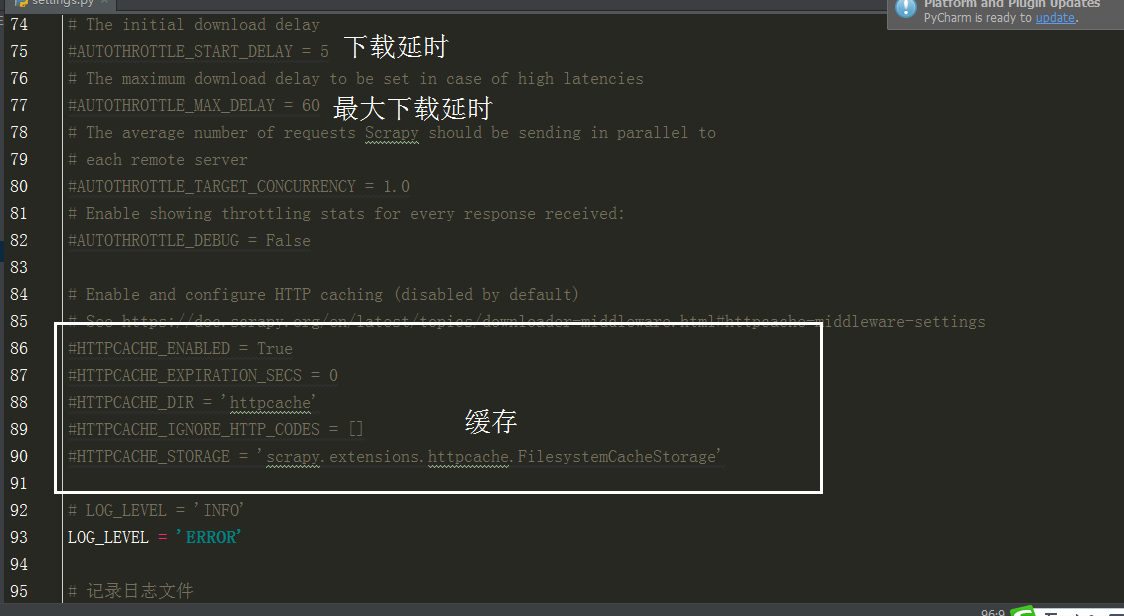
当要对一个页面进行多次请求时,
设 dont_filter = True 忽略去重
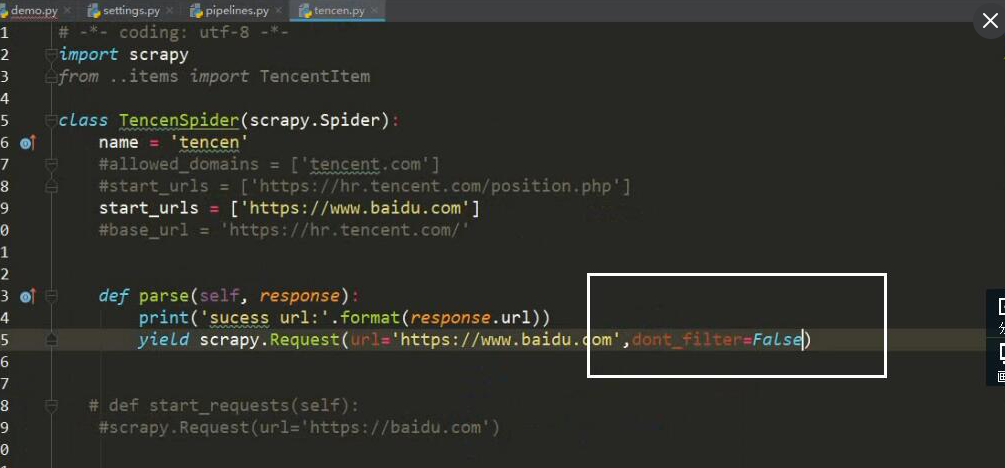
在 scrapy 框架中模拟登录
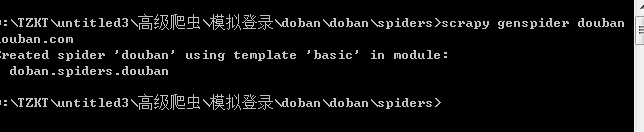
创建项目

创建运行文件
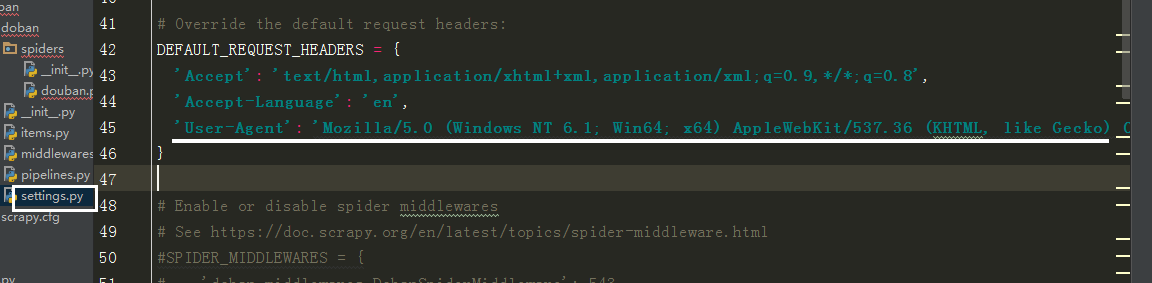
设请求头
# -*- coding: utf-8 -*-

import scrapy

import requests

class DoubanSpider(scrapy.Spider):

    name = 'douban'

    # allowed_domains = ['douban.com']

    # 登录页面

    start_urls = ['https://accounts.douban.com/login']

    log_url = 'https://accounts.douban.com/login'

    c_g_url = 'https://www.douban.com/'

    def parse(self, response):

        # 如果出现验证码

        # 验证码

        captcha_url = response.xpath('//img[@id="captcha_image"]/@src').extract_first()

        #  如果没有验证码

        if not captcha_url:

            print('没有验证码')

            data = {

                'source': 'index_nav',

                'redir':'https://www.douban.com/people/184159212/',

                'form_email': '13605938437',

                'form_password': '17906808lmlmlm',

                'login':'登录'

            }

        else:

            print('出现验证码')

            captcha_id = response.xpath('//input[@name="captcha-id"]/@value').extract_first()

            # 下载图片验证码

            with open('1.jpg','wb')as f:

                f.write(requests.get(captcha_url).content)

            captcha_solution = input('>>>>>')

            data = {

                'source': 'None',

                'redir':'https://www.douban.com/',

                'captcha-solution':captcha_solution,

                'captcha-id':captcha_id,

                'form_email': '账号',

                'form_password': '密码',

                'login':'登录'

            }

        # 返回url , 参数 , 回调函数

        yield scrapy.FormRequest(url=self.log_url,formdata=data,callback=self.login_after)

    def login_after(self,response):

        # 判断是否登录成功

        text ={

                'ck': '7nL_',

                'comment':' 哈哈....哈哈....哈哈....'

            }

        name = response.xpath('//*[@id="db-global-nav"]/div/div[1]/ul/li[2]/a/span[1]//text()').extract()

        if name:

            print('登录成功,当前用户是%s'%name)

            yield scrapy.FormRequest(url=self.c_g_url,formdata=text)

        else:print('登录失败')
潭州课堂25班:Ph201805201 爬虫高级 第五课 sclapy 框架 日志和 settings 配置 模拟登录(课堂笔记)的更多相关文章
- 潭州课堂25班:Ph201805201 爬虫高级 第七课 sclapy 框架 爬前程网 (课堂笔)
定时对该网页数据采集,所以每次只爬第一个页面就可以, 创建工程 scrapy startproject qianchen 创建运行文件 cd qianchenscrapy genspider qian ...
- 潭州课堂25班:Ph201805201 爬虫高级 第六课 sclapy 框架 中间建 与selenium对接 (课堂笔记)
因为每次请求得到的响应不一定是正常的, 也可以在中间建中与个类的方法,自动更换头自信,代理Ip, 在设置文件中添加头信息列表, 在中间建中导入刚刚的列表,和随机函数 class UserAgent ...
- 潭州课堂25班:Ph201805201 爬虫高级 第四课 sclapy 框架 crawispider类 (课堂笔记)
以上内容以 spider 类 获取 start_urls 里面的网页 在这里平时只写一个,是个入口,之后 通过 xpath 生成 url,继续请求, crawispider 中 多了个 rules ...
- 潭州课堂25班:Ph201805201 爬虫高级 第三课 sclapy 框架 腾讯 招聘案例 (课堂笔记)
到指定目录下,创建个项目 进到 spiders 目录 创建执行文件,并命名 运行调试 执行代码,: # -*- coding: utf-8 -*- import scrapy from ..items ...
- 潭州课堂25班:Ph201805201 爬虫高级 第十三 课 代理池爬虫检测部分 (课堂笔记)
1,通过爬虫获取代理 ip ,要从多个网站获取,每个网站的前几页2,获取到代理后,开进程,一个继续解析,一个检测代理是否有用 ,引入队列数据共享3,Queue 中存放的是所有的代理,我们要分离出可用的 ...
- 潭州课堂25班:Ph201805201 爬虫高级 第十一课 Scrapy-redis分布 项目实战 (课堂笔
- 潭州课堂25班:Ph201805201 爬虫高级 第十课 Scrapy-redis分布 (课堂笔记)
利用 redis 数据库,做 request 队列,去重,多台数据共享, scrapy 调度 基于文件每户,默认只能在单机运行, scrapy-redis 默认把数据放到 redis 中,实现数据共享 ...
- 潭州课堂25班:Ph201805201 爬虫高级 第八课 AP抓包 SCRAPY 的图片处理 (课堂笔记)
装好模拟器设置代理到 Fiddler 中, 代理 IP 是本机 IP, 端口是 8888, 抓包 APP斗鱼 用 format 设置翻页
- 潭州课堂25班:Ph201805201 爬虫基础 第五课 (案例) 豆瓣分析 (课堂笔记)
动态讲求 , 翻页参数: # -*- coding: utf-8 -*- # 斌彬电脑 # @Time : 2018/9/1 0001 3:44 import requests,json class ...
随机推荐
- MR数据生成工具指向目录
mrDataTidy_SaveTwoDays.jar 原始路径 :D:\太原MR数据\一天数据整理 目标路径 : D:\MR现场数据整理\保存两天_整理后数据 例如 当前时间:2017-5-17 10 ...
- 笔记软件 notion
笔记软件 notion : https://www.notion.so 注册:zengxinle@126.com 团队:Hopesun
- Windows Mac地址伪装步骤
本文介绍Windows上Mac地址修改方法,适用于网络环境绑定了Mac地址需要修改上网的情况. 工具/原料 PC电脑一台 Windows系统 方法/步骤 点击右下角图标. 点击打开网络和共享中心. 点 ...
- LeetCode(48):旋转图像
Medium! 题目描述: 给定一个 n × n 的二维矩阵表示一个图像. 将图像顺时针旋转 90 度. 说明: 你必须在原地旋转图像,这意味着你需要直接修改输入的二维矩阵.请不要使用另一个矩阵来旋转 ...
- PHP实现字符串转义和还原
首先大家可以简单了解下什么是转义字符?有什么用? 转义字符是一种特殊的字符常量.转义字符以反斜线"\"开头,后跟一个或几个字符.转义字符具有特定的含义,不同于字符原有的意义,故称“ ...
- cf789c
主要是线性时间内求最大连续和 #include<bits/stdc++.h> using namespace std; #define maxn 200005 #define ll lon ...
- poj3349 散列表(hash)
就是散列表的应用,把每片哈希值相同的雪花排到一条链上去即可,每片雪花x的哈希值 hash(x)=sum(x的六角)+mul(x的六角),会爆int #include<iostream> # ...
- poj1177 矩形周长并
线段树扫描线的模板题,一个月前写的发现忘了一些还是要看看以前的博客呀! /* 思路:数据小不用离散化处理,线段树叶子结点维护一个区间 */ #include<iostream> #incl ...
- SPLAY,LCT学习笔记(五)
这一篇重点探讨LCT的应用 例:bzoj 2631 tree2(国家集训队) LCT模板操作之一,利用SPLAY可以进行区间操作这一性质对维护懒惰标记,注意标记下传顺序和如何下传 #include & ...
- git push origin master出错:error: failed to push some refs to
1.输入git push origin master 出错:error: failed to push some refs to 那是因为本地没有update到最新版本的项目(git上有README. ...