
潭州课堂25班:Ph201805201 爬虫高级 第十课 Scrapy-redis分布 (课堂笔记)
利用 redis 数据库,做 request 队列,去重,多台数据共享,
scrapy 调度 基于文件每户,默认只能在单机运行,
scrapy-redis 默认把数据放到 redis 中,实现数据共享,
安装: pip install scrapy-redis
命令与 scrapy 没有不同
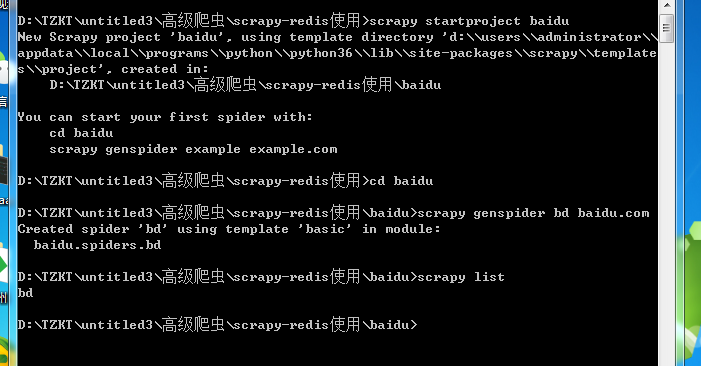
在该文件下导入 scrapy_redis

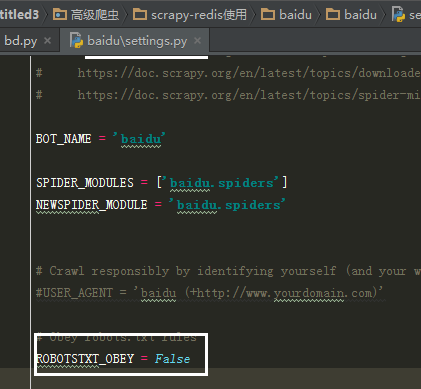
在配置文件中添加内容
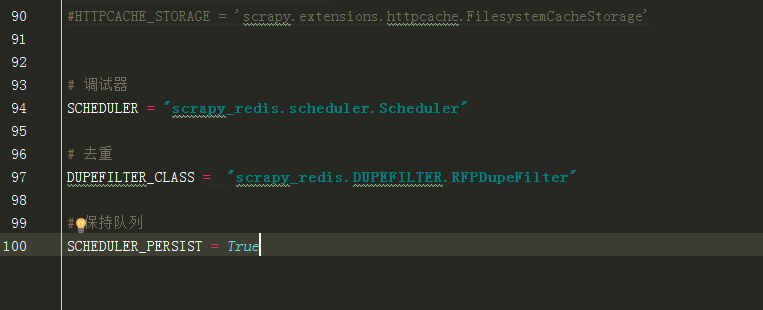
1(必须). 使用了scrapy_redis的去重组件,在redis数据库里做去重
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"
2(必须). 使用了scrapy_redis的调度器,在redis里分配请求
SCHEDULER = "scrapy_redis.scheduler.Scheduler"
3(可选). 在redis中保持scrapy-redis用到的各个队列,从而True允许暂停和暂停后恢复,也就是不清理redis queues
SCHEDULER_PERSIST = True
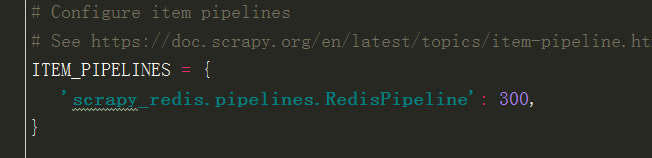
4(必须). 通过配置RedisPipeline将item写入key为 spider.name : items 的redis的list中,供后面的分布式处理item
这个已经由 scrapy-redis 实现,不需要我们写代码,直接使用即可
ITEM_PIPELINES = {
'scrapy_redis.pipelines.RedisPipeline': 100
}
5(必须). 指定redis数据库的连接参数
REDIS_HOST = '127.0.0.1'
REDIS_PORT = 6379
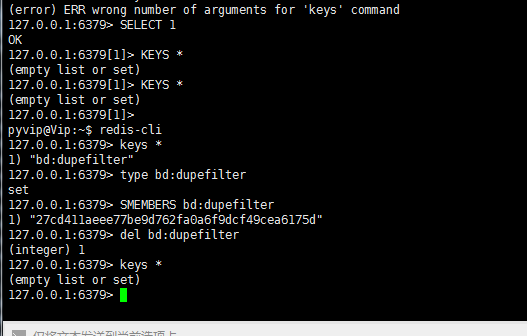
这里要改下

改成

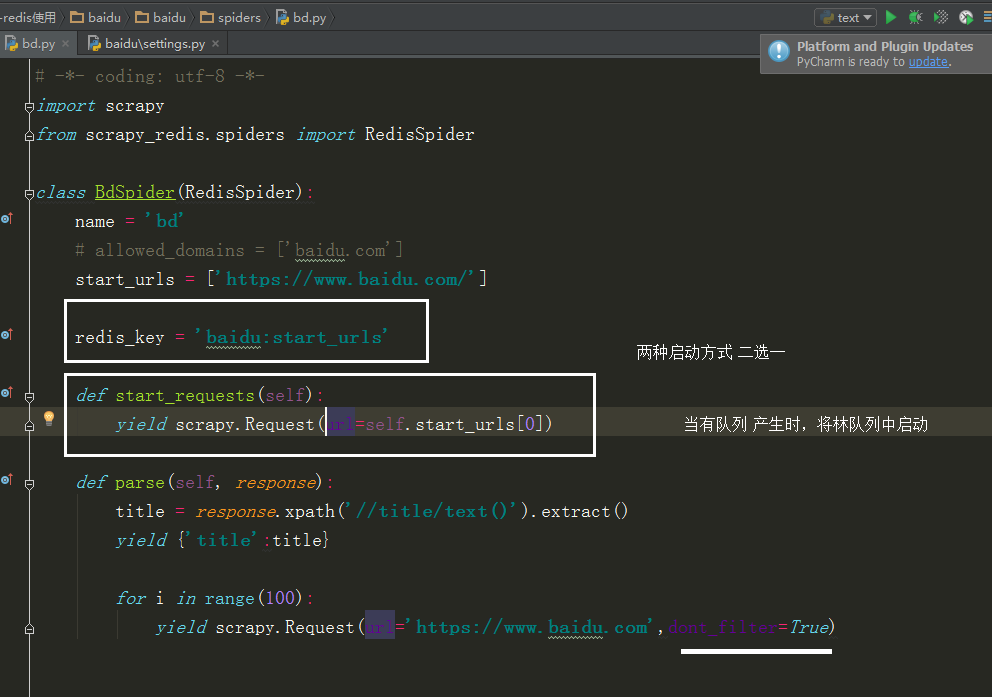
当选择 redis_key 启动时,会从 redis 中获取 url
所以在 redis 中用到下面这个命令,才会启动

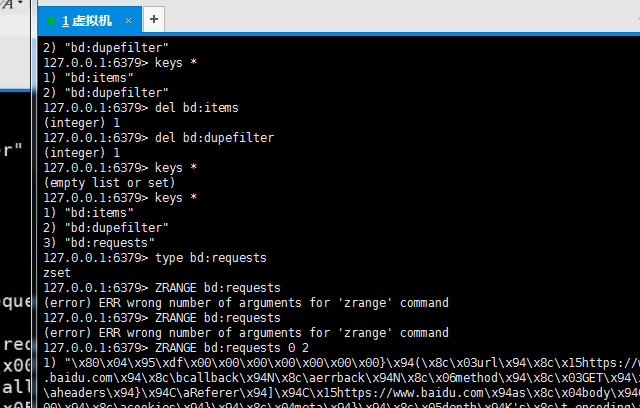
redis 中查队列

潭州课堂25班:Ph201805201 爬虫高级 第十课 Scrapy-redis分布 (课堂笔记)的更多相关文章
- 潭州课堂25班:Ph201805201 爬虫高级 第十三 课 代理池爬虫检测部分 (课堂笔记)
1,通过爬虫获取代理 ip ,要从多个网站获取,每个网站的前几页2,获取到代理后,开进程,一个继续解析,一个检测代理是否有用 ,引入队列数据共享3,Queue 中存放的是所有的代理,我们要分离出可用的 ...
- 潭州课堂25班:Ph201805201 爬虫高级 第十二 课 Scrapy-redis分布 项目实战 (课堂笔记)
建代理池, 1,获取多个网站的免费代理IP, 2,对免费代理进行检测,>>>>>携带IP进行请求, 3,检测到的可用IP进行存储, 4,实现api接口,方便调用, 5,各 ...
- 潭州课堂25班:Ph201805201 爬虫高级 第十一课 Scrapy-redis分布 项目实战 (课堂笔
- 潭州课堂25班:Ph201805201 爬虫高级 第八课 AP抓包 SCRAPY 的图片处理 (课堂笔记)
装好模拟器设置代理到 Fiddler 中, 代理 IP 是本机 IP, 端口是 8888, 抓包 APP斗鱼 用 format 设置翻页
- 潭州课堂25班:Ph201805201 爬虫高级 第七课 sclapy 框架 爬前程网 (课堂笔)
定时对该网页数据采集,所以每次只爬第一个页面就可以, 创建工程 scrapy startproject qianchen 创建运行文件 cd qianchenscrapy genspider qian ...
- 潭州课堂25班:Ph201805201 爬虫高级 第六课 sclapy 框架 中间建 与selenium对接 (课堂笔记)
因为每次请求得到的响应不一定是正常的, 也可以在中间建中与个类的方法,自动更换头自信,代理Ip, 在设置文件中添加头信息列表, 在中间建中导入刚刚的列表,和随机函数 class UserAgent ...
- 潭州课堂25班:Ph201805201 爬虫高级 第五课 sclapy 框架 日志和 settings 配置 模拟登录(课堂笔记)
当要对一个页面进行多次请求时, 设 dont_filter = True 忽略去重 在 scrapy 框架中模拟登录 创建项目 创建运行文件 设请求头 # -*- coding: utf-8 ...
- 潭州课堂25班:Ph201805201 爬虫高级 第四课 sclapy 框架 crawispider类 (课堂笔记)
以上内容以 spider 类 获取 start_urls 里面的网页 在这里平时只写一个,是个入口,之后 通过 xpath 生成 url,继续请求, crawispider 中 多了个 rules ...
- 潭州课堂25班:Ph201805201 爬虫高级 第三课 sclapy 框架 腾讯 招聘案例 (课堂笔记)
到指定目录下,创建个项目 进到 spiders 目录 创建执行文件,并命名 运行调试 执行代码,: # -*- coding: utf-8 -*- import scrapy from ..items ...
随机推荐
- C++ Primer 笔记——类
1.定义在类内部的函数是隐式的inline函数. 2.因为this的目的总是指向“这个”对象,所以this是一个常量指针,我们不允许改变this中保存的地址. 3.常量成员函数:允许把const关键字 ...
- Moco使用简单指导
下载地址 需要java运行环境支持.下载jar包:moco-runner-<version>-standalone.jar 配置文件 下面是参考: 配置 Moco的配置文件格式使用的是js ...
- hexo+github page +markdown问题汇总
1.没有权限提交 解决办法:把git版本由2.x改为1.9 未完待续
- GreenDao3.2的简单使用
Android -- GreenDao3.2的简单使用http://www.cnblogs.com/wjtaigwh/p/6394288.html https://github.com/greenro ...
- [转] UniCode编码表
Unicode编码则是采用双字节16位来进行编号,可编65536字符,基本上包含了世界上所有的语言字符,它也就成为了全世界一种通用的编码,而且用十六进制4位表示一个编码,非常简结直观,为大多数开发者所 ...
- .NET轻量级任务管理类
概述 最近做项目总是遇到服务跑批等需求,一直想写个任务管理的DLL,现在整理了一下思路,编写了一个DLL类库,使用方便.只要调用的子类继承服务基类便可以实现任务的整体调度.先看看页面效果: 使用方式 ...
- sublime3 破解
—– BEGIN LICENSE —–TwitterInc200 User LicenseEA7E-8900071D77F72E 390CDD93 4DCBA022 FAF6079061AA12C0 ...
- 【loj6029】「雅礼集训 2017 Day1」市场&&【uoj#228】基础数据结构练习题
题解: 这两道题加上区间取min max应该算线段树几道比较不寻常的题目 其实也是挺好理解的 对于区间/d 显然在log次后就会等于0 而我们注意到如果区间中数都相等那么就可以一起除 也就是说每个区间 ...
- 【CF809D】Hitchhiking in the Baltic States
题意: 给你n个区间[li,ri],让你选出从中一个子序列,然后在子序列的每个区间里都选择一个tj,满足t1<t2<...<tlent1<t2<...<tlen.最 ...
- Busybox制作ARM(iTOP4412) 根文件系统
本记录来源与自身操作过程. 1.制作环境 PC环境:外部Winows8.1 内部则为vmware11+ubuntu12.04 嵌入式设备:iTOP4412 交叉工具:arm-none-linux-gn ...